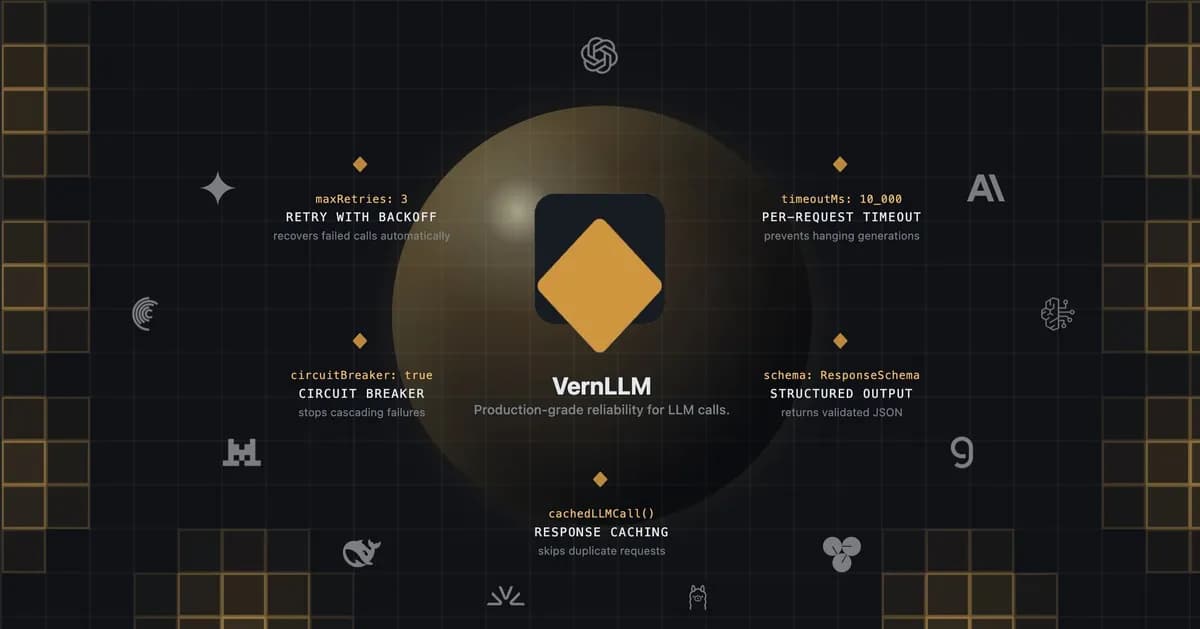
اگر امروز یک برنامه هوش مصنوعی را فقط با ارسال پرامپت و دریافت پاسخ ساختهاید، احتمالاً در اولین مواجهه با ترافیک واقعی، شاهد فروپاشی سیستم خواهید بود. تفاوت میان یک نمونه اولیه (Prototype) که در محیط توسعه عالی کار میکند و یک سیستم مقیاسپذیر، در لایهای از مدیریت خطاها نهفته است که اکثر توسعهدهندگان نادیده میگیرند. بسیاری از توسعهدهندگان اولین برنامه خود را با یک رویکرد ساده میسازند: ارسال یک پرامپت و دریافت یک پاسخ. اما این روش زمانی که سرویسدهندگان از دسترس خارج میشوند، درخواستها در زمان انتظار (Timeout) میمانند یا مدلها خروجیهای JSON ناقص میفرستند، کاملاً فرو میپاشد. در چنین شرایطی، کاربران ممکن است دکمه ارسال را چندین بار کلیک کنند که باعث میشود شما دو بار هزینه پرداخت کنید، در حالی که هیچکس نمیتواند دقیقاً بگوید ماه گذشته چقدر هزینه شده است.
طبق گزارشی در dev.to که در ۱۷ اوت ۲۰۲۶ منتشر شد، کتابخانه VernLLM دقیقاً برای پر کردن این شکاف طراحی شده است. این ابزار فراخوانیهای خام مدل زبانی بزرگ (LLM) — که شبیه کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را در یک لایه پایداری میپیچد تا از کرش کردن برنامه در زمان قطعی سرویسدهنده یا جهش نرخ درخواستها جلوگیری کند. این کتابخانه بهطور خاص روی فاصله میان یک نمونه اولیه فعال و یک سیستم مقیاسپذیر تمرکز دارد.
همانطور که در تحلیل قبلی ما دربارهی تلههای پنجره متنی ۴,۰۹۶ توکنی در Cloudflare OS اشاره کردیم، محدودیتهای زیرساختی — و نه فقط کیفیت مدل — تعیین میکنند که آیا یک قابلیت هوش مصنوعی در محیط واقعی زنده میماند یا خیر. تصور کنید برنامه شما شبیه یک فروشگاه پرتردد است. بدون سیستمی مثل VernLLM، قطعی یک سرویسدهنده مثل قفل شدن درِ ورودی است که تمام مشتریان را بیرون میفرستد. اما با این ابزار، شما یک در پشتی و مدیری دارید که دقیقاً میداند چه زمانی ترافیک را به مسیر جایگزین هدایت کند.
شکاف استقرار در محیط تولید
به نقل از مستندات این پروژه، سختترین بخش کار، گرفتن یک پاسخ خوب از مدل نیست؛ بلکه ساخت سیستمی است که بتوان در مقیاس بالا به آن تکیه کرد. شبکهها قطع میشوند، وابستگیها از کار میافتند و سرویسدهندگان محدودیتهای سختگیرانهای برای درخواستها، توکنها، همزمانی یا سهمیههای زمانی اعمال میکنند.
VernLLM به گونهای طراحی شده است تا توسعهدهندگان مجبور نباشند این درسهای سخت را به صورت دستی و از طریق تجربه شکست یاد بگیرند. فراخوانیهای اصلی ساده باقی میمانند، اما قابلیتهای کنترل و پایداری به صورت اختیاری (Opt-in) هستند. به این ترتیب، یک پروژه کوچک میتواند فقط از استریمینگ و خروجیهای ساختاریافته استفاده کند، در حالی که یک پلتفرم تجاری در مقیاس تولید، از تمام ۱۴ قابلیت موجود در این کتابخانه بهره میبرد.
کنترل ترافیک و پایداری
این کتابخانه برای تضمین فعال بودن سیستم (Uptime)، مکانیزمهای زیر را پیاده کرده است:
- جایگزین سرویسدهنده (Provider Fallback): تعریف اهداف پشتیبان و یک سیاست سنجیده برای اینکه کدام خطاها باعث تغییر سرویسدهنده شوند و این تغییر با چه ترتیبی رخ دهد. این یک رویکرد «امتحان کردن همه» نیست، بلکه یک تغییر مسیر استراتژیک برای بالا نگه داشتن برنامه است. این رویکرد در واقع پیادهسازی عملی از معماری Multi-Model Fallback است که برای حذف زمان توقف اپلیکیشنها طراحی شده است.
- قطعکننده مدار (Circuit Breaker): الگوهای شکست را ردیابی میکند. وقتی مشخص شود یک سرویسدهنده بهوضوح ناسالم است، برای مدتی ارسال ترافیک به آن را متوقف میکند تا سیستم تلاشهای مجدد (Retry) خود را روی یک سرویسدهنده مرده هدر ندهد.
- تلاش مجدد (Retries): نوسانات شبکه و خطاهای موقت ۵۰۰ را با استفاده از عقبنشینی نمایی (Exponential Backoff)، جیتر (Jitter - برای جلوگیری از ارسال همزمان و هماهنگ درخواستها) و آگاهی از هدر
Retry-Afterمدیریت میکند. خطاهای دائمی بهسرعت رد میشوند تا تلاشهای بیهوده صورت نگیرد. - محدودیت نرخ (Rate Limiting): به تیمها اجازه میدهد محدودیتها را از پیش تعریف کنند تا ترافیک را پیش از آنکه سرویسدهنده درخواست را رد کند، هماهنگ کنند.

بهینهسازی هزینه و عملکرد
برای مدیریت جنبههای مالی مقیاسدهی LLM، این ابزار شامل سیستمهای اندازهگیری مصرف و حافظه موقت است:
- سنجش مصرف (Usage Metering): بودجه را قبل از هر فراخوانی رزرو کرده و در صورت شکست فراخوانی، آن را بهطور خودکار بازمیگرداند. این کار از انحراف اعداد مصرف داخلی نسبت به واقعیت جلوگیری میکند. این دقت در محاسبه هزینهها در حالی اهمیت مییابد که برخی نوآوریها مانند مدل قیمتگذاری Oxlo.ai سعی دارند هزینه استنتاج را از تعداد توکنها جدا کنند تا پیشبینی مالی سادهتر شود.
- حافظه موقت (Caching): پوشش
cachedCallتضمین میکند کارهای یکسان — مانند رفرش صفحه یا پرامپتهای تکراری — دوباره اجرا نشوند که منجر به کاهش تعداد فراخوانیهای سرویسدهنده و کاهش هزینهها میشود. - ردیابی مصرف (Usage Tracking): در حالی که سنجش مصرف روی لحظه تمرکز دارد، ردیابی مصرف، تعداد توکنهای مصرف شده را از پاسخهای سرویسدهنده استخراج میکند تا برای گزارشهای هزینه، حسابداری هر کاربر و داشبوردهای صورتحساب استفاده شود.
یکپارچگی دادهها و مشاهدهپذیری
VernLLM از طریق اعتبارسنجی خروجیهای ساختاریافته با استفاده از Zod در سمت کلاینت و حالتهای JSON Schema بومی سرویسدهنده، تضمین میکند دادههای بازگشتی قابل استفاده باشند. این یعنی هر پاسخ قبل از اینکه برنامه با آن کار کند، با یک طرح (Schema) واقعی چک میشود.
همچنین از استریمینگ پشتیبانی میکند تا تکههای متن همزمان با تولید برای کاربر ارسال شوند. نکته حیاتی این است که در حالت استریمینگ، لایه پایداری از بین نمیرود؛ تلاشهای مجدد و کشینگ همچنان روی این پاسخها اعمال میشوند.
برای عیبیابی، کتابخانه یک جریان رویداد یکپارچه برای تلاشهای مجدد، تغییرات وضعیت قطعکننده مدار، زمانهای انتظار برای محدودیت نرخ و رویدادهای جایگزینی منتشر میکند. این قابلیت به تیمها اجازه میدهد به این پرسش پاسخ دهند که چرا یک درخواست کند بوده یا چرا سرویسدهنده تغییر کرده است. همچنین از یک لاگر (Logger) قابل تعویض پشتیبانی میکند تا تیمها بتوانند از خروجی کنسول، JSON ساختاریافته یا پلتفرمهای مشاهدهپذیری داخلی خود استفاده کنند.
اجرا و کنترل
در بحث استفاده از ابزار (Tool Use)، این کتابخانه تفکیک دقیقی قائل شده است. مدل فقط پیشنهاد میدهد که از چه ابزاری استفاده شود، اما این برنامه است که تصمیم میگیرد کدام ابزارها وجود دارند، آرگومانها معتبر هستند یا خیر، آیا فراخوانی مجاز است و چگونه اجرا شود. در واقع مدل پیشنهاد میدهد و برنامه تصمیم نهایی را میگیرد.
علاوه بر این، سیستم جنبههای انسانی تأخیر را مدیریت میکند:
- لغو و زمان انتظار: پشتیبانی از
AbortSignalبرای لغو درخواست، زمانهای انتظار (Timeout) برای هر تلاش و لغو آگاه از تلاش مجدد. - مدیریت خطا: استفاده از انواع ساختاریافته
LLMErrorبرای تشخیص تفاوت بین محدودیت نرخ، خطای زمان انتظار یا یک درخواست خراب، که اجازه میدهد به جای یک بلوک catch کلی، منطق شکست خاصی پیاده شود.
این تغییر معماری، تمرکز را از مهندسی پرامپت (Prompt Engineering) — که هنر سؤال درست پرسیدن است — به مهندسی سیستم منتقل میکند. هدف این است که یک فراخوانی API خام به یک قابلیت قابل اتکا تبدیل شود که در آن توسعهدهنده کنترل کامل معماری را در دست دارد.
توسعهدهندگان اکنون میتوانند با دستور npm install vern-llm از این قابلیتها استفاده کنند تا از حلقههای ساده «پرامپت-پاسخ» فراتر روند. اما پرسش حیاتی این است که این لایههای پایداری در عصر سامانههای چندعاملی (Multi-agent) که نیاز به هماهنگی دهها فراخوانی همزمان و جایگزینهای هماهنگ دارند، چگونه تکامل خواهند یافت.
گام بعدی شما
- اگر از چندین سرویسدهنده (مثل OpenAI و Anthropic) استفاده میکنید، استراتژی Fallback را برای کاهش نرخ خطای کاربر نهایی پیاده کنید.
- برای کاهش هزینههای تکراری در محیط تولید، لایه
cachedCallرا روی پرامپتهای ثابت فعال کنید. - سیستم مانیتورینگ خود را به جریان رویدادهای VernLLM متصل کنید تا نقاط شکست زیرساختی را سریعتر از کاربران شناسایی کنید.
این تنها آغاز ماجراست؛ اثر موجگونهی این رویکرد بر اکوسیستم عاملهای هوشمند را در گزارش بعدی بررسی خواهیم کرد.



گفتگو