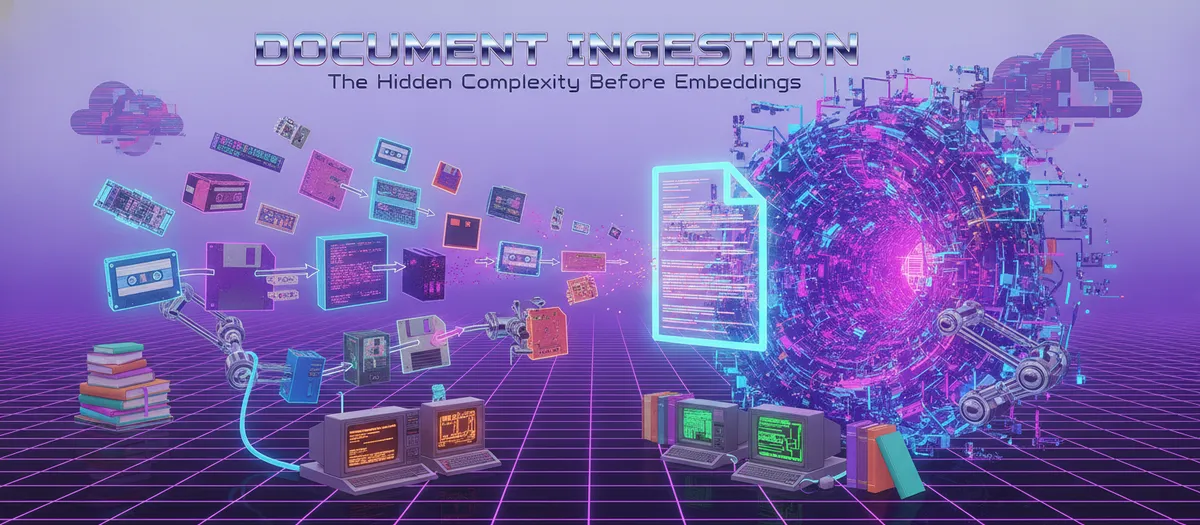
اگر امروز یک سامانه RAG میسازید که پاسخهای نامرتبط یا «سوپ متنی» تولید میکند، احتمالاً مشکل در مدل شما نیست، بلکه در دادههای ورودی است. باید بدانید که موفقیت یک سامانه تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — در ۱۵ مرحلهای رقم میخورد که پیش از رسیدن حتی یک توکن به مرحله بردارسازی رخ میدهد. مهندس نرمافزار SurajK در ۲۲ ژوئن ۲۰۲۶ چارچوبی جامع برای ورود دادهها (Document Ingestion) تشریح کرد و ثابت کرد که یک سامانه RAG در سطح تجاری، در واقع در ۱۵ گامی که قبل از بردارسازی رخ میدهد، پیروز یا شکستخورده میشود.
برای بسیاری از توسعهدهندگان، وسوسه این است که دکمه آپلود را نقطه شروع فرآیند بدانند. اما در محیطهای سازمانی، این رویکرد به شکستهای خاموشی منجر میشود که در آن سامانه بهدلیل آمادهسازی ضعیف دادهها، پاسخهای غلط میدهد. این وضعیت شبیه پختن بریانی است؛ شما نمیتوانید برنج و گوشت خام را مستقیماً در دیگ بریزید، بلکه ابتدا باید برنج را بشویید، آن را بخیسانید، گوشت را آماده کرده، مزهدار کنید و پیازها را خرد کنید. تنها پس از این مراحل است که پختوپز آغاز میشود. در RAG، این «آمادهسازی»، همان خط لوله ورود داده (Ingestion Pipeline) است.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، کیفیت خروجی مدلها همواره تابع کیفیت دادههای ورودی است. طبق گزارش SurajK، یک سامانه تجاری باید پیش از رسیدن به پایگاهداده برداری، از ۱۵ مرحله مجزا عبور کند:
۱. آپلود سند (اکشن کاربر)
۲. هشینگ فایل (شناسایی فایلهایی که قبلاً دیده شدهاند)
۳. تجزیه PDF (استخراج محتوای اصلی)
۴. استخراج متن (تبدیل PDF به رشتههای متنی قابل استفاده)
۵. پاکسازی متن (حذف زبالهها و نویزها)
۶. استخراج متادیتا (افزودن بستر برای بازیابی دقیقتر)
۷. تکهبندی (تقسیم هوشمند متن)
۸. تعیین مرز تکهها (حفظ معنای معنایی)
۹. بهینهسازی اندازه تکه (موازنه بین بستر و دقت)
۱۰. همپوشانی (حفظ تداوم بستر بین تکهها)
۱۱. هشینگ تکهها (شناسایی تغییرات خاص در بخشهای سند)
۱۲. حذف تکرار (جلوگیری از ایجاد بردارسازیهای موازی و تکراری)
۱۳. نسخهبندی (مدیریت بهروزرسانیهای اسناد)
۱۴. ورود تدریجی (جلوگیری از بردارسازی مجدد کل دادهها)
۱۵. بهینهسازی هزینه (صرفهجویی در هزینهها در مقیاس بالا)
اولین خط دفاعی، هشینگ محتوا است. طبق مستندات فنی این چارچوب، اشتباه رایج، هش کردن «نام فایل» است. تصور کنید کاربر فایلی با نام HR_Policy.pdf (نسخه ۱) را آپلود کند که در آن ذکر شده «۳۰ روز پیشازخبر دادن الزامی است» و سپس نسخه ۲ همان فایل را با نام یکسان آپلود کند که در آن نوشته شده «۷ روز پیشازخبر دادن الزامی است». اگر سیستم از هش نام فایل استفاده کند، هر دو را یکسان میبیند. در این حالت سامانه بهغلط تصور میکند فایل تغییر نکرده و بهروزرسانی را رد میکند؛ نتیجه این است که هوش مصنوعی سیاستهای قدیمی و منسوخ را پاسخ میدهد که یک فاجعه مدیریتی است.
سامانههای عملیاتی باید دادههای باینری واقعی را با الگوریتمهایی مثل SHA256 هش کنند. برای مثال، بایتهای باینری 0xAA 0xBB 0xCC ممکن است هش A7B82C1F9D3E... را تولید کنند، در حالی که 0xAA 0xBB 0xDD تولید میکند X9Z47M3Q2K1L.... با بررسی هش محتوا در برابر یک پایگاهداده (مثلاً بررسی جدول documents با محدودیت unique_file_per_tenant) پیش از پردازش، سیستمها میتوانند از کارهای تکراری جلوگیری کنند. این رویکردی است که در پیادهسازیهای پیشرفتهتر، مانند اتوماسیون بررسی سرقت ادبی در مجلات برای شناسایی دقیق محتوای تکراری به کار میرود.
این موضوع حیاتی است چون بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایه چه کلمات دیگری است — گرانترین بخش خط لوله است و جلوگیری از بردارسازی مکرر یک سند، هزینهها را کاهش میدهد. در یک پیادهسازی Node.js، این کار شامل خواندن فایل از طریق fs.readFileSync و ایجاد یک digest شش-ده-آلفانوumeric با استفاده از ماژول crypto است. یک اسکیمای تولیدی معمولی شامل فیلدهایی برای tenant_id (شناسه مشتری)، file_name (نام فایل)، file_hash (۶۴ کاراکتر برای SHA256)، file_size (حجم فایل) و status (ردیابی وضعیت از 'آپلود شده' تا 'تکمیل شده') است. همچنین سیستم میتواند تابعی به نام verifyFileIntegrity داشته باشد تا با مقایسه هش واقعی و هش مورد انتظار، اطمینان حاصل کند فایل قبل از پردازش خراب نشده است.
در مرحله تجزیه PDF، انتخاب ابزار کاملاً به پیچیدگی سند بستگی دارد. SurajK پنج سطح ابزار را معرفی میکند که هر کدام تبادلاتی (Trade-offs) در زمینه هزینه، سرعت و دقت دارند:
- pdf-parse: رایگان (۰ روپیه) و بسیار سریع است. برای متنهای ساده عالی است، اما با از دست دادن سطوح عناوین، ساختار لیستها، شکستگیهای پاراگراف و سازماندهی بخشها، «سوپ متنی» ایجاد میکند. این ابزار در دسته «سرگرمی» یا Hobby قرار میگیرد.
- PDFPlumber: ابزاری مبتنی بر پایتون با سرعت متوسط. برای استخراج جداول پایه و متن بهتر است، اما همچنان در حفظ ساختار سند محدودیت دارد.
- Unstructured: یک انتخاب صنعتی (۵۰ تا ۲۰۰ روپیه در ماه). این ابزار با بازگرداندن آرایهای از عناصر (مانند
Title،Heading،ParagraphوListItem) از طریق فراخوانیهای API با استراتژیhi_resو حفظ مختصات، ساختار سند را حفظ میکند. - LlamaParse: پیشروترین ابزار برای PDFهای پیچیده (۱۰۰ تا ۵۰۰ روپیه در ماه). این ابزار لایههای چندستونی، جداول با سلولهای ادغام شده، تصاویر متنی و اسناد اسکن شده را با استفاده از OCR پیشرفته مدیریت میکند. همچنین اجازه میدهد دستورات خاص (
parsing_instruction) برای استخراج پاورقیها و یادداشتها ارسال شود و نتایج را پس از یک دوره نظارت (Polling) در قالب Markdown تحویل میدهد. - Azure Document Intelligence: استاندارد طلایی سازمانی (۵۰۰ تا ۲۰۰۰ روپیه در ماه). ایدهآل برای فرمهای بسیار ساختاریافته، فاکتورها و اسناد بانکی با استفاده از مدلهای پیشساخته مانند
prebuilt-invoiceیاprebuilt-receiptبا OCR با دقت بالا و نقشهبرداری ساختاری.
استخراج خام متن معمولاً حاوی «زباله» است؛ مواردی مثل سربرگها و پانویسهای تکراری یا واترمارکها. برای مثال، سندی که در هر صفحه عبارت «نام شرکت صفحه ۱» و «[CONFIDENTIAL]» (محرمانه) را چاپ میکند، مشکل نویز ایجاد میکند. اگر سامانه عبارت «[CONFIDENTIAL]» را مکرراً بردارسازی کند، مدل AI ممکن است به اشتباه یاد بگیرد که هر سیاستی محرمانه است؛ در نتیجه وقتی پرسیده شود «آیا این سیاست محرمانه است؟»، صرفنظر از محتوای واقعی، همیشه پاسخ «بله» میدهد.
پاکسازی متن شامل استفاده از Regular Expressions (عبارات منظم) برای حذف موارد زیر است:
- سربرگها و پانویسها (مثلاً:
^Company Name\s+Page \d+) - علامتهای محرمانگی کلی (مثلاً:
/\[CONFIDENTIAL\]\n?/g) - مهرهای نسخه سند (مثلاً:
[Document Version: 2.3]) - شماره صفحات تکافتاده
- فضاهای خالی بیش از حد از طریق نرمالسازی (تبدیل چندین فاصله یا خط جدید به یک تکفاصله).
همزمان باید متادیتا استخراج شود. در حالی که بردارها معنای «درون» تکه (Chunk) را میگیرند، متادیتا بستر «درباره» تکه را میسازد. این کار اجازه میدهد سیستم بازیابی، جستوجوها را فیلتر کند. بدون متادیتا، پرسشی درباره «سیاست مرخصی HR» ممکن است نتایجی از تمام بخشهای شرکت برگرداند، اما با متادیتا، سیستم میتواند جستوجو را فقط به اسنادی محدود کند که با برچسب بخش «منابع انسانی» (Human Resources) علامتگذاری شدهاند.
منابع استخراج متادیتا میتوانند شامل موارد زیر باشند:
- ساختار پوشهها: مثلاً مسیر
/HR/Policies/Leave_Policy.pdfاجازه میدهد بخش «منابع انسانی» اختصاص یابد. - نام فایلها: شناسایی نسخهها از طریق الگوهایی مثل
leave_policy_v2.pdfبا استفاده از regexv(\d+). - خروجی تجزیهکننده (Parser): استفاده از عناصر تجزیه شده Unstructured برای یافتن اولین
TitleیاHeadingجهت شناسایی بخش. - طبقهبندی توسط LLM: استفاده از مدلی مانند Claude 3.5 Sonnet برای تحلیل ۵۰۰ کاراکتر اول و بازگرداندن یک شیء JSON حاوی
department(منابع انسانی|مالی|IT|حقوقی)،topic(مرخصی|حقوق|امنیت|قراردادها) وconfidentiality(عمومی|داخلی|محرمانه).
در این مرحله، دقت در تولید خروجیهای ساختاریافته حیاتی است؛ چرا که هرگونه خطای فرمتبندی در این توابع، مانند آنچه در بررسی «مالیات استدلال» و کاهش دقت مدلها در خروجیهای JSON مشاهده شد، میتواند کل خط لوله را مختل کند.
تکهبندی (Chunking) قلب این فرآیند است. تکههای بد منجر به بردارسازیهای بد و در نهایت پاسخهای غلط میشوند. نقطه بهینه (Sweet Spot) برای اندازه تکهها معمولاً ۱۰۰۰ تا ۱۵۰۰ توکن است.
- بسیار کوچک (مثلاً ۱۰۰ توکن): هوش مصنوعی بستر را از دست میدهد. اگر تکهای فقط شامل «۲۴ روز مرخصی» باشد بدون اینکه عبارت «کارمندان» در آن باشد، سیستم نمیتواند به سؤال «کارمندان چند روز مرخصی دارند؟» پاسخ دهد، چون تکه یک قطعه ناقص است.
- بسیار بزرگ (مثلاً ۵۰۰۰ توکن): سیستم نویز زیادی وارد میکند. مدل ممکن است توسط سیاستهای دیگر در همان تکه بزرگ گیج شود، منجر به هایلایت شدن بخش اشتباه گشته و سرعت پاسخدهی را کاهش دهد.
برای حفظ تداوم، از روش «پنجره لغزان» (Sliding Window) با همپوشانی (Overlap) حدود ۲۰۰ توکن استفاده میشود. این کار تضمین میکند که اگر یک تکه اطلاعات حیاتی بین دو تکه تقسیم شود، بستر آن در هر دو تکه حفظ گردد.
مکانیزمهای تکهبندی برای جلوگیری از شکست معنایی از استراتژیهای مختلفی استفاده میکنند:
- اندازه ثابت (Fixed Size): ساده اما خطرناک، زیرا معنا را در وسط جمله قطع میکند.
- مرز جملات (Sentence Boundaries): از قطع شدن وسط جمله جلوگیری میکند اما اندازهها متغیر میشوند.
- تکهبندی معنایی (Semantic Chunking): معنا را یکجا نگه میدارد اما از نظر محاسباتی گران و کند است.
- ترکیبی بازگشتی (Recursive Hybrid): یک رویکرد منعطف و هوشمند که در محیطهای عملیاتی ترجیح داده میشود.
در پیادهسازی Node.js، این کار شامل محاسبه یک charWindow (تقریباً ۴ کاراکتر برای هر توکن) و تنظیم شاخص end روی آخرین نقطه یا خط جدید مشاهده شده است، به شرطی که بخش بزرگی از پنجره پر شده باشد (مثلاً بیش از ۸۰٪). همچنین سیستم بررسی میکند که متن باقیمانده خیلی کوچک نباشد؛ اگر کمتر از ۳۰٪ یک پنجره باشد، با تکه قبلی ادغام میشود تا قطعات کوچک و بیمعنا ایجاد نشود.
فراتر از هشینگ در سطح فایل، سیستم باید هشینگ در سطح تکه را پیاده کند. وقتی سندی بهروز میشود (مثلاً به نسخه v2)، بهندرت تمام جملات تغییر میکنند. با هشینگ تکهها با SHA256، سیستم دقیقاً میفهمد کدام بخشهای سند تغییر کرده است.
این قابلیت، «ورود تدریجی» (Incremental Ingestion) را ممکن میسازد. اگر یک سند ۱۰۰۰ تکهای بهروز شود و تنها یک تکه تغییر کند (مثلاً از «۲۴ روز مرخصی» به «۳۰ روز مرخصی»)، یک سیستم هوشمند فقط همان یک تکه تغییر یافته را مجدداً بردارسازی میکند. ۹۹۹ تکه دیگر از حافظه موقت (Cache) بازخوانی میشوند. این اقدام هزینه را از ۱۰۰۰ بردارسازی به تنها یک مورد کاهش میدهد که یعنی ۹۹.۹٪ صرفهجویی در آن بهروزرسانی خاص.
مدیریت نسخهها (Versioning) با علامتگذاری نسخههای قدیمی سند به عنوان active = false در پایگاهداده و تنظیم نسخه جدید به عنوان active = true انجام میشود. هنگام بازیابی، سیستم بهطور خاص فقط اسناد فعال را از طریق یک زیرپرسوجو (Subquery) فراخوانی میکند: SELECT chunk_text FROM chunks WHERE document_id IN (SELECT id FROM documents WHERE active = true).
بهینهسازی هزینه در مقیاس بالا در یک سامانه ساده با آپلود نسخه جدید، نیاز به بردارسازی مجدد همه چیز است، اما در سامانه هوشمند، بردارسازیهای کش شده بازاستفاده میشوند. برای مثال، اگر بخش HR ۱۰۰ سیاست آپلود کند و سیاست ۳ تا ۹۹٪ شبیه سیاست ۱ باشد، سیستم ساده ۳۰۰ تکه را بردارسازی میکند (۱۵ روپیه)، در حالی که سیستم هوشمند تنها ۲۰۰ تکه را بردارسازی میکند (۱۰ روپیه). در مقیاس ۱۰۰۰ سیاست، این کار میتواند هزینههای ماهانه را از ۵۰۰ روپیه به ۱۰۰ روپیه کاهش دهد.
صرفهجوییهای بیشتر از طریق موارد زیر حاصل میشود:
- دستهبندی (Batching): گروهبندی ۱۰۰۰ بردارسازی در یک فراخوانی API بهجای ۱۰۰۰ فراخوانی جداگانه برای کاهش سربار.
- مدلسازی لایهای (Tiered Modeling): استفاده از مدلهای ارزانتر (مثل Gemini) برای متون ساده سیاستها و مدلهای گرانتر (مثل Claude) فقط برای تحلیلهای پیچیده.
- کشینگ تهاجمی (Aggressive Caching): بازاستفاده از بردارسازیها برای متونی که در چندین سند مختلف تکرار شدهاند.
- بهروزرسانیهای تدریجی: استفاده از منطق مقایسهای برای پردازش تنها «دلتا» یا تفاوتهای بین نسخههای سند.
یک شکست هزینه (Cost Breakdown) معمولی شامل هزینههای تجزیه (۰.۵۰ روپیه برای هر سند)، هزینه بردارسازی (۵۰ روپیه برای هر ۱۰۰۰ تکه)، ذخیرهسازی برداری (۱۰ روپیه برای هر گیگابایت در ماه) و طبقهبندی اختیاری توسط LLM (۱ روپیه برای هر سند) است.
کل این جریان ارکستراسیون خط لوله شامل توالی توابع کمکی زیر است:handleFileUpload $\rightarrow$ selectParser $\rightarrow$ parsePDF $\rightarrow$ cleanExtractedText $\rightarrow$ extractMetadataFromStructure $\rightarrow$ createSmartChunks $\rightarrow$ deduplicateChunks $\rightarrow$ handleDocumentVersion $\rightarrow$ incrementalIngestion.
به عنوان مثال، منطق selectParser را میتوان بر اساس حجم فایل خودکار کرد:
- کمتر از ۱ مگابایت: استفاده از
pdf-parse(برای PDFهای ساده). - بین ۱ تا ۱۰ مگابایت: استفاده از
unstructured(برای PDFهای معمولی). - بیش از ۱۰ مگابایت: استفاده از
llamaparse(برای PDFهای پیچیده).
این رویکرد سختگیرانه ۱۵ مرحلهای است که پروژههای تفننی را از سامانههای AI در سطح تجاری جدا میکند. با تمرکز بر کارهای «پیش از جستوجو»، مهندسان تضمین میکنند که پایگاهداده برداری حاوی دادههای پاک، ساختاریافته و غیرتکراری است. برای کسانی که این سیستمها را میسازند، فاز بحرانی بعدی تمرکز بر «بازیابی و رتبهبندی» است، جایی که کیفیت این تکهها راهاً از طریق جستوجوی برداری و بازرتبهبندی (Reranking) آزمایش میشود.
گام بعدی شما
- تمام اسناد فعلی خود را با یک الگوریتم هشینگ محتوا (SHA256) بازبینی کنید تا از تکرار بردارها و اتلاف هزینه جلوگیری کنید.
- استراتژی تکهبندی خود را از «اندازه ثابت» به «ترکیبی بازگشتی» تغییر دهید تا معنای جملات در مرز تکهها قطع نشود و بستر اطلاعاتی حفظ گردد.
- برای اسنادی که دارای جداول پیچیده، ستونهای متعدد یا نیاز به OCR دارند، LlamaParse یا Azure را جایگزین کتابخانههای رایگان و ساده کنید.
این دقت در ورود دادهها تنها نیمی از مسیر است؛ حالا که دادهها پاک و ساختاریافتهاند، نوبت به بهینهسازی مرحله بازیابی و بازرتبهبندی میرسد که در تحلیلهای بعدی بررسی خواهیم کرد.



گفتگو