پرش به محتوای اصلی
پرش به محتوای مقاله

راهکارهای NVIDIA برای حذف اصطکاک در مسیر تبدیل مدل‌های هوش مصنوعی به محصول

·۲۵ اردیبهشت ۱۴۰۵۳ دقیقه مطالعه
راهکارهای NVIDIA برای حذف اصطکاک در مسیر تبدیل مدل‌های هوش مصنوعی به محصول
اشتراک‌گذاری

اگر مدل هوش مصنوعی شما هفته‌ها طول می‌کشد تا از محیط آموزش به تولید برسد، در حال از دست دادن مزیت رقابتی خود هستید. باید بدانید که بسیاری از مدل‌های قدرتمند، به دلیل «اصطکاک خط لوله»، هرگز به دست کاربر نهایی نمی‌رسند.

انتقال مدل از PyTorch به سرور اغلب باعث جهش حافظه واحد پردازش گرافیکی (GPU) — موتور قدرتمندی که محاسبات سنگین را سریع انجام می‌دهد، شبیه به یک تیم بزرگ از حسابدارانی است که هم‌زمان کار می‌کنند — می‌شود. همان‌طور که در تحلیل‌های قبلی ما درباره‌ی بهینه‌سازی سخت‌افزارهای هوش مصنوعی اشاره کردیم، گلوگاه اصلی همیشه در لایه‌ی انتقال داده‌هاست. این شکاف، شبیه به ساختن یک ماشین مسابقه‌ای در آزمایشگاه است که وقتی به جاده می‌رسد، با چاله‌ها و سرعت محدود مواجه می‌شود.

NVIDIA در ۱۲ مه ۲۰۲۶ راهنمایی جامع منتشر کرد تا جلوی شکست‌های زمان اجرا و افت کیفیت پنهان در استقرار مدل‌ها را بگیرد. طبق اعلام این شرکت، راهکار اصلی در ادغام NVIDIA TensorRT و Dynamo-Triton است. برای بهینه‌سازی، موارد زیر توصیه شده است:

  • اعتبارسنجی چک‌پوینت‌ها در CI/CD
  • حذف لایه‌های Dropout در گراف‌های استنتاج
  • استفاده از پلاگین‌های C++/CUDA برای عملیات‌های پشتیبانی‌نشده
  • تعریف پروفایل‌های ورودی پویا در TensorRT
  • استفاده از کانتینرهای NVIDIA NGC برای جلوگیری از تداخل نسخه‌ها

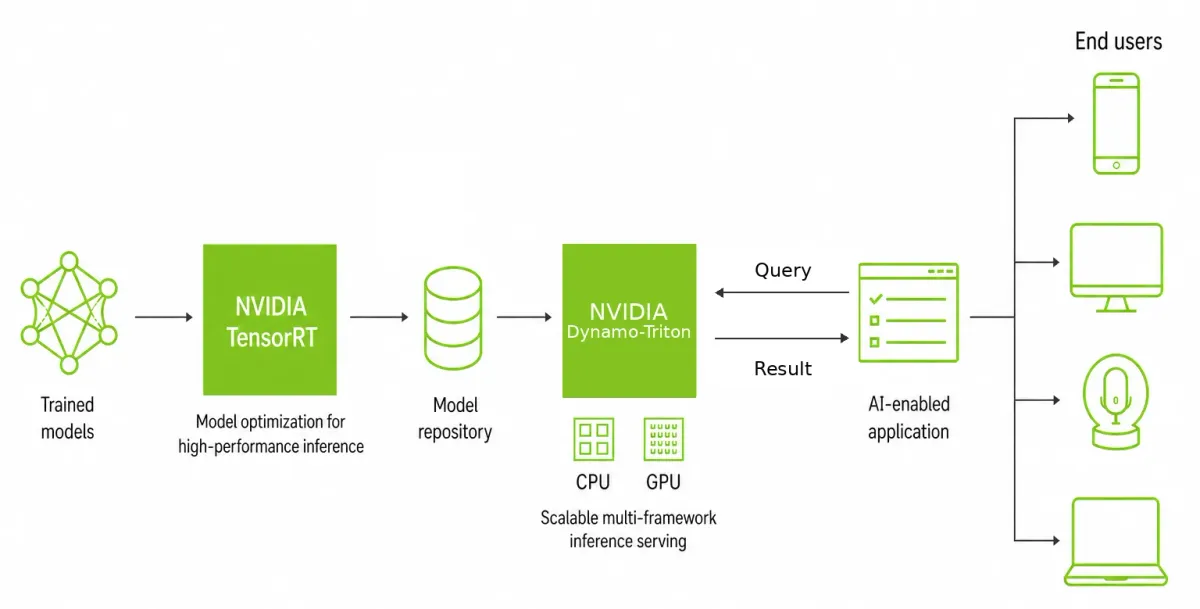
An end-to-end AI inference reference architecture. Trained models flow into NVIDIA TensorRT for model optimization for high-performance inference, are stored in a model repository, and served by Dynamo-Triton on CPU and GPU as a scalable multi-framework inference server. An AI-enabled application sends queries to Dynamo-Triton and receives results, then delivers them to end users across phone, monitor, microphone, and laptop devices.

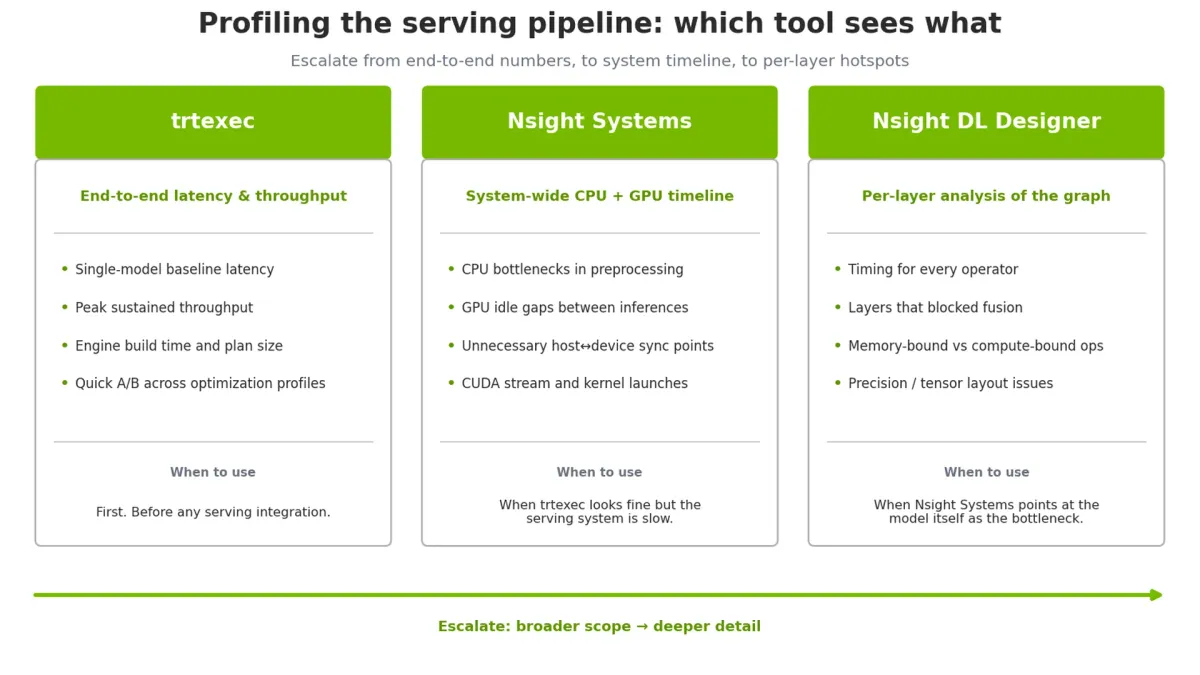
برای عیب‌یابی، استفاده از trtexec برای سنجش تأخیر، Nsight Systems برای تحلیل زمان‌بندی CPU/GPU و Nsight Deep Learning Designer برای شناسایی گلوگاه‌های لایه‌ای پیشنهاد می‌شود.

A diagram with three side-by-side text boxes comparing tools for profiling AI inference pipelines. Left to right: trtexec for end-to-end latency and throughput, Nsight Systems for system-wide CPU and GPU timelines, and Nsight Deep Learning Designer for per-layer analysis, with scope broadening.

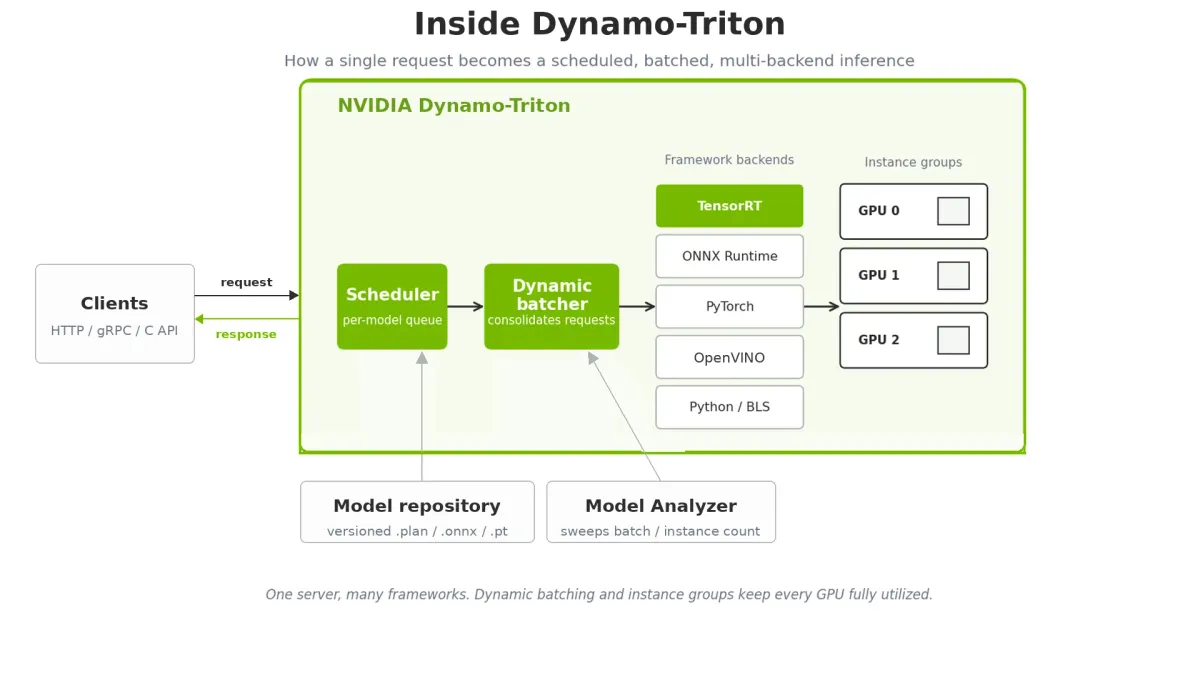
در نهایت، Dynamo-Triton بار تولید را از طریق دسته‌بندی پویا و نسخه‌بندی مدل‌ها مدیریت می‌کند تا دسترسی بالا تضمین شود.

Dynamo-Triton architecture diagram showing clients send HTTP, gRPC, or C API requests to a scheduler, which feeds a dynamic batcher dispatching to framework backends including TensorRT, ONNX Runtime, PyTorch, and Python BLS, across multiple GPU instance groups. A model repository supplies versioned artifacts and Model Analyzer supplies configuration recommendations.

این تغییر، استقرار هوش مصنوعی را از یک «هنر دستی» به یک «خط لوله مهندسی» تبدیل می‌کند. برای شما، این به معنای استنتاج (Inference) — لحظه‌ای که مدل واقعاً جواب تولید می‌کند، شبیه به خودِ آشپزی است، نه دوره‌ی آموزش آشپز — ارزان‌تر، قبض‌های ابری کمتر و پاسخ‌های سریع‌تر برای کاربران است.

گام بعدی شما

  • یک کانتینر پیش‌ساخته از کاتالوگ NGC دریافت کنید.
  • مدل‌های ONNX خود را با ابزار trtexec تست کنید تا خط مبنای عملکرد را بسازید.
  • از Nsight Systems برای شناسایی گلوگاه‌های CPU/GPU استفاده کنید.

اما داستان سخت‌افزاری این تحول حتی شگفت‌انگیزتر است — به تحلیل ما درباره‌ی تراشه‌های Blackwell مراجعه کنید.

چرا این موضوع مهم است؟

این راهکارها با تکیه بر تجربه عملی NVIDIA در مقیاس جهانی، زمان رسیدن محصول به بازار را کاهش می‌دهند. حذف خطاهای زمان اجرا، اعتماد سازمان‌ها به استقرار مدل‌های پیچیده را افزایش می‌دهد.

این گزارش با خط‌لولهٔ خودکار دات‌هوش از منابع معتبر جهانی تدوین و زیر نظر تحریریه منتشر شده است. روش کار ما

گفتگو

پنج‌شنبه‌های هوش‌محور

بسته‌ی هفتگی دات‌هوش

۵ خبر، ۲ ابزار، ۱ پرامپت در هر شماره. به‌زودی راه‌اندازی می‌شود — هر پنج‌شنبه صبح.

خبر کلیدی
ابزار کاربردی
پرامپت حرفه‌ای
تحلیل پژوهش
به‌زودی
زاویه‌ی ایرانی
به‌زودی
تمرین این هفته
به‌زودی

راهنماهای دات‌هوش

راهنماهای کاربردیِ دات‌هوش برای کار با هوش مصنوعی — از همین‌جا شروع کنید:

دات‌هوش

راهنمای فارسی هوش مصنوعی — با نگاه به ایران

اخبار روزانه، معرفی ابزارها و مدل‌ها، و آموزشِ کار با هوش مصنوعی؛ همیشه با این پرسش که از ایران چه چیزی کار می‌کند و چه چیزی نه.