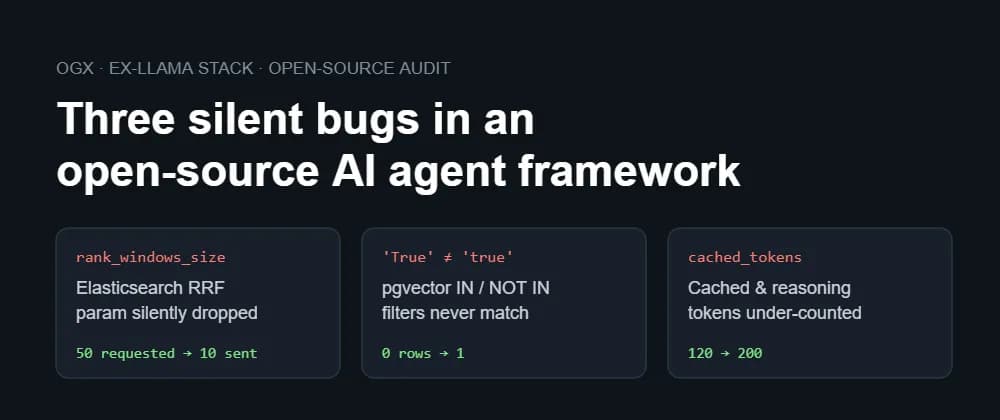
یک غلط املایی ساده در فایل تنظیمات میتواند حافظه یک عامل هوش مصنوعی را بهطور خاموش مخدوش کند، بدون آنکه هیچ پیام خطایی صادر شود. طبق گزارشی که در ۱ اکتبر ۲۰۲۶ منتشر شد، سه «باگ خاموش» در OGX — چارچوب متنباز که پروژه Llama Stack متا را ادامه میدهد — شناسایی شده است.
ساخت عاملها بر پایه زیرساختی مثل OGX معمولاً به معنای اعتماد به بلوکهای سازنده است؛ یعنی استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دورهی آموزش آشپز — و APIهای پاسخدهی و ذخیرهسازهای برداری (Vector Stores)، بدون آنکه توسعهدهنده تکتک خطوط کد را بازبینی کند. این اعتماد یک نقطه کور ایجاد میکند؛ جایی که یک قابلیت «تقریباً» درست کار میکند، اما در محیط عملیاتی بهگونهای شکست میخورد که ابزارهای نظارتی استاندارد قادر به شناسایی آن نیستند. این آسیبپذیریهای زیرساختی یادآور چالشهای امنیتی در مدلهای دیگر متا است، مانند ضعف مدل Prompt Guard 2 در شناسایی حملات تزریق پرامپت که نشان میدهد حتی ابزارهای نظارتی پیشرفته نیز میتوانند نقاط کور جدی داشته باشند.
زمینه: زیربنای OGX
OGX بلوکهای استاندارد برای برنامههای عاملمحور (Agentic) را فراهم میکند. این شامل یک API پاسخدهی سازگار با OpenAI و پشتیبانی از پایگاهدادههای برداری مختلف برای تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — مانند Elasticsearch، pgvector و Qdrant است.
از آنجایی که تیمهای توسعه به این بلوکهای پیشساخته تکیه میکنند، بهندرت کدهای زیربنایی را بازخوانی میکنند. دقیقاً همینجاست که بازرسیهای فنی با شکار منطقهایی که به ظاهر درستاند اما بهطور خاموش نتایج را منحرف میکنند، ارزش پیدا میکنند.
سه شکست خاموش
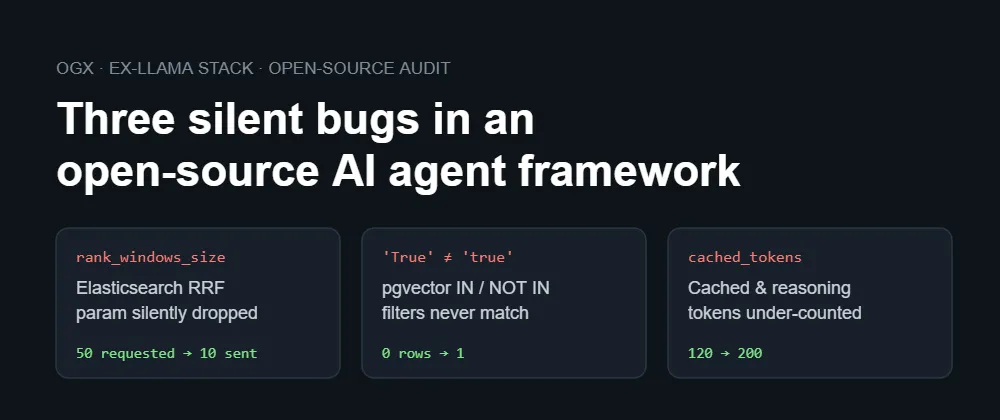
بر اساس مستندات این بازرسی، سه سازوکار خاص شناسایی شدند که بهطور خاموش دچار شکست شده بودند:
- ارتباط جستوجو (Search Relevance): یک غلط املایی در لیست
allowed_rrf_paramsباعث شد یک حرف 's' اضافی به عبارتrank_window_sizeاضافه شود و به صورتrank_windows_sizeنوشته شود. در نتیجه، Elasticsearch این پارامتر را ناشناخته تلقی کرد و بهطور خاموش آن را حذف کرد. در نتیجه، سیستم بهجای مقدار درخواستی ۵۰، به مقدار پیشفرض ۱۰ بازگشت که نتایج جستوجوی ترکیبی (Hybrid Search) را مخدوش کرد. این مورد در Pull Request شماره ۶۶۹۷ اصلاح شد. - فیلتر کردن متادیتا (Metadata Filtering): در pgvector، فیلترهای بولی (Boolean) مانند
published = trueشکست میخوردند؛ زیرا کد، مقدارTrueپایتون را به رشته "True" تبدیل میکرد، در حالی که PostgreSQL ۱۶ متادیتای JSON را به صورت "true" استخراج میکند. این دو مقدار هرگز با هم مطابقت ندارند. این مشکل اعداد را نیز تحت تأثیر قرار داد؛ برای مثال مقداری مانند ۲۰۲۳.۰ در مقابل ۲۰۲۳ فیلتر میشد. بدترین حالت در فیلترهای استثنا (NOT IN) رخ میداد که باعث میشد اسنادی که قرار بود حذف شوند، عبور کنند و بهطور بالقوه منابع منتشرنشده یا قدیمی وارد خط لوله RAG شوند. اصلاحیه این مورد در Pull Request شماره ۶۶۹۸ ارائه شد و تبدیلهای نوعی (Typed Casts) مورد استفاده در مقایسههای تکمقداری را برای لیستها نیز اعمال کرد. - حسابداری توکن (Token Accounting): API پاسخدهی نمیتوانست مجموع توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک که مدل تکهتکه میخورد — مربوط به حافظه پنهان (Cache) و استدلال (Reasoning) را در فراخوانیهای متعدد مدل (مثلاً زمانی که یک عامل از ابزارها استفاده میکند) جمع بزند. در حالی که توکنهای ورودی و خروجی بهدرستی جمع میشدند، توکنهای کش و استدلال بازنویسی (Overwrite) میشدند. برای مثال، اگر دو فراخوانی 각각 ۸۰ و ۱۲۰ توکن کش داشتند، سیستم بهجای ۲۰۰، عدد ۱۲۰ را گزارش میکرد. این خطا در Issue شماره ۶۶۹۹ گزارش و در کامیت e8177d0 اصلاح شد.
این باگها بهویژه در ردیابی هزینهها فریبنده هستند. کش کردن هزینه را کاهش و استدلال آن را افزایش میدهد؛ داشبوردی که بر این مقادیر تکیه کند، هر دو رقم را کمتر از واقعیت تخمین میزند.
برای توسعهدهندگان، این موضوع یک فرض خطرناک را به چالش میکشد: نبود پیام خطا به معنای صحت عملکرد نیست. وقتی یک فیلتر تطابق نمییابد، سیستم صرفاً نتایج کمتر یا اشتباهی برمیگرداند و مدل ممکن است این پاسخهای غلط را بهعنوان جوابهای پذیرفتنی پردازش کند. در مقابل، برای دستیابی به پایداری در حافظه عاملها، راهکارهایی مانند سیستم Codex برای حفظ حافظه در پنجرههای متنی توسعه یافتهاند تا از فراموشی محدودیتها و دادههای حیاتی جلوگیری شود.
درسهایی برای عرضه عاملها
این تغییر در دیدگاه به این معناست که تیمها باید از «تستهای دود» (Smoke Tests) که فقط بررسی میکنند آیا سیستم کرش میکند یا خیر، فراتر بروند.
- تست موارد خاموش: شما به تستهایی نیاز دارید که مقادیر واقعی ارسالی به پایگاهداده را تأیید کنند، نه فقط نبود پیام خطا را.
- تست با انواع دادههای واقعی: باگهای مربوط به مقادیر بولی، اعشاری یا فراخوانیهای زنجیرهای توسط مجموعههای تست که فقط از رشتهها و تکفراخوانیها استفاده میکنند، نادیده گرفته میشوند.
- تأیید زیربنا: چارچوبهای متنباز محبوب اغلب با سرعت زیاد نوشته میشوند. بازبینی بلوکهای حیاتی مانند فیلترینگ و ردیابی هزینه پیش از استقرار در محیط عملیاتی تنها چند ساعت زمان میبرد اما از ماهها شکست خاموش جلوگیری میکند.
ارائه این اصلاحات در مخزن اصلی (Upstream) تضمین میکند که کل اکوسیستم عاملمحور مقاومتر شود. مراقب الگوهای مشابه در سایر چارچوبهای متنباز RAG باشید، بهویژه در مورد نحوه تبدیل انواع دادههای پایتون به رشتههای SQL در ذخیرهسازهای برداری.
اما اثر این خطاهای کوچک بر دقت مدلهای استدلالی حتی پیچیدهتر است — به بررسی ما دربارهی زنجیره تفکر در مدلهای جدید مراجعه کنید.



گفتگو