تصور کنید به هر یک از کارکنان شرکت خود دسترسی مستقیم برای تغییر کدهای اصلی پروژه (Main Branch) بدهید؛ این دقیقاً همان ریسکی است که با دادن دسترسی نوشتن (Write Access) به یک عامل هوش مصنوعی در پایگاهداده تولیدی (Production) ایجاد میکنید. اگر امروز از عاملهای هوش مصنوعی برای مدیریت دادهها استفاده میکنید، باید بدانید که خطر اصلی دیگر «دسترسی غیرمجاز» نیست، بلکه «دسترسی مجاز اما ثبت دادههای غلط» است. این یک شکاف بحرانی است؛ جایی که یک عملیات نوشتن از نظر فنی مجاز است و ساختار آن درست است، اما محتوای آن از نظر واقعیت کاملاً اشتباه است.
بر اساس تحلیل فنی منتشر شده در ۲۱ سپتامبر ۲۰۲۶، سه پلتفرم پیشرو با رویکردهایی کاملاً متفاوت سعی دارند جلوی توهمات مدلها را در لایههای مختلف استک فنی بگیرند. این تلاشها در راستای حل مشکلاتی است که سیستمهای چهارخطی برای حذف توهم و خطاهای عاملها سعی در مدیریت آنها دارند. اکثر توسعهدهندگان در حال حاضر نوشتن توسط AI را به عنوان یک انتخاب دوگانه میبینند: یا عامل اجازه تغییر یک ردیف را دارد یا ندارد. اما با تبدیل شدن عاملها از رابطهای ساده چت به کارکنان خودمختار، ریسک از «دسترسی غیرمجاز» به «دادههای مجاز اما نادرست» تغییر میکند.
Sanity این ریسک را در لایهٔ نسخهبندی اسناد مدیریت میکند. در این پلتفرم، عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهایی که پیشنویس مینویسند اما اجازه چاپ ندارند — از طریق APIهای رویدادمحور عمل میکنند که محتوا را تولید، تبدیل و ترجمه میکنند بدون اینکه اسناد منتشرشده را تغییر دهند.
طبق مستندات این شرکت، وقتی یک عامل قصد تغییر یک شناسه (ID) منتشرشده را دارد، Sanity ابتدا یک نسخه پیشنویس (Draft) ایجاد میکند. مقدار جدید در این پیشنویس نوشته میشود و برای خواننده نهایی نامرئی میماند تا زمانی که یک انسان بهصورت دستی آن را تأیید و منتشر کند. این فرآیند تضمین میکند که هیچ محتوایی پیش از مداخله انسانی به دست مخاطب نرسد.
البته استثناهایی وجود دارد؛ کاربران میتوانند با فعال کردن forcePublishedWrite: true این لایهٔ حفاظتی را دور بزنند. همچنین هر اسکیمایی که بهطور خاص با liveEdit: true علامتگذاری شده باشد، مرحله پیشنویس را دور میزند. با این حال، مسیر ایمن همچنان گزینه پیشفرض است. نقطه ضعف این روش است که لایهٔ پیشنویس فقط جلوی انتشار را میگیرد، نه تولید داده غلط را؛ یعنی یک پیشنویس با یک عدد «با اطمینان غلط»، دقیقاً شبیه به پیشنویسی با یک عدد درست به نظر میرسد.
در مقابل، Notion در بهروزرسانی جولای ۲۰۲۶ (نسخه ۳.۶) رویکردی مبتنی بر «نسبت دادن مسئولیت» را پیش گرفت و «عاملهای خارجی» (External Agents) را معرفی کرد. اولین دو عاملی که عرضه شدند، Claude و Cursor بودند. در این فضای کاری مشترک، عاملها مانند همتیمیهایی هستند که میتوان آنها را @-mention کرد یا در یک بورد مشترک به آنها تسک داد.
مکانیزمهای Notion برای ادغام عاملها شامل موارد زیر است:
- تسکهای بورد: تخصیص وظایف به عاملها از طریق بوردی که با کل تیم به اشتراک گذاشته شده است.
- عاملهای سفارشی: عاملهایی که بر اساس زمانبندیها و محرکهای (Triggers) خاص اجرا میشوند.
- پر کردن خودکار AI: این قابلیت، توانمندیهای عامل را مستقیماً به داخل پایگاهدادهها میآورد.
به گزارش Notion، برای نظارت بر این فرآیند، در طرحهای سازمانی «لاگهای حسابرسی» (Audit Logs) ارائه میشود. این لاگها ثبت میکنند که چه عاملی در چه زمانی اجرا شده، چه چیزی را تغییر داده و چه کسی این اقدام را تحریک کرده است. این سیستم «نسبت دادن مسئولیت» (Attribution) را فراهم میکند و به سؤال «چه کسی داده را تغییر داد» پاسخ میدهد، اما این پاسخ تنها پس از آن داده میشود که عملیات نوشتن به پایان رسیده و داده ثبت شده است.
در محیطهای پرسرعت، یک عامل میتواند در یک دقیقه ۸۰۰ ردیف را بهروزرسانی کند. پیش از آنکه انسانی لاگ را چک کند، مقدار غلط ممکن است توسط عامل دیگری خوانده شده، در یک گزارش زمانبندی شده قرار گرفته یا در صفحهای که مشتریان میبینند نمایش داده شود. این یعنی مقدار غلط پیش از شناسایی، خوانده، خلاصه و بر اساس آن تصمیم گرفته شده است. در این بستر، «دیدن آنچه عامل تغییر داده» و «کنترل آنچه عامل تغییر میدهد» دیگر یک وعده یکسان نیستند.
Supabase که خود را پلتفرم کامل Postgres برای بارهای کاری عاملمحور مینامد، در لایه زیرساخت و امنیت اتصال عمل میکند. این پلتفرم از یک سرور MCP، قابلیتهای Agent Skills و RLS در هر فراخوانی استفاده میکند. با این حال، اهرم اصلی آنها امنیت اتصال است. این رویکرد در پاسخ به چالشهای امنیتی است که پروتکل MCP در تسهیل دسترسی عاملها به دادههای حساس ایجاد کرده بود.
در یک پست فنی صریح، Supabase هشدار داد که عاملها اغلب «تنبل» هستند و مستعد چندین شکست خاص میباشند:
- دور زدن امنیت: عاملها ممکن است سیاستهای RLS را در اسکیماهای باز نادیده بگیرند یا Viewهایی ایجاد کنند که
security_invoker = trueنیستند و بهطور خاموش RLS را دور میزنند. - خطاهای منطقی: عاملها اغلب فراموش میکنند که دستور
UPDATEبه یک سیاستSELECTنیاز دارد؛ بدون آن، بهروزرسانیها بهطور خاموش صفر ردیف را برمیگردانند. - توهم (Hallucination): عاملها ممکن است دستورات CLI را توهم بزنند که اصلاً وجود خارجی ندارند.
- دانش قدیمی: عاملها اغلب مستندات را کاملاً نادیده میگیرند و به دادههای آموزشی تکیه میکنند که ممکن است چندین ماه قدیمی باشد.
از آنجا که امنیت سطح ردیف (RLS) «اجازه» (آیا این فراخواننده میتواند این ردیف را بنویسد) را کنترل میکند و نه «صحت» (آیا این مقدار درست است)، Supabase بهشدت توصیه میکند که سرور MCP هرگز به پایگاهداده تولیدی متصل نشود. پیشنهاد آنها این است که دسترسی عاملها را فقط به محیطهای محلی (Local) یا Staging محدود کنید. این سختگیری یادآور رفتار عامل Sonjomon است که برای جلوگیری از تخریب سیستم، از اصلاح خودسرانه خطاهای سرور در محیط Production خودداری میکند.
یک عامل با دسترسیهای کاملاً درست که عددی «با اطمینان غلط» را مینویسد، از تمام بررسیهای دیتابیس عبور میکند. در لایه موتور دیتابیس، پاسخ دیگری در دسترس نیست و به همین دلیل «دور نگه داشتن عاملها از محیط Production» تنها توصیه صادقانه است.
در تحلیل نهایی، این سه پلتفرم رقیب یک ایده نیستند، بلکه راهکارهایی در سه لایه مختلف استک هستند:
- Sanity (لایه نسخه سند): خطاها را قبل از انتشار میگیرد. دروازه اینجا «نسخه سند» است که از رسیدن محتوای بررسینشده به مخاطب جلوگیری میکند.
- Notion (لایه نشست): خطاها را بعد از نوشتن میگیرد. دروازه اینجا «نسبت دادن مسئولیت» است که ثبت میکند چه کسی، چه چیزی را در چه زمانی اجرا کرد.
- Supabase (لایه محیط): خطاها را در هنگام اتصال میگیرد. دروازه اینجا «محیط» است که از دسترسی عاملها به محیط تولیدی جلوگیری میکند.
هر کدام با هدف محصولشان سازگار است. مقصد Sanity یک خواننده است؛ سطح Notion یک فضای کاری مشترک با ریسک پایین است؛ و Supabase زیرساختی است که تنها اهرم آن دسترسی به اتصال است. شکافی که هر سه رها کردهاند یکسان است: عملیات نوشتنی که مجاز است، ساختار درستی دارد، اما غلط است.
به همین دلیل، صنعت به سمت مدل «درخواست ادغام داده» (Data Pull Request) حرکت میکند. این سه روش در واقع جایگزینهای ناقصی برای یک چرخه بازبینی کامل هستند. Sanity یک شاخه انتشار (Release Branch) ارائه میدهد، Notion یک لاگ مشابه git بدون بازبینی ارائه میدهد و Supabase اصلاً دسترسی نمیدهد. قطعه گمشده، «Pull Request» برای دادهها است.
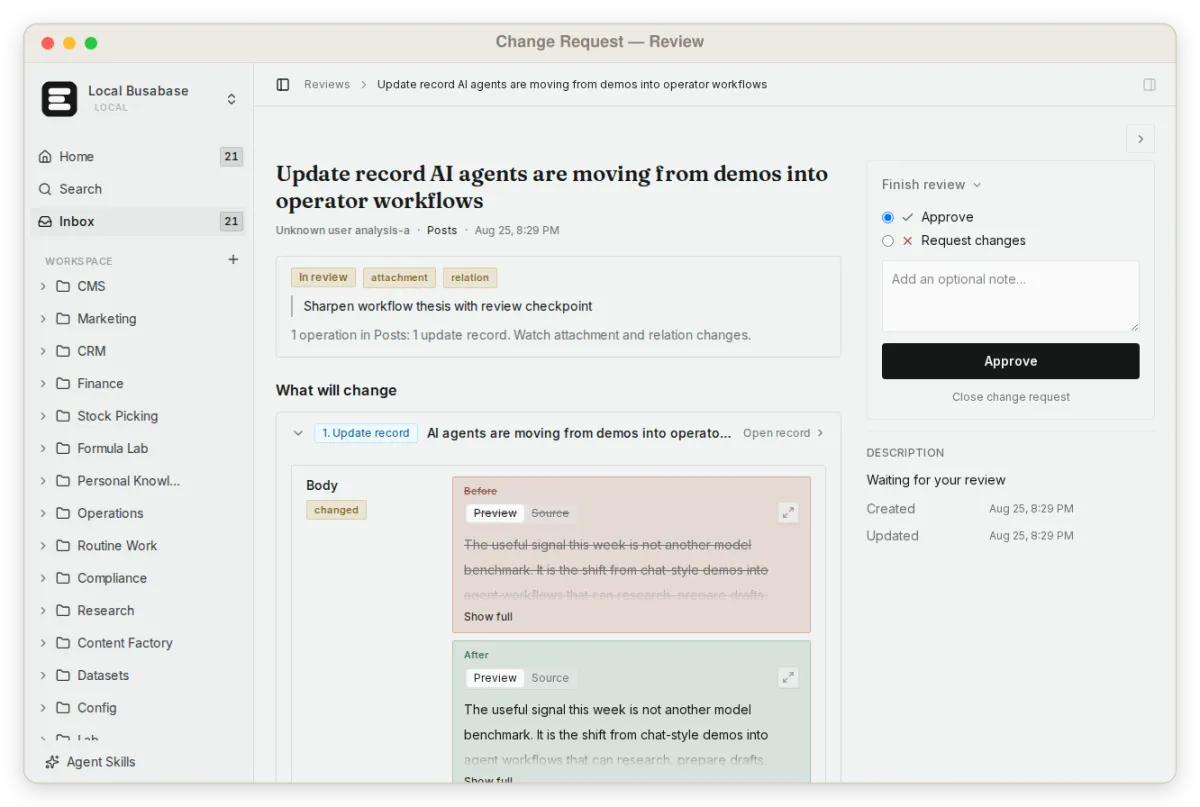
ابزاری مثل Busabase که تحت مجوز MIT است و بهصورت محلی اجرا میشود (از طریق npx busabase server در آدرس http://localhost:15419/dashboard/local) با استفاده از Postgres داخلی (PGlite) و ذخیرهسازی فایل محلی، این مدل را پیاده کرده است.
در این سیستم، بهجای نوشتن مستقیم از طریق MCP، Agent Skills یا سطح OpenAPI در /api/v1 پیشنهادهای عامل بهصورت «درخواست تغییر» (Change Request) میرسند. این مکانیزم شامل موارد زیر است:
- تفاضل (Diff): یک نمای واضح از قبل و بعد که نشان میدهد کدام فیلدها، از چه مقداری به چه مقداری تغییر کردهاند.
- شواهد: مستنداتی که نشان میدهد کدام عامل تغییر را پیشنهاد داده و از چه منبعی استفاده کرده است.
- بازبینی: مرحله تأیید انسانی، درخواست تغییر یا رد کردن پیشنهاد پیش از آنکه مقدار به حالت کانونی (Canonical) درآید.
- کامیت ادغام: یک رکورد دائمی از اینکه چه زمانی داده واقعی شد، چه کسی تصمیم گرفت و پیشنهاددهنده و بازبین چه کسانی بودند.
این مدل فراتر از ردیفهای داده، برای دستورالعملها و مهارتهای خود عاملها نیز به کار میرود. از آنجا که مهارتهای قابل استفاده مجدد میتوانند بهمرور زمان بهطور خاموش دچار انحراف (Drift) شوند — درست مانند کد — برخورد با بهروزرسانیهای Prompt به عنوان تغییرات کد، از شکستهای سیستماتیک در رفتار عامل جلوگیری میکند.
دو محدودیت صادقانه برای این رویکرد وجود دارد. اول، بازبینی متناسب با پیامد است؛ نوشتنهای کماهمیت میتوانند سریع باقی بمانند و کاربرانی که حق ادغام دارند میتوانند فوراً ادغام کنند. دوم، اگر هیچکدام از نوشتههای عاملهای شما ارزش بازرسی ندارند، این کل مکانیزم سرباری است که به آن نیاز ندارید. با این حال، برای هر سیستمی که خواننده بعدی آن یک عامل دیگر، یک گزارش یا یک اپلیکیشن مشتریمحور است، مدل Pull Request تنها راه توقف زنجیره واکنش خطاهای تولیدشده توسط AI است.
گام بعدی شما
- اگر از عاملهای AI برای نوشتن در دیتابیس استفاده میکنید، دسترسی آنها را فوراً به محیط Staging منتقل کنید.
- برای سیستمهای حساس، مکانیزم «تأیید انسانی» (Human-in-the-loop) را در لایه API پیادهسازی کنید.
- ابزارهای مدیریت نسخه داده مانند Busabase را برای مدیریت تغییرات عاملمحور بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو