
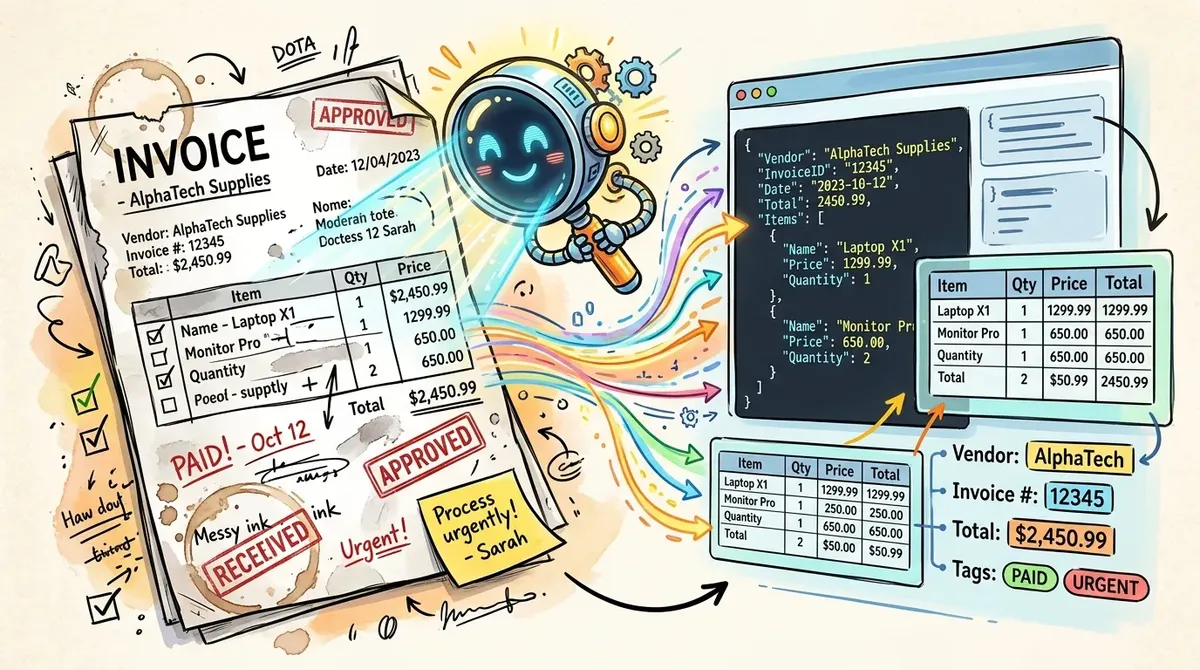
یک فاکتور نامرتب با لکهی قهوه یا یک خط جداکنندهی اضافی میتواند کل خط لولهی تولیدی را که در دمو بینقص به نظر میرسید، از کار بیندازد. در حالی که اکثر فروشندگان ادعای دقت ۹۹٪ را دارند، این اعداد اغلب بر اساس بنچمارکهای داخلی و با استفاده از نمونههای تمیز است، نه اسناد ناقص و متناقضی که کسبوکارهای واقعی هر روز با آنها سر و کار دارند.
تصور کنید یک فاکتور چاپخانه معمولی را بررسی میکنید: ممکن است چهار چکباکس برای روش پرداخت وجود داشته باشد که فقط یکی تیک خورده است، یا یک چکباکس «شامل بدهیهای گذشته» در کنار تاریخ صدور قرار گرفته باشد، و یا تخفیفی در دل یک برچسب متنی دفن شده باشد بهجای اینکه در فیلد مخصوص خود قرار گیرد. حتی ممکن است حاوی متنهای پیشفرض مانند «توضیحات کالا را بنویسید» باشد که از قالب اولیه باقی مانده است. یک تحلیلگر ضعیف، این موارد را بهعنوان محتوای واقعی استخراج میکند. این واقعیت تلخ و روزمرهی صندوق ورودی بخش حسابهای پرداخت است.
پردازش اسناد اکنون از نویسهخوانی نوری (OCR) ساده به سمت «OCR عاملمحور» (Agentic OCR) و خط لولههای بومی مدلهای زبانی بزرگ (LLM-native) حرکت میکند. هدف دیگر فقط خواندن متن نیست، بلکه حفظ روابط مکانی — مثل وضعیت چکباکسها و جداول چندستونی — است که یک انسان برای درک سند به آنها تکیه میکند. طبق گزارشی که در ۲۱ اوت ۲۰۲۶ منتشر شد، ابزارهایی که در محیط عملیاتی دوام میآورند، اولویت را به حفظ ساختار (Layout Preservation) و اعتبارسنجی سطح اطمینان میدهند، نه نمرات نمایشی بنچمارک.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، شفافیت در لایههای پردازش، کلید جلوگیری از خطاهای خاموش در سیستمهای اتوماسیون است.
معیارهای واقعی تفکیک ابزارها
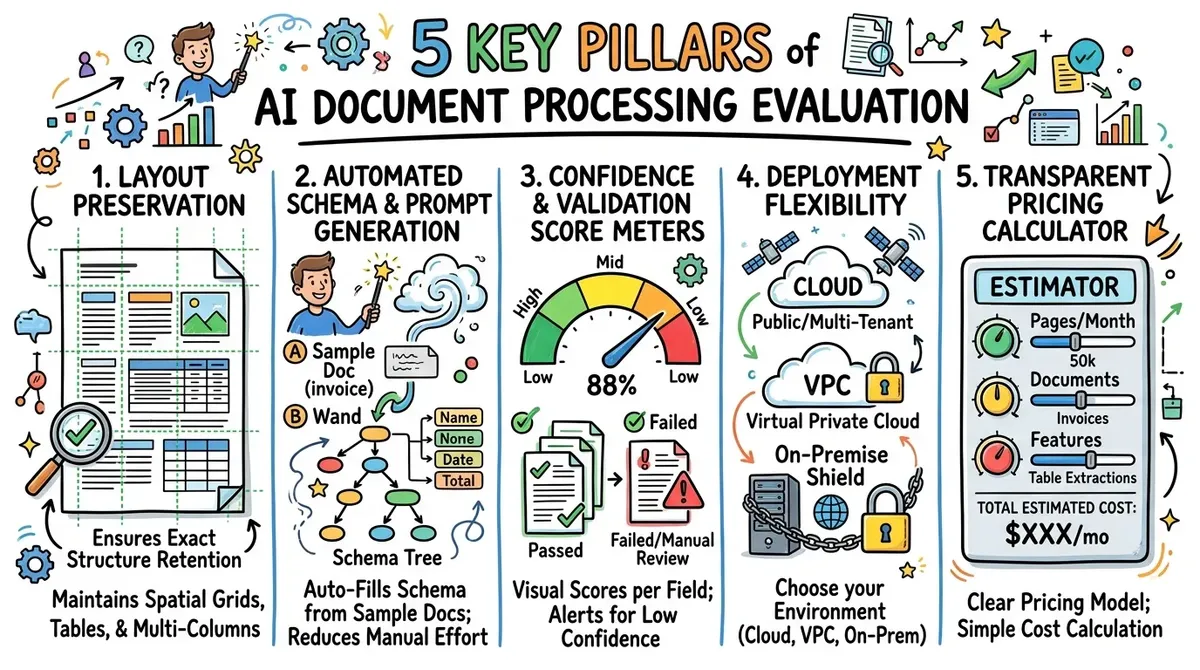
به نقل از بررسیهای فنی، هنگام ارزیابی هوش مصنوعی برای پردازش اسناد، پنج معیار بسیار مهمتر از نمرات بنچمارک هستند:
- حفظ ساختار (Layout Preservation): آیا ابزار ساختار جداول و وضعیت چکباکسها را دستنخورده نگه میدارد، یا همه چیز را به یک جریان متنی تخت تبدیل میکند که روابط مکانی را نابود میکند؟
- اتوماسیون طرحواره و پرامپت: آیا پلتفرم ساختار را از روی نمونهها استنتاج میکند، یا باید هر فیلد و قانون استخراج را بهصورت دستی تعریف کنید؟
- اعتبارسنجی و سطح اطمینان: آیا سیستم عدم قطعیت را علامتگذاری میکند، یا یک استخراج غلط دقیقاً شبیه به یک استخراج درست به نظر میرسد؟
- انعطاف در استقرار: آیا ابزار میتواند در محیط VPC، درونسازمانی (On-prem) یا فقط در ابر فروشنده اجرا شود؟ این مورد برای صنایع تحت نظارت و رگولاتوری حیاتی است.
- مدل قیمتگذاری: آیا هزینه بهازای هر صفحه است، بهازای هر اعتبار، یا باید با تیم فروش مذاکره کنید («Talk to Sales»)؟ این موضوع تعیین میکند که آیا تیم مالی میتواند بدون یک چرخه تدارکاتی طولانی، آن را تأیید کند یا خیر.
Unstract: خط لولهی سطح تولید
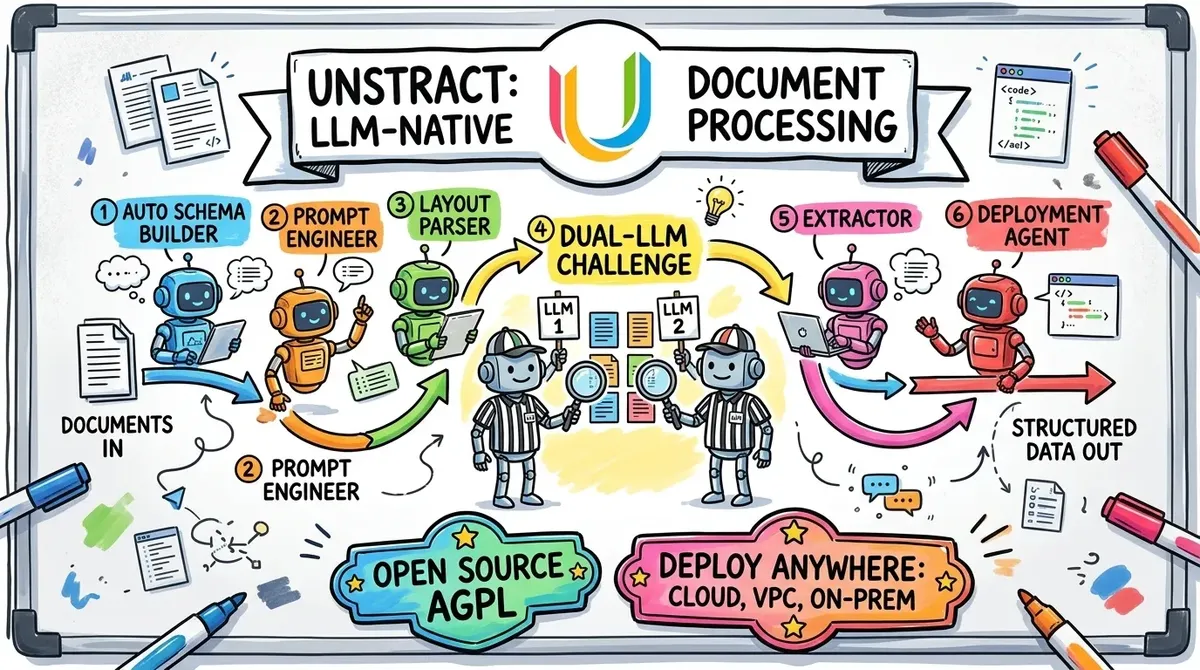
Unstract خود را بهعنوان یک پلتفرم بازمتن و بومی مدل زبانی بزرگ معرفی میکند که توسط Zipstack ساخته شده است. این ابزار با تبدیل استخراج به یک خط لولهی شفاف با مراحل مجزا، از رویکرد «جعبه سیاه» دوری میکند. این پلتفرم در سه شکل در دسترس است: یک نسخه رایگان میزبانی شخصی (تحت لایسنس AGPL-3.0)، یک نسخه ابری مدیریتشده (Cloud) و یک نسخه سازمانی درونسازمانی (On-Premise Enterprise) برای محیطهای حساس. این پروژه با ۶.۶ هزار ستاره در گیتهاب، ۶۲۹ فورک، ۱,۶۰۴ کامیت و ۵۴۷ انتشار، فعالیت فنی شدیدی را نشان میدهد.
تمایز اصلی آن LLMWhisperer است؛ یک لایه OCR که از خطای رایج تخت کردن جداول چندستونی به یک جریان متنی درهمریخته جلوگیری میکند. این قابلیت به مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اجازه میدهد روی یک ساختار جدول سالم استدلال کند. در یک فاکتور نمونه، این یعنی تفاوت بین جداسازی درست برچسب «تخفیف (۲۰٪)» از خط جمع کل، در مقابل ادغام آنها در یک متن غیرقابل استفاده.
برای حذف کارهای دستی در تعریف فیلدها، Unstract از یک استودیو پرامپت عاملمحور (Agentic Prompt Studio) استفاده میکند که شامل شش عامل هوش مصنوعی در دو مرحله است:
- ساخت طرحواره (Schema Building): یک عامل خلاصهساز (Summarizer) اسناد نمونه را میخواند، یک یکسانساز (Uniformer) فیلدهای تکراری را ادغام میکند و یک نهاییکننده (Finalizer) یک طرحواره JSON استاندارد میسازد.
- مهندسی پرامپت (Prompt Engineering): یک کاوشگر الگو (Pattern Miner) سرنخهای فرمت را مییابد، یک معمار پرامپت (Prompt Architect) دستورالعملها را مینویسد و یک منتقد (Critic Dry-Runner) پرامپت را در برابر طرحواره تست میکند تا نقاط ضعف را بیابد.
برای اعتبارسنجی، این پلتفرم از LLMChallenge استفاده میکند. در این مکانیزم، دو مدل بهصورت موازی اجرا میشوند؛ یکی استخراجکننده و دیگری به چالشکشنده. اگر آنها با هم اختلاف داشته باشند، سیستم بهجای یک خطای خاموش، مقدار NULL برمیگرداند. لاگ کامل این مقایسه برای عیبیابی از طریق API در دسترس است (مخصوص طرحهای Cloud و Enterprise).
Unstract همچنین امکان بررسی انسانی (Human-in-the-loop) را در طرحهای ابری (از سطح Starter به بالا) فراهم میکند و استخراجهای با اطمینان پایین را به بازبین ارجاع میدهد که سند منبع را بهصورت هایلایتشده میبیند. این ابزار به ۹ ارائهدهنده مدل (OpenAI, Anthropic, Azure OpenAI, AWS Bedrock, Google Gemini, Mistral و Ollama برای استنتاج محلی) و ۵ پایگاهداده برداری متصل میشود. دادهها را به Snowflake, Amazon Redshift, Google BigQuery, PostgreSQL, MySQL, S3, Dropbox و Google Drive ارسال میکند و دارای یک سرور MCP و نود n8n است.
قیمتگذاری و محدودیتها:
- نسخه بازمتن: رایگان، میزبانی شخصی از طریق Docker Compose.
- Cloud Starter: ماهانه ۴۹۹ دلار (۴۱۶ دلار در صورت پرداخت سالانه) برای ۵,۰۰۰ صفحه در ماه؛ هر صفحه اضافی ۰.۱۰ دلار.
- Cloud Growth: ماهانه ۲,۲۴۹ دلار (۱,۸۷۴ دلار در صورت پرداخت سالانه) برای ۲۵,۰۰۰ صفحه در ماه؛ هر صفحه اضافی ۰.۰۹ دلار.
- Enterprise: قیمت سفارشی برای استانداردهای SOC 2, ISO 27001, HIPAA, GDPR و SSO/SAML.
- بسته رایگان: ۱۰۰ صفحه در روز بدون نیاز به کارت اعتباری، بههمراه ۱۴ روز تست کامل.
- LLMWhisperer مستقل: ۱ تا ۱۵ دلار بهازای هر ۱,۰۰۰ صفحه بسته به پیچیدگی.
Reducto: اولویت با توسعهدهندگان RAG
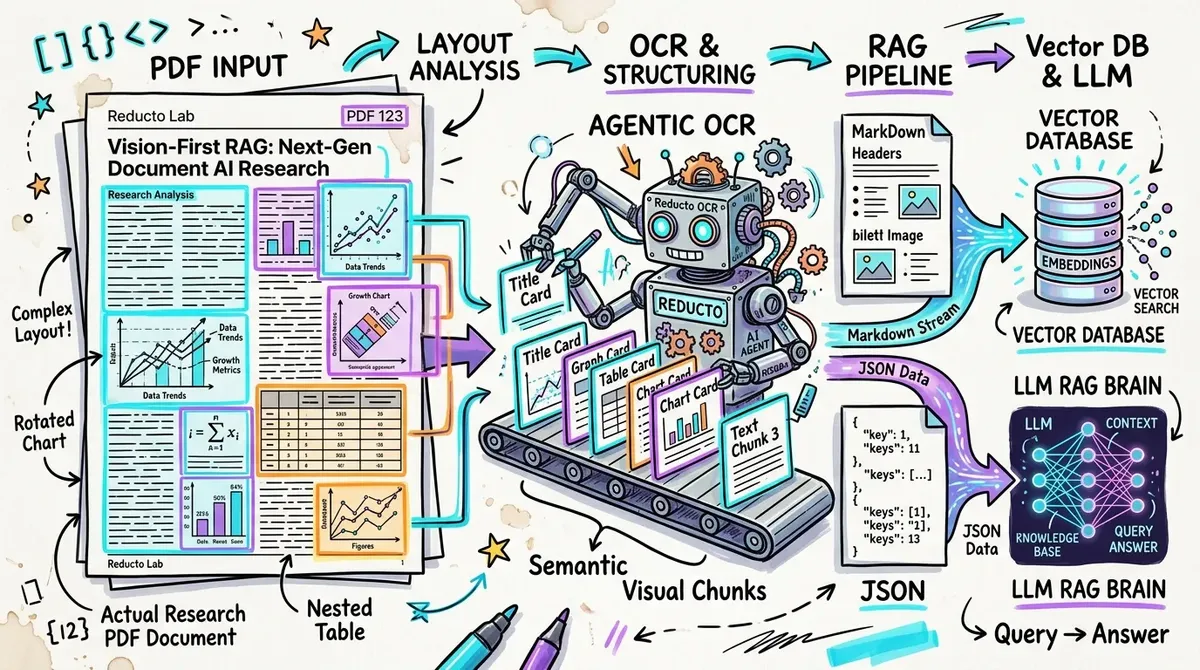
Reducto بر تبدیل اسناد نامرتب به دادههای ساختاریافته بهطور خاص برای سیستمهای تولید بازیابیافزا (RAG) و عاملهای هوش مصنوعی تمرکز دارد — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد. این شرکت با جذب ۱۰۸ میلیون دلار سرمایه، از جمله ۷۵ میلیون دلار در سری B به رهبری a16z، میلیاردها صفحه را برای مشتریانی مثل Harvey, Scale AI و Vanta پردازش کرده است.
Reducto از یک خط لولهی چندمرحلهای به نام Agentic OCR استفاده میکند که در آن یک عامل مدل بینایی-زبانی (VLM) خروجی OCR پایه را بازخوانی و تصحیح میکند تا خطاها را برطرف کند. این ابزار در بنچمارک عمومی RD-TableBench نمره ۰.۹۰ را کسب کرده و ادعا میکند در بنچمارکهای داخلی، ۲۰ درصد دقت بیشتری نسبت به APIهای بزرگ ابری دارد.
هر مقدار استخراجشده شامل یک جعبه محدودکننده (Bounding Box) و نمره اطمینان است که به مهندسان اجازه میدهد داده را دقیقاً در نقطه مربوطه در صفحه منبع ردیابی کنند. این پلتفرم پنج API ارائه میدهد: Parse, Extract, Classify, Split و Edit که از بیش از ۳۰ نوع فایل از جمله PDF، صفحات گسترده (Spreadsheets) و اسلایدهای ارائه پشتیبانی میکند.
قیمتگذاری و محدودیتها:
- Standard: ۱۵,۰۰۰ اعتبار اول رایگان، سپس ۰.۰۱۵ دلار بهازای هر اعتبار (هر صفحه برای Parse استاندارد ۱ اعتبار است).
- Growth: قیمت سفارشی؛ برای ارزیابیهای Studio، عدم ذخیرهسازی دادهها (Zero Data Retention)، قرارداد BAA امضا شده و نقاط انتهایی اقامت دادهها (Data Residency) الزامی است.
- Enterprise: قیمت سفارشی برای SSO/SAML و استقرار در محیطهای ایزوله (Air-gapped).
Rossum: متخصص تراکنشها
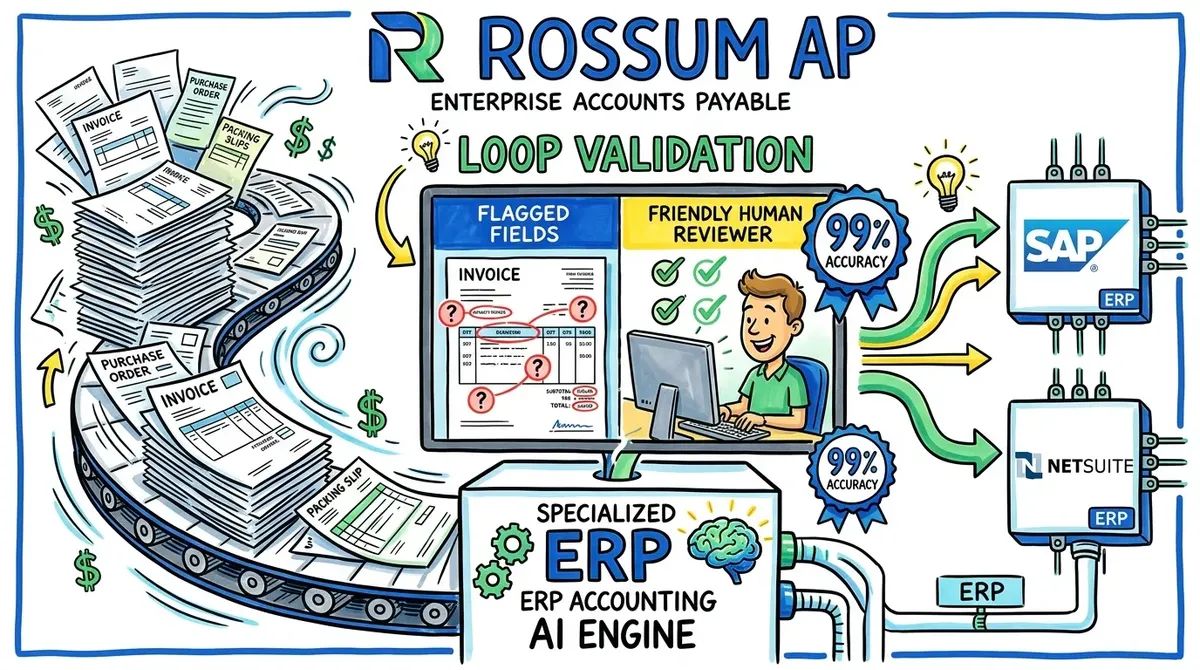
Rossum که در می ۲۰۲۶ توسط Coupa خریداری شد، اسناد عمومی و قراردادها را نادیده میگیرد و منحصراً روی اسناد تراکنشی مثل فاکتورها، سفارشات خرید (PO)، یادداشتهای تحویل و سفارشات فروش تمرکز دارد. این ابزار توسط بیش از ۴۵۰ سازمان از جمله Bosch, Siemens, Panasonic و Flexport استفاده میشود.
این پلتفرم از مدل اختصاصی و داخلی Aurora استفاده میکند که روی میلیونها سند تراکنشی آموزش دیده است. این رویکرد مدل بسته، ریسک نشت داده به ارائهدهندگان خارجی LLM را کم میکند اما کاربر را از تعویض مدل در صورت افت عملکرد محروم میکند. Rossum از ۲۷۶ زبان، از جمله دستخط، پشتیبانی کرده و دادههای استخراجشده را بهطور خودکار با دادههای پایه (Master Data) در سیستمهای ERP تطبیق میدهد.
ویژگی برجسته آن «اعتبارسنجی حلقوی» (Loop Validation) است؛ یک مرحله بررسی انسانی که اصلاحات را دوباره به مدل بازمیگرداند تا یاد بگیرد. Rossum گزارش میدهد که برای یک ساختار خاص، پس از پردازش ۱۰ تا ۲۰ سند به دقت بالای ۹۰٪ میرسد (با ذکر مورد مطالعاتی بندر روتردام). این ابزار ادغام عمیقی با SAP, Coupa, Workday, Oracle, NetSuite و QuickBooks Online دارد.
قیمتگذاری و محدودیتها:
- Starter: حداقل حدود ۱۸,۰۰۰ دلار در سال؛ شامل دسترسی نامحدود کاربران و ۱۲ ماه آرشیو.
- Business/Enterprise: قیمت سفارشی؛ برای SSO، منطق تجاری سفارشی و اکثر کانکتورهای ERP الزامی است.
- SAP Marketplace: لایههای Silver (۴۰,۰۰۰ دلار در سال برای ۱۰۰ هزار صفحه) و Gold (۷۰,۰۰۰ دلار در سال برای ۲۵۰ هزار صفحه).
Nanonets: اتوماسیون بدون کد
Nanonets بهجای مهندسان، تیمهای عملیاتی را هدف قرار داده است. این ابزار از یک سازنده گردشکار بلوکی (Block-based) استفاده میکند که کاربران در آن بلوکهای استخراج، طبقهبندی، فرمتبندی و مسیریابی را به هم زنجیر میکنند.
موتور استخراج آن بر اساس مدل Qwen2.5-VL است و روی بیش از ۲۵۰,۰۰۰ سند آموزش دیده تا فایلها را به Markdown ساختاریافته تبدیل کند. ویژگی کلیدی آن «دستورالعملهای هوش مصنوعی» (AI Guidelines) است که به کاربران اجازه میدهد منطق استخراج — مثلاً قوانین مالیاتی VAT خاص یک حوزه قضایی یا فیلتر کردن صفحات — را با زبان ساده توصیف کنند.
Nanonets از استانداردهای SOC 2, HIPAA, GDPR و ISO 27001 پشتیبانی میکند و گزینههای ابر خصوصی و On-prem را ارائه میدهد. این ابزار به SAP, Oracle و Salesforce متصل میشود.
قیمتگذاری و محدودیتها:
- Starter: شروع رایگان با ۲۰۰ دلار اعتبار بدون تاریخ انقضا.
- مدل مصرفی بلوکی: ۰.۰۲ دلار برای اجراهای ساده، ۰.۱۰ دلار برای AI استاندارد و ۰.۳۰ دلار برای استخراجهای پیچیده AI. یک فاکتور معمولی در کل زیر ۲ دلار هزینه دارد.
- Growth/Enterprise: قیمت سفارشی با تخفیفهای حجمی تا ۴۰٪.
Google Document AI: بازی در اکوسیستم
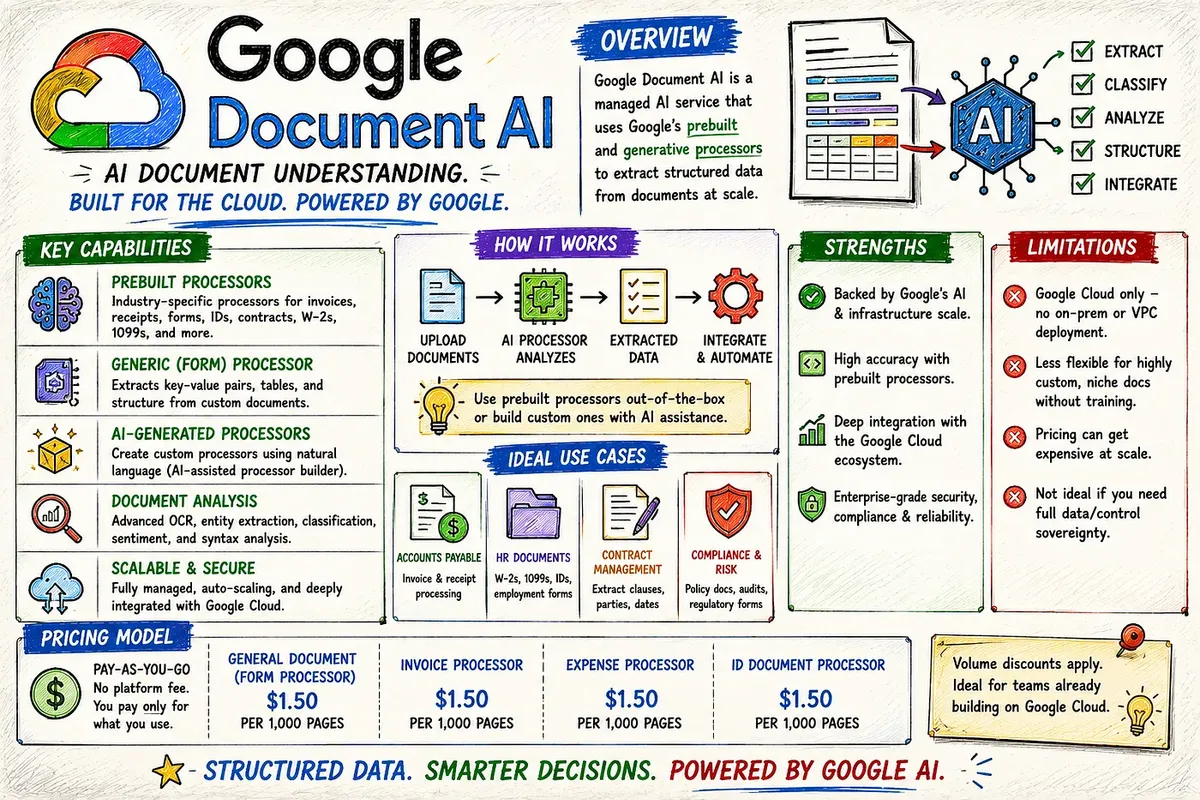
Google Document AI انتخاب پیشفرض برای تیمهایی است که روی Google Cloud Platform (GCP) هستند. گوگل قابلیتهای خود را در قالب «پردازشگرها» (Processors) برای دیجیتالی کردن، استخراج و طبقهبندی سازماندهی کرده است.
گوگل اخیراً مدلهای Gemini 3 Flash و Gemini 3 Pro را در Layout Parser و Custom Extractor خود (در حال حاضر در حالت Preview) ادغام کرده است. این امر به کاربران اجازه میدهد استخراجکنندههای سفارشی را تنها با ۱۰ تا ۵۰ نمونه برچسبگذاری شده راهاندازی کنند. پردازشگرها به سه خانواده تقسیم میشوند:
- Digitize: نویسهخوانی نوری (OCR) اسناد سازمانی.
- Extract: شامل Form Parser, Layout Parser و پردازشگرهای پیشساخته برای فاکتورها، رسیدها و فرمهای W-2.
- Classify: جداکنندهها (Splitters) و طبقهبندیکنندههای سفارشی برای دستههای مختلط اسناد.
درخواستهای همزمان (Synchronous) به ۱۰ صفحه محدود شدهاند؛ فایلهای بزرگتر به API دستهای نامتقارن (Asynchronous Batch) تا ۲۰۰ صفحه نیاز دارند. خروجی شامل مختصات جعبه محدودکننده برای هر مقدار است.
قیمتگذاری و محدودیتها:
- Enterprise Document OCR: ۱.۵۰ دلار بهازای هر ۱,۰۰۰ صفحه (کاهش به ۰.۶۰ دلار برای بیش از ۵ میلیون صفحه در ماه).
- Custom Extractor/Form Parser: ۳۰ دلار بهازای هر ۱,۰۰۰ صفحه (کاهش به ۲۰ دلار برای بیش از ۱ میلیون صفحه در ماه).
- Layout Parser: ۱۰ دلار ثابت بهازای هر ۱,۰۰۰ صفحه.
- Custom Splitter/Classifier: ۵ دلار بهازای هر ۱,۰۰۰ صفحه (کاهش به ۳ دلار برای بیش از ۱ میلیون صفحه در ماه).
- میزبانی: ۰.۰۵ دلار بهازای هر ساعت استقرار نسخه برای پردازشگرهای سفارشی.
جمعبندی مقایسهای
- Unstract: بهترین برای اتوماسیون سطح تولید که نیاز به میزبانی شخصی، عدم وابستگی به یک LLM خاص و تولید خودکار طرحواره دارد.
- Reducto: بهترین برای خط لولههای RAG که به تحلیل بصری با دقت بالا و استناد به مختصات صفحه (Bounding-box) نیاز دارند.
- Rossum: بهترین برای گردشکارهای حجیم و استاندارد حسابهای پرداخت با ادغام عمیق در سیستمهای ERP.
- Nanonets: بهترین برای تیمهای عملیاتی بدون کد با بودجه محدود که به گردشکارهای بلوکی نیاز دارند.
- Google Document AI: بهترین برای تیمهای بومی GCP که میخواهند ارکستراسیون سفارشی خود را حول پردازشگرهای پیشساخته بسازند.
تحلیل: تغییر به سمت بنچمارکهای «بدترین حالت»
این مقایسه نشاندهنده یک تغییر حیاتی در حوزه IDP (پردازش هوشمند اسناد) است. صنعت در حال فاصله گرفتن از «دقت» (Accuracy) بهعنوان معیار اصلی است، زیرا این عدد بهراحتی توسط مجموعهدادههای منتخب فروشنده دستکاری میشود. استاندارد طلایی جدید، «تابآوری» (Resilience) است؛ یعنی ابزار چگونه با بدترین ۲۰٪ از مجموعهی اسناد برخورد میکند.
برای کاربر، این بدان معناست که وعدهی «همه-در-یک» هوش مصنوعی هنوز یک افسانه است. شما باید بین انعطافپذیری یک خط لولهی مستقل از LLM (مثل Unstract)، دقت یک API با اولویت بینایی (مثل Reducto) یا پایداری یک مدل آموزشدیده در یک حوزه خاص (مثل Rossum) انتخاب کنید. اثر مرتبه دوم این است که «بررسی انسانی» (Human-in-the-loop) دیگر نشانهی شکست هوش مصنوعی نیست، بلکه یک جزء معماری اجباری برای هر سیستمی است که نمیتواند خطای دادهی خاموش را در پایگاه داده تحمل کند.
اگر شما فقط در حال پردازش ساختار یک فروشنده هستید که سالهاست تغییر نکرده، هیچکدام از این ابزارها ارزش هزینه ندارند؛ یک اسکریپت ساده Regex کارآمدتر است. این پلتفرمها تنها زمانی بهصرفه میشوند که تنوع اسناد به یک کابوس نگهداری تبدیل شود — یعنی زمانی که ساختار فروشنده دوم با اولی یکی نباشد، یا نوع سومی از سند ظاهر شود که موتور قوانین شما نتواند آن را مدیریت کند.
برای انتخاب ابزار درست، تست با تمیزترین PDFهای خود را متوقف کنید. نامرتبترین، لکهدارترین و قدیمیترین اسنادتان را وارد دوره آزمایشی کنید؛ ابزاری که از تست «بدترین حالت» جان سالم به در ببرد، تنها ابزاری است که ارزش چرخه تدارکات و خرید را دارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو