
یک عامل (Agent) کدنویس میتواند تغییری بینقص برای یک وظیفه خاص ارائه دهد، اما در همان لحظه بهطور خاموش کل سیستم پرداخت شما را از کار بیندازد. شکاف میان «تکلیف موفق» و «انتشار ایمن»، دقیقاً همان جایی است که اکثر رگرسیونهای (Regressions) کد تولیدشده توسط هوش مصنوعی پنهان میشوند.
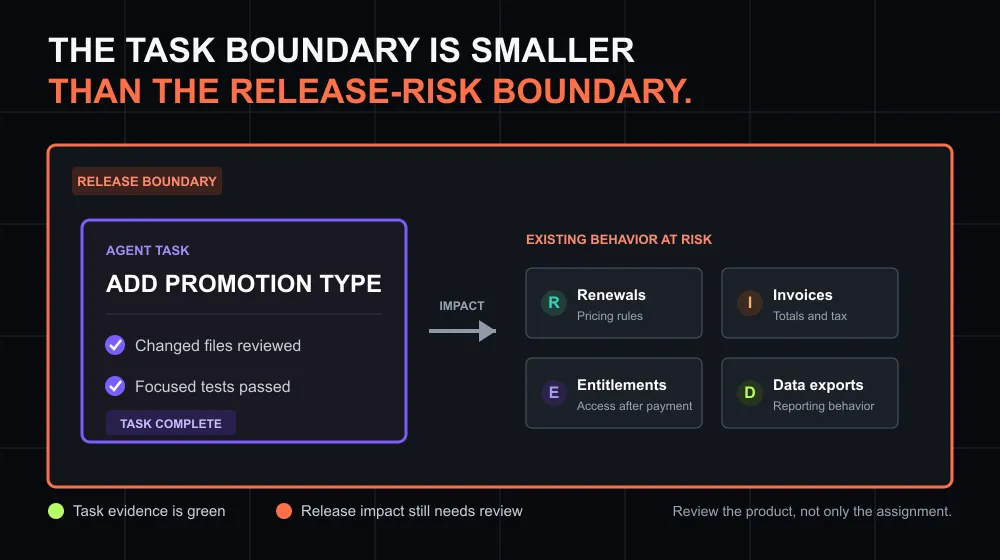
تصور کنید یک برنامهنویس از یک عامل میخواهد نوع جدیدی از تخفیف را به سرویس مشترک تخفیفات اضافه کند. وظیفه کوچک به نظر میرسد؛ عامل یک نقطه اتصال API را تغییر میدهد، تستهای متمرکزی مینویسد و یک Diff تمیز برمیگرداند. اما در حالی که تمام جزئیات تکلیف درست است، این تغییر ممکن است قیمت تمدیدها، مجموع فاکتورها یا گزارشهای مالی را که به همان سرویس وابستهاند، بههم بریزد. این مشکل اصلی بررسی کدها صرفاً در مرز تکلیف است.
همانطور که در تحلیل قبلی ما دربارهی فروپاشی پایگاههای کد بدون کفِ معماری اشاره کردیم، صنعت اکنون در حال چرخش به سمت «مرز اعتبارسنجی» است. وقتی یک عامل سرویس مشترکی را تغییر میدهد، اثرات آن بهندرت به همان فایلهایی محدود میشود که لمس کرده است. پیادهسازی در Pull Request دیده میشود، اما پیامدهای آن در سراسر محصول پخش میشود.
به نقل از راهنمای کاربردی منتشرشده در dev.to در ۲۴ اوت ۲۰۲۶، تکیه بر یک سیگنال مثبت — مثل سبز شدن تستها — برای اطمینان از محیط عملیاتی کافی نیست. مشکل این است که عاملها با زمینه (Context) محدودی کار میکنند: یک پرامپت، دستورالعملهای مخزن، فایلهای منتخب و تستهای شناختهشده. این زمینه ممکن است شامل تمام جریانهای تجاری که به رفتار تغییریافته وابسته هستند، نباشد.
شکاف زمینهای
ابزارهای بررسی متداول نیز همین محدودیت مرزی را دارند:
- Diffها فقط تغییرات مخزن را نشان میدهند.
- مجموعه تستها فقط نشان میدهند که انتظارات کدگذاریشده برآورده شدهاند.
- تحلیل ایستا (Static Analysis) فقط نقض قوانین منتخب را میگوید.
- اسکنرهای امنیتی فقط کلاسهای شناختهشده از مشکلات را مییابند.
هر یک از این سیگنالها ارزشمندند، اما هیچکدام ثابت نمیکنند که تمام رفتارهای موجود محصول دستنخورده باقی ماندهاند. طبق دستورالعمل استفاده مسئولانه GitHub برای عاملهای کدنویس، مرز انسانی صریح است: خروجیهای تولیدشده همچنان به بررسی و تایید نیاز دارند. موفقیت در یک تکلیف، به معنای اطمینان برای انتشار نیست. این رویکرد با این ایده همسو است که ارزیابی رفتار باید جایگزین اعتبارسنجی صرفِ کد شود تا نقصهای منطقی شناسایی شوند.
چارچوب اعتبارسنجی
برای پر کردن این شکاف، بازبینها باید پیش از تایید هر انتشار، پنج لایه شواهد مجزا را پیاده کنند. این فرآیند از «نیت تکلیف» شروع شده و از «مقایسه رفتاری» میگذرد تا در نهایت تصمیم انتشار گرفته شود.
۱. ابتدا نیت را تعریف کنید: پیش از نگاه به کد، نتیجه مورد انتظار و مرزهایی که نباید تغییر کنند را بنویسید. با تغییر مورد نظر شروع کنید، نه پیادهسازیای که عامل تولید کرده است. برای تغییر سرویس تخفیف، یعنی صراحتاً از قوانین تمدید، مجوزها و رفتار گرد کردن اعداد محافظت کنید تا عامل بهطور خاموش تکلیف را بازتعریف نکند.
یک بیانیه نیت کاربردی باید به چهار پرسش پاسخ دهد:
- کدام نتیجه برای کاربر یا سیستم باید تغییر کند؟
- کدام رفتارهای موجود باید بدون تغییر بمانند؟
- کدام رابطها، قوانین داده یا مرزهای امنیتی اعمال میشوند؟
- در صورت ابهام در الزامات، تصمیم نهایی با کیست؟
۲. سوابق کاری را بازرسی کنید: Diff نهایی تنها بخشی از سطح است. بازبینها باید سوابق کاری عامل را بررسی کنند: پرامپت، دستورالعملهای مخزن، فایلهای خواندهشده، دستورات اجراشده، تستهای منتخب و فرضهای مدل. برای درک عمیقتر این لایه، میتوان به مقایسهی تاریخچه کامل جلسات در برابر بررسی Diff اشاره کرد که نشان میدهد چگونه ردیابی مسیر تفکر عامل از انحراف نیت جلوگیری میکند.
این سوابق صحت کد را ثابت نمیکند، اما مرز آنچه عامل در نظر گرفته را نشان میدهد. برای مثال، تغییر درست در محاسبه تخفیف همچنان نیاز به بررسی بیشتر دارد اگر عامل هرگز کدهای تمدید یا تولید فاکتور را بررسی نکرده باشد. نبودِ زمینه، دلیلِ وجود نقص نیست، اما شواهدی است بر جایی که عدم قطعیت باقی مانده است.
بازبینها باید به دنبال حالتهای شکست آشنا باشند:
- دسترسی نادرست به دادهها یا مجوزها.
- مدیریت ناقص خطاها.
- تغییرات غیرمنتظره در Schema یا لایه ذخیرهسازی.
- تغییراتی که از محدوده درخواست فراتر رفتهاند.
- تغییر تستها صرفاً برای از بین بردن خطاها.
- فرضهایی که با قوانین محصول در تضاد هستند.
۳. کنترلهای بازتولیدپذیر را اجرا کنید: بیلدها، بررسیهای تایپ، Linterها، چکهای امنیتی و تستهای واحد، یکپارچگی و End-to-End را اجرا کنید. تستهای متمرکزی برای معیارهای پذیرش و مسیرهای خطای مهم اضافه کنید. در این مرحله، استفاده از بنچمارکهای اختصاصی ساخته شده از تاریخچه Git میتواند دقت تستهای بازتولیدپذیر را بهشدت افزایش دهد.
بسیار حیاتی است که هر شکست توسط انسان بررسی شود و سپس نتیجه مورد انتظار تغییر کند. یک تست شکستخورده میتواند نشانه تغییر عمدی در محصول، یک ادعای قدیمی یا یک رگرسیون واقعی باشد. عامل میتواند در بررسی علت کمک کند، اما نباید بهطور خاموش تست را بازنویسی کند تا وضعیت سبز شود. ثبت کنید چه چیزی اجرا شد و چه چیزی نادیده گرفته شد؛ زیرا عبارت «تمام تستها پاس شدند» شواهد ضعیفی است اگر تستهای مرتبط اصلاً شناسایی نشده باشند.
۴. جریانهای تجاری متأثر را ترسیم کنید: از توابع به سمت رفتار محصول حرکت کنید. یک سرویس مشترک ممکن است جریانهای مشتری، مالی و گزارشدهی را در جاهای دیگر لمس کند. مرز اثرگذاری بهندرت با مرز فایلهای تغییریافته یکی است.
برای تغییر تخفیف، نقشه جریانهای متأثر میتواند شامل این موارد باشد:
- ایجاد اشتراک با تخفیف.
- تمدید اشتراک موجود.
- ترکیب تخفیفات حساب و کمپین.
- محاسبه مجموع فاکتور و مالیات.
- اعمال مجوزها پس از پرداخت.
- استخراج دادههای تخفیف برای گزارشدهی.
از مستندات معماری و تخصص دامنه برای ساخت این نقشه استفاده کنید. این فرآیند اغلب شکافهای مالکیت را آشکار میکند؛ مثلاً وقتی تغییرات پرداخت توسط کسی تایید میشود که مالک منطق پرداخت نیست.
۵. مقایسه با خطمبنای عملیاتی: بهجای تکیه بر سناریوهای پیشبینیشده، رفتار نسخه کاندید را با خطمبنای (Baseline) محیط عملیاتی مقایسه کنید. این میتواند رفتار ثبتشده واقعی یا یک مرجع کنترلشده باشد.
تفاوتها را دستهبندی کنید بهجای اینکه آنها را در یک نتیجه کلی «پاس/فیل» ادغام کنید. برخی تفاوتها مورد انتظارند چون تکلیف عمداً رفتار را تغییر داده است؛ برخی دیگر اثرات ناخواسته را فاش میکنند. این روش بهویژه زمانی مفید است که تغییر کد محلی است اما اثر محصول گسترده؛ مثلاً تخفیف جدید کار میکند اما مسیر تمدید موجود اکنون مبلغ متفاوتی محاسبه میکند. توجه داشته باشید که خطمبناها محدودیت دارند: محیط عملیاتی ممکن است نقصهای قدیمی داشته باشد و دادههای تست لزوماً نماینده تمام وضعیتهای مشتریان نباشند.
ماتریس شواهد
تیمها اغلب این بررسیها را در یک وضعیت کلی ادغام میکنند، اما این راهنما استدلال میکند که هیچ لایهای جایگزین لایه دیگر نیست. سوابق کاری کامل جایگزین تستها نمیشود و تستهای سبز جایگزین تحلیل اثرگذاری نمیشوند.
| لایه شواهد | پرسشی که پاسخ میدهد |
|---|---|
| نیت | چه چیزی باید تغییر کند و چه چیزی باید ثابت بماند؟ |
| سوابق کاری | عامل چه چیزهایی را بررسی، فرض، اجرا و تغییر داد؟ |
| کنترلها | کدام قوانین و سناریوهای شناختهشده پاس یا فیل شدند؟ |
| نقشه جریان | کدام نتایج موجود محصول ممکن است به این تغییر وابسته باشند؟ |
| خطمبناها | تفاوت بین نسخه کاندید و خطمبنای فعلی چیست؟ |
تحلیل: چرخش در مسئولیت انسانی
این چارچوب نقش بازبین انسانی را از یک «بررسیکننده کد» به یک «مدیر ریسک» تغییر میدهد. در دنیای کدنویسی عاملمحور، گلوگاه دیگر سرعت پیادهسازی نیست، بلکه سرعت اعتبارسنجی است.
برای توسعهدهنده عملیاتی، این یعنی فرهنگ LGTM (به نظر من خوب است) مرده است. استاندارد جدید، یک سوابق انتشار است که صراحتاً ذکر میکند کدام شکافها اعتبارسنجی نشدهاند و چه کسی مسئول تصمیم برای انتشار با وجود این عدم قطعیت است. تصمیم نهایی انسانی و پاسخگو باقی میماند. مالک کد پیش از تایید باید بپرسد: آیا پیادهسازی نیت را برآورده کرد؟ کدام جریانهای تجاری متأثر شدند؟ کدام تفاوتها با خطمبنا مورد انتظار است و چه کسی آنها را تایید کرد؟
با جداسازی خروجی عامل از تصمیم انتشار، تیمها میتوانند از سرعت AI بهره ببرند بدون اینکه «کوریِ AI» را به ارث ببرند. یک عامل میتواند شواهد را جمعآوری و یافتهها را خلاصه کند، اما نباید زمینه ناقص را به تایید خودکار تبدیل کند. هدف این است که تغییر در سطحی اعتبارسنجی شود که ریسک در آنجا وجود دارد: سطح محصول، نه سطح فایل.
گام بعدی شما
- برای هر Pull Request تولیدشده توسط AI، پیش از باز کردن کد، یک «بیانیه نیت» (Intent Statement) اجباری تعریف کنید.
- یک نقشه جریانهای تجاری (Business Flow Map) برای سرویسهای مشترک و حساس خود رسم کنید تا مرز اثرگذاری تغییرات مشخص شود.
- فرآیند تایید کد را از بررسی خطبهخط به بررسی ماتریس شواهد (نیت، سوابق، کنترل، جریان و خطمبنا) تغییر دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو