اگر برای ساخت کمیک، آواتارهای VTuber یا شخصیتهای اورجینال (OC) به هوش مصنوعی تکیه میکنید، یک تصویر زیبا هرگز کافی نیست. تولید یک تکتصویر با کیفیت بالا، سادهترین کاری است که یک هوش مصنوعی میتواند انجام دهد، اما برای یک خالق اثر، این کمارزشترین معیار سنجش است. چالش واقعی اینجاست که آیا شخصیت شما میتواند در تصویر دوم هم همان چهره و لباس را داشته باشد یا با هر بار تولید، به فردی جدید تبدیل شود؟ به عبارت دیگر، آیا شخصیت میتواند بدون تغییر در چهره یا لباس، از یک نسل تولید به نسل بعدی منتقل شود؟
به نقل از راهنمای عملی منتشر شده در ۹ سپتامبر ۲۰۲۶ در وبسایت dev.to، تفاوت میان یک «اسباببازی» و یک «ابزار حرفهای» در نحوه مواجهه با ۵ حالت شکست (Failure Mode) مشخص است. برای بررسی این موضوع، نویسنده مدل Tsubaki.3 در پلتفرم PixAI (یک تولیدکننده تخصصی انیمه) را با شخصیتی به نام «هانا» تست کرد. هانا یک شخصیت اورجینال (OC) است: زنی جوان در اوایل دهه بیست زندگیاش با موهای بلوطی تیره که به صورت یک بافت شل بسته شده، چشمهای عسلی گرم، لبخندی مهربان، یک پیشبند بوم سبز روی پیراهن کتانی کرم با آستینهای بالا زده، و یک کلید برنجی کوچک که با بند به گردنش آویزان است.
همانطور که در تحلیلهای قبلی ما دربارهی شکافهای عملکردی در ابزارهای اتوماسیون — مانند ۱۰ شکاف بحرانی که در مقیاس Playwright Python AI شناسایی کردیم — اشاره کردیم، در هنر زاینده نیز همین منطق حاکم است. شما نمیتوانید به گالریهای بازاریابی اعتماد کنید؛ زیرا گالریهای یک ژنراتور انیمه معمولاً تصاویری تقریباً بینقص با شخصیتهای صیقلخورده و پسزمینههای منسجم را نشان میدهند. این تصاویر تایید میکنند که مدل میتواند خطوط و رنگهای خوبی تولید کند، اما ثابت نمیکنند که مدل میتواند دقیقاً همان چیزی را بسازد که شما میخواهید. شما باید توانایی مدل در حفظ هویت شخصیت را در صحنههای مختلف به شدت به چالش بکشید.
هوش مصنوعی زاینده (Generative AI) — شبیه نقاشی که میلیاردها اثر را دیده و حالا سعی میکند از روی توصیفات شما چیزی خلق کند — در سبک انیمه با چالشهای متفاوتی روبروست. پیش از هر چیز باید درک کنیم چرا مدلهای تصویرساز عمومی اغلب در سبک انیمه شکست میخورند. مدلهای عمومی برای توصیف دنیای فیزیکی ساخته شدهاند؛ آنها روی نحوه تابش نور و نحوه افتادن پارچه تمرکز میکنند تا به رئالیسم عکاسانه برسند. اما انیمه بر اساس این معیار قضاوت میشود که آیا «دستکشیده» به نظر میرسد یا «رندر شده».
- استایل به عنوان یک مجموعه قانون: انیمه از رنگهای تخت (Flat Color)، خطوط محیطی مشهود (Outlines) و باندهای تمیز سایهزنی استفاده میکند. اینها انتخابهای هنری هستند، نه نحوه رفتار واقعی نور در طبیعت. مدلهای عمومی اغلب این ویژگیها را به عنوان «خطا» میبینند و سعی میکنند آنها را نرم کنند، که نتیجه آن ظاهری براق و رندر شده است که صرفاً یک مدل مو را قرض گرفته است. برای مثال، مدل Tsubaki.3 در PixAI رنگهای تخت و خطوط تمیز را حفظ میکند، در حالی که مدل عمومی مانند ChatGPT همان صحنه را شبیه به یک عکس رندر میکند.
- هویت در جزئیات کوچک: در انیمه، هویت به نشانگرهای خاصی گره خورده است (مانند کلید برنجی هانا یا جهت بافت موهایش). اینها اولین چیزهایی هستند که در یک مدل عمومی از پرامپت حذف میشوند.
- نیاز به تکرار: برخلاف یک اثر هنری تکتصویری، یک کمیک نیاز دارد که یک چهره در دهها پنل تکرار شود و یک کانال VTuber نیاز دارد که آواتار یکسانی در هر تامنیل داشته باشد. بنابراین، یک تصویر خوب هرگز هدف نهایی نیست.
کیفیت مدل در برابر رزولوشن
بسیاری از کاربران رزولوشن بالا را با کیفیت مدل اشتباه میگیرند. در واقعیت، کیفیت در هوش مصنوعی انیمه به این معناست که مدل چگونه کادربندی و استایل پرامپت را تفسیر میکند. برای تست این موضوع، نویسنده از یک پرامپت بسیار مفصل استفاده کرد که هانا را روی یک میز کار باغبانی در یک گلخانه آفتابی قرار میداد، در حالی که توسط گلدانهای سفالی، سینیهای نهال، گوجهفرنگی، هویج، لیمو و دستههای سیر آویزان احاطه شده بود. در پرامپت صراحتاً درخواست شده بود: «cel shading تمیز، استایل انیمه، شاهکار، بهترین کیفیت، absurdres».
هنگام اجرای این پرامپت، دو مدل مختلف نتایج کاملاً متفاوتی تولید کردند. مدل Tsubaki.3 (که برای خروجیهای با رزولوشن بالاتر همراه با کنترلهای پالت و مرجع ساخته شده) یک نمای باز (Wide Shot) با لایهبندی فضایی واقعی ارائه داد و هانا را به طور واضح بین برگهای پیشزمینه و پسزمینه گلخانه قرار داد. همچنین رنگ موهای او را به درستی بلوطی نگه داشت. اما مدل Tsubaki.2 (که برای مدیریت پرامپت و آناتومی تنظیم شده بود) یک پرتره نمای نزدیک با پرداخت براقتر تولید کرد. نکته حیاتی این بود که Tsubaki.2 موهای بلوطی هانا را تقریباً سیاه رندر کرد؛ این نشان میدهد که یک ویژگی شخصیتی میتواند حتی اگر تصویر «با کیفیت بالا» به نظر برسد، ناپدید شود.
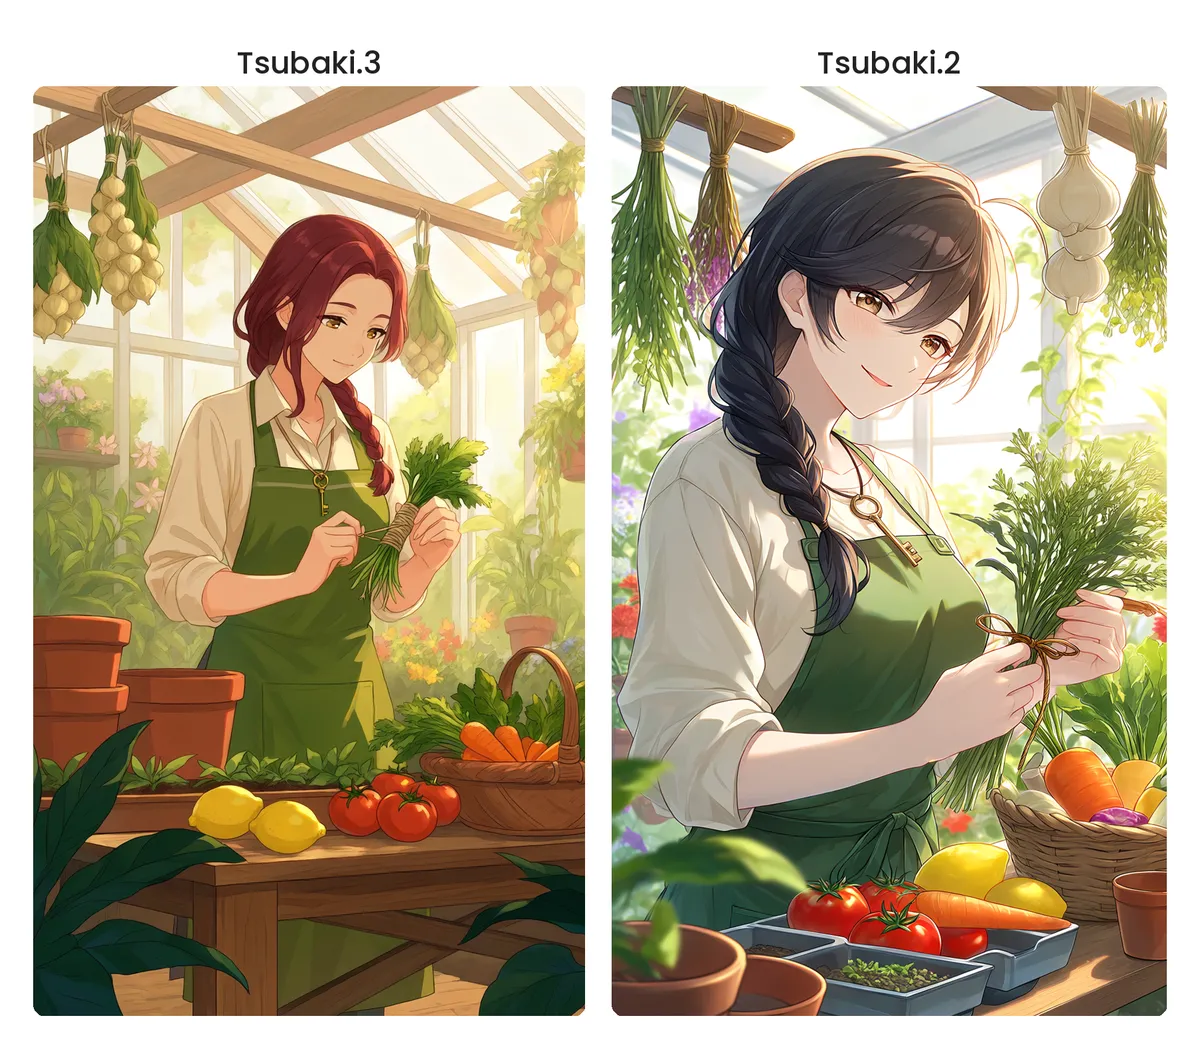
این موضوع ثابت میکند که تغییر مدل اغلب سریعتر از بازنویسی پرامپت است. پلتفرم PixAI میزبان هزاران مدل رسمی و جامعهمحور است که به کاربران اجازه میدهد بدون تغییر متن، تنها با تغییر مدل، از یک ظاهر رترو و تخت به یک استایل نقاشانه تغییر مسیر دهند. این یک تمایز حیاتی است: ظاهر رترو نتیجهی یک مدل متفاوت است، نه یک پرامپت متفاوت.
شکاف صفتها و پیروی از دستور
یک تصویر میتواند زیبا باشد اما نیمی از دستورات شما را نادیده بگیرد. برای تست پیروی از دستور (Prompt Following)، نویسنده تعداد جزئیات خاص (حدود ۲۰ مورد) در پرامپت گلخانه را شمرد تا ببیند چند مورد در تصویر نهایی ظاهر شدهاند.
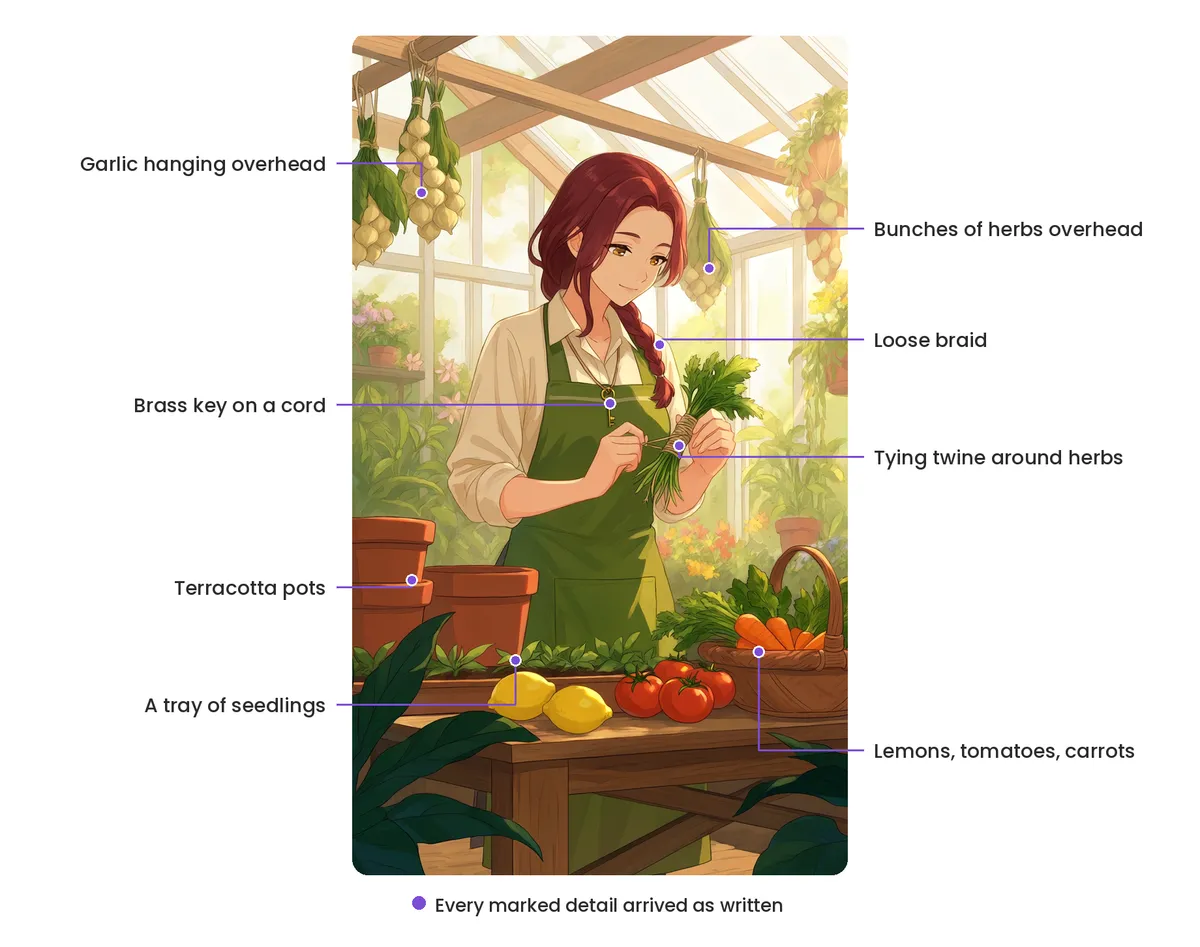
در حالی که Tsubaki.3 تقریباً تمام اسمها — کلید برنجی، بافت مو، سینی نهال و محصولات کشاورزی — را ثبت کرد، اما در مواجهه با صفتها دچار مشکل شد. برای مثال، «گیاهان خشک» به صورت تازه و سبز رندر شدند. این اتفاق به این دلیل رخ میدهد که مدلها پرامپتها را به تگهای کوتاهتر تبدیل میکنند. عبارتی مانند «دستههای سیر آویزان از تیرهای سقف» کوتاه میشود و اصلاحکنندههای توصیفی که دور اسم پیچیدهاند، بیشترین احتمال تغییر یا جابجایی را دارند.
این موضوع پیشنهاد میکند که برای رسیدن به یک ظاهر خاص، خالقان اثر باید ظاهر بصری را به طور کامل شرح دهند، به جای اینکه تنها به یک صفت تکیه کنند. اسمها قابل اعتماد هستند، اما صفتها برای اینکه به درستی اعمال شوند، به چیزی بیشتر از یک کلمه چسبیده به شیء نیاز دارند.
تست ثبات شخصیت
ثبات شخصیت مرز میان یک تولیدکننده «تصویر زیبا» و ابزاری است که میتوان روی آن یک پروژه کامل ساخت. صرفاً تکرار توصیفات متنی معمولاً منجر به خلق دو زن متفاوت میشود که اتفاقاً لباسهای مشابهی پوشیدهاند. در تست اولیه، همان توصیفات در یک تصویر چهرهای گردتر و در تصویر بعدی فکی باریکتر ایجاد کرد؛ همچنین کلاه از حالت عقبرانده شده به حالت آویزان پشت شانه تغییر یافت.
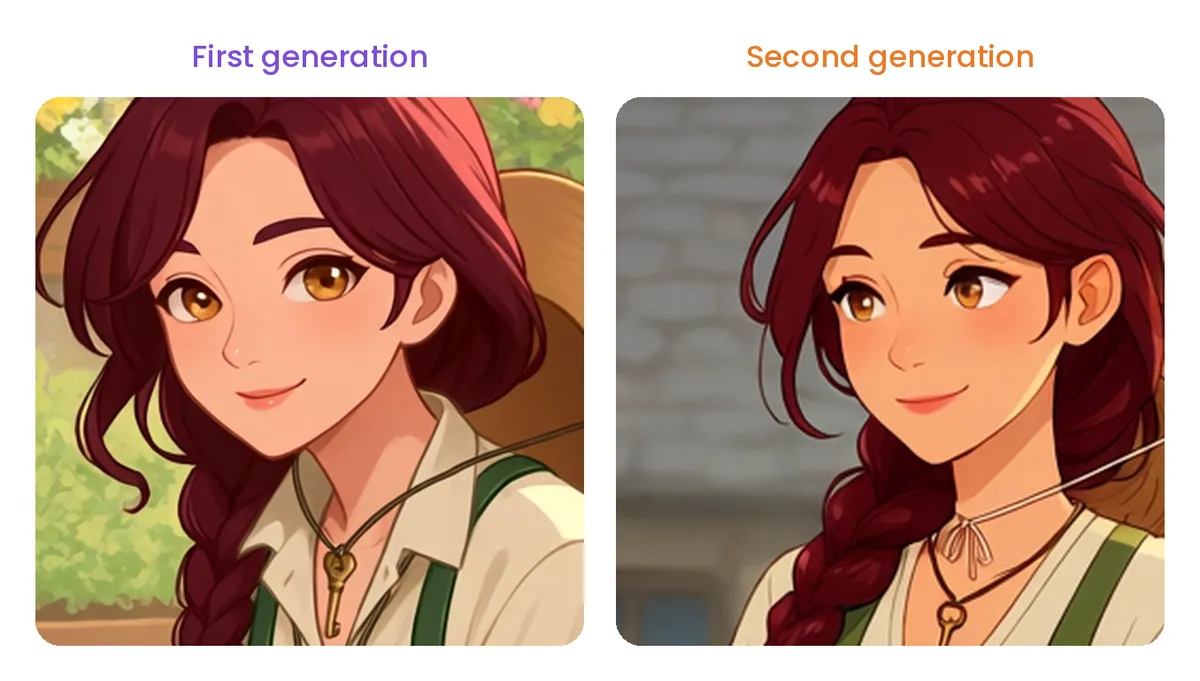
برای حل این مشکل، نویسنده از یک تصویر مرجع (Reference Image) از هانا استفاده کرد. با بارگذاری یک تصویر در اسلات مرجع و تغییر دادن تنها توصیف صحنه، مدل توانست چهره، بافت مو و کلید برنجی او را در سه محیط متمایز حفظ کند:
- صحنه عصرگاهی: نشستن روی پلههای یک کلبه با سبدی از تخممرغ در کنارش.
- تست آب و هوا: راه رفتن در یک کوچه بارانی با چتر و سنگفرشهای خیس. این تست سختتری است زیرا باران هم نور تابیده شده به شخصیت و هم دنیای اطراف او را تغییر میدهد.
- تست فعالیت: ایستادن پشت یک غرفه بازار در حال مرتب کردن جعبههای گوجهفرنگی، هویج، سیب و سبزیجات برگدار.
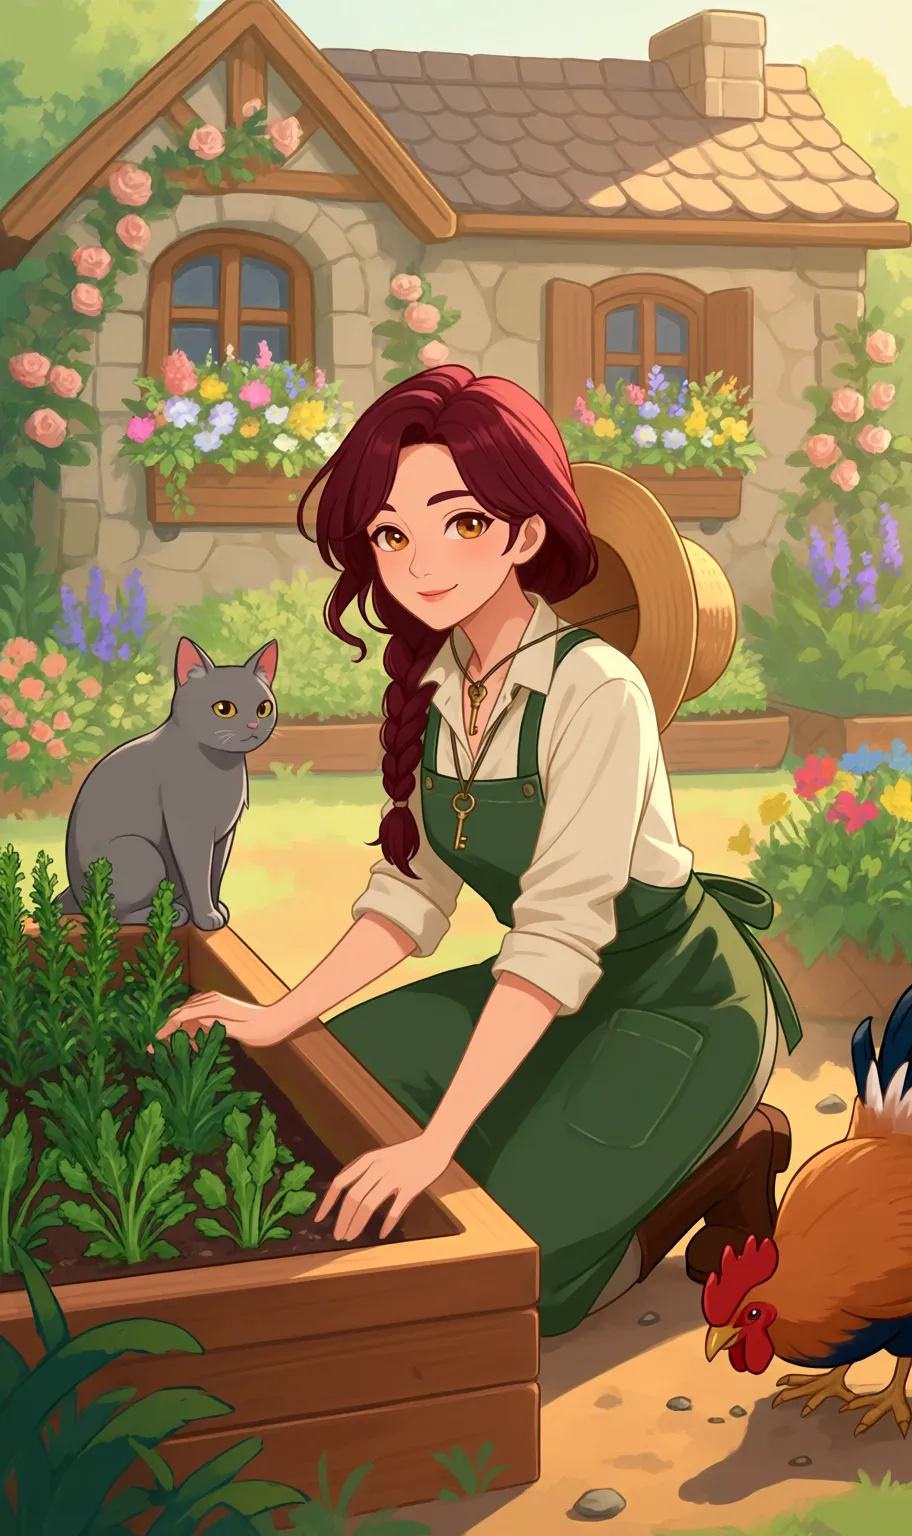
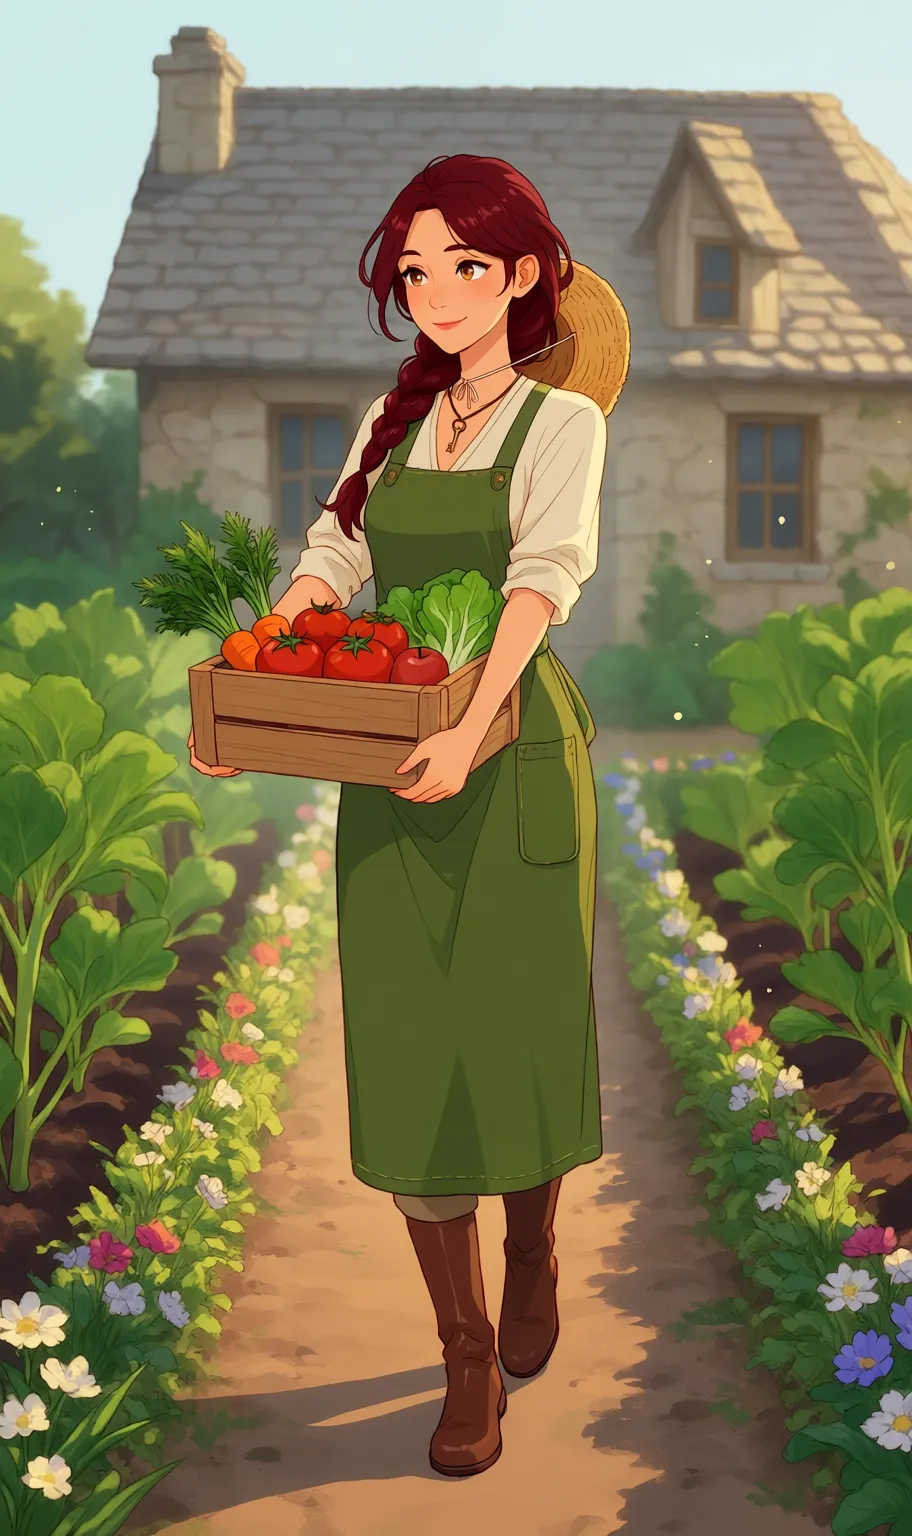
با این حال، تصاویر مرجع مانند لنگر عمل میکنند، نه قفل. در حالی که چهره ثابت ماند، ساختار پیشبند هانا در نماهای تمامقد گاهی به یک لباس کامل تبدیل شد. این نشان میدهد که ساختار لباس نسبت به هویت چهره، پایداری کمتری دارد. یک تصویر مرجع، چهره را بسیار مطمئنتر از ساختار یک لباس حفظ میکند.
لورا در برابر تصاویر مرجع
برای پروژههای بلندمدت، این راهنما بین سه مکانیزم کنترل تمایز قائل میشود:
- مدلها (Models): قابلیت کلی و استایل را تعریف میکنند (مثلاً Tsubaki.3 در برابر Tsubaki.2). مدل تعیین میکند که ژنراتور در وهله اول در چه کاری مهارت دارد.
- تصاویر مرجع (References): یک لنگر بصری سریع برای شخصیت بدون نیاز به تنظیمات اولیه فراهم میکنند؛ این روش برای شخصیتهایی که هنوز در مرحله تست هستند بهترین است. مرجع، شخصیت را لنگر میکند، نه صحنه را.
- لورا (LoRAs - Low-Rank Adaptation): مدل را با استفاده از مجموعهای از تصاویر (Dataset) با یک شخصیت خاص آموزش میدهد و اجازه میدهد شخصیت از طریق یک «کلمه فعالکننده» (Trigger Word) فراخوانی شود. این کار نیاز به آپلود تصویر مرجع در هر بار تولید را از بین میبرد.
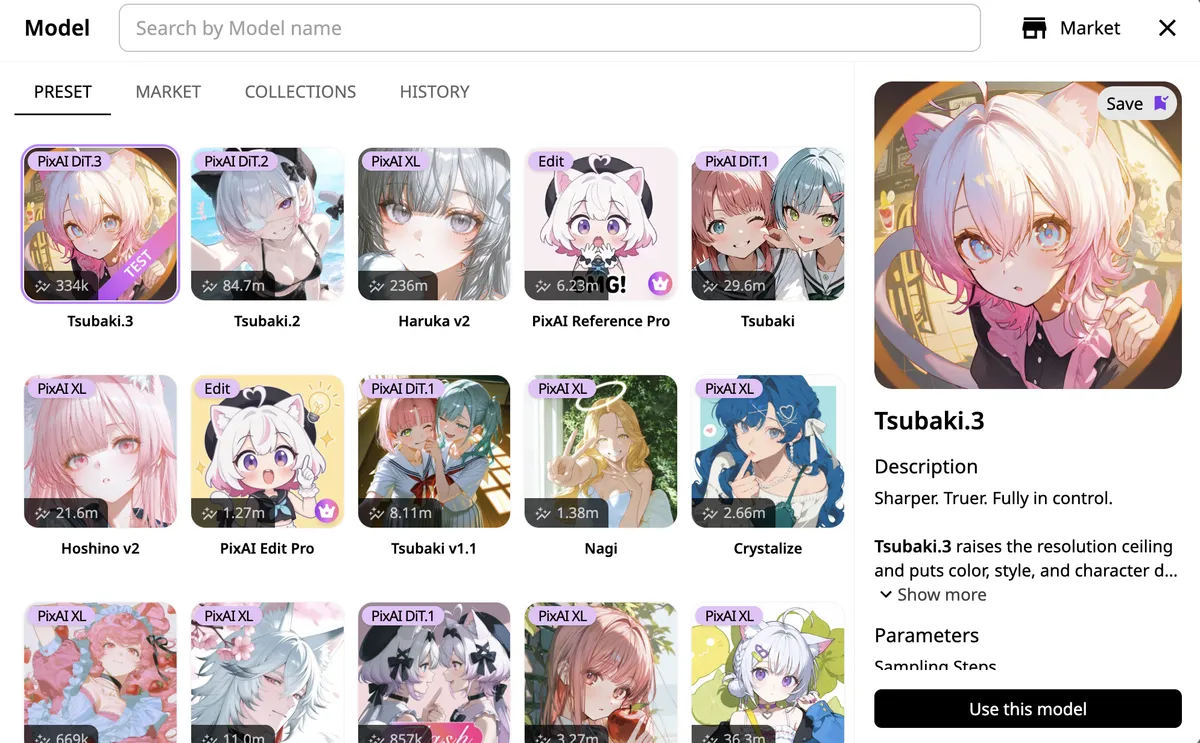
برای ایجاد یک لورا برای هانا، نویسنده ۱۴ تصویر جمعآوری کرد، شامل نماهای نزدیک (Close-ups)، نماهای پشت و فصول مختلف تا اطمینان حاصل شود که مدل شخصیت را از زوایای متعدد یاد گرفته است. هشت مورد از این تصاویر زوایای خاصی را پوشش میدادند تا از تلهی «پرترههای تقریباً یکسان» اجتناب شود، زیرا پرترههای مشابه چیز زیادی به مدل یاد نمیدهند. تنوع در مجموعه داده — فواصل و محیطهای مختلف — همان چیزی است که بیشترین امکانات را در اختیار مدل قرار میدهد.
یک جزئیات فنی حیاتی، جفتسازی معماری است. لورایی که برای DiT.2، DiT.1، SDXL یا SD 1.5 آموزش دیده باشد، با Tsubaki.3 کار نخواهد کرد زیرا مدل اخیر روی DiT.3 اجرا میشود. کاربران باید مطمئن شوند که هدف آموزش (Training Target) با مدل تولید مورد نظرشان مطابقت دارد. برای شخصیتی که قرار است ماهها استفاده شود، زمان صرف شده برای ساخت لورا میارزد؛ اما برای یک شخصیت آزمایشی، تصویر مرجع سریعتر است.
تست استرس ویرایشی
تولید مجدد یک تصویر از صفر اغلب جزئیاتی را که واقعاً دوست داشتید از بین میبرد. ویرایش واقعی به شما اجازه میدهد یک المان را تغییر دهید در حالی که بقیه موارد را قفل میکنید. این موضوع زمانی که چهره شخصیت بالاخره درست شد، حیاتی است، زیرا اجازه میدهد تغییرات در حالت چهره یا لباس بدون ریسک از دست دادن آن هویت سختبهدستآمده اعمال شود.
در یک مورد تست، نویسنده از هوش مصنوعی خواست تا «سبد تخممرغ» را به «سبد سیب» تغییر دهد در حالی که چهره، ژست و نورپردازی یکسان بماند. پرامپت صراحتاً به هوش مصنوعی دستور داد که چهره، مو، بافت مو، پیشبند، پیراهن، کلید برنجی، ژست، کلبه و نورپردازی را دقیقاً همانطور که بودند نگه دارد. مدل با موفقیت شیء را جایگزین کرد بدون اینکه هویت شخصیت، گلهای روی دیوار کلبه یا نور غروب را تغییر دهد.
این ثابت میکند که ویرایش (Editing) انتخاب برتر برای «خطاهای نزدیک» است، در حالی که تولید مجدد (Fresh Generation) برای اصلاح خطاهای بنیادی در ترکیببندی یا ژست بهتر است. ویرایش زمانی بیشترین اهمیت را دارد که بخواهید نورپردازی را تغییر دهید یا جزئیاتی از لباس را اصلاح کنید بدون اینکه چهرهای را که سه بار برای رسیدن به آن تلاش کردهاید، به خطر بیندازید.
ارزیابی طرحهای رایگان
هنگام مقایسه پلتفرمها، این راهنما پیشنهاد میکند که تعداد کل اعتبارها را نادیده بگیرید و در عوض بررسی کنید که آیا طرح رایگان اجازه اجرای این ۵ تست را میدهد یا خیر. به طور خاص به دنبال این موارد باشید:
- نحوه عملکرد محدودیت: بررسی کنید که آیا محدودیت روزانه دارید، سهمیه ماهانه است یا اعتباراتی که شارژ میشوند. شما به فضای کافی نیاز دارید تا یک شخصیت را چندین بار تولید کنید، نه فقط یک یا دو بار.
- دسترسی به مدلها: آیا جدیدترین مدلها (مانند Tsubaki.3) در دسترس هستند یا پشت یک طرح پولی قفل شدهاند؟ این موضوع اگر بخواهید تست تغییر مدل را انجام دهید، حیاتی است.
- ابزارهای ویرایشی: آیا میتوانید ویرایشهای هدفمند انجام دهید یا مجبورید کل تصویر را دوباره تولید کنید؟
- دسترسی به آموزش: آیا آموزش لورا (LoRA Training) گنجانده شده است؟ توجه داشته باشید که هزینههای آموزش اغلب جدا از هزینههای تولید است و به نوع مدل بستگی دارد.
- اندازه تصاویر: آیا میتوانید تصاویر با اندازه کامل تولید کنید یا فقط پیشنمایشهای کوچکی که نقصهای مدل را میپوشانند در دسترس است؟
طرح رایگان PixAI اعتبارات روزانهای را فراهم میکند که مدلهای جامعهمحور، ابزارهای ویرایش و ارتقای تصویر و آموزش لورا را پوشش میدهد، که برای اجرای تمام این ۵ تست حالت شکست کافی است.
خلاصه اولویتهای خالق اثر
بسته به نوع پروژه، تستهای مختلف وزن متفاوتی دارند:
- تکتصویر (Illustration): کیفیت مدل و پیروی از دستور را در اولویت قرار دهید. هدف، پلتفرمی است که بتواند خوب رسم کند.
- شخصیت تکرار شونده: ثبات شخصیت و تصاویر مرجع را در اولویت قرار دهید. هدف، پلتفرمی است که بتواند به خاطر بسپارد.
- پروژه بلندمدت: آموزش لورا و ابزارهای ویرایشی را در اولویت قرار دهید. هدف، پلتفرمی است که به شما اجازه دهد چیزی قابل استفاده مجدد بسازید.
این تغییر در متدولوژی تست، تمرکز را از «آیا میتواند یک تصویر زیبا بسازد» به «آیا میتواند منطق داخلی یک پروژه را حفظ کند» منتقل میکند. برای خالقان اثر، بهترین ابزار آن نیست که گالری چشمگیرتری دارد، بلکه ابزاری است که اجازه میدهد یک شخصیت دقیقاً همانطور که دیروز بود، امروز بازگردد.
برای اعمال این روش در گردش کار خود، شخصیتی با سه ویژگی منحصربهفرد انتخاب کنید و سعی کنید او را در سه شرایط نوری مختلف با استفاده از یک تصویر مرجع تولید کنید.
اما داستان سختافزاری پشت این مدلهای انتشار حتی پیچیدهتر است — به تحلیل ما دربارهی معماری DiT در گزارشهای آینده مراجعه کنید.



گفتگو