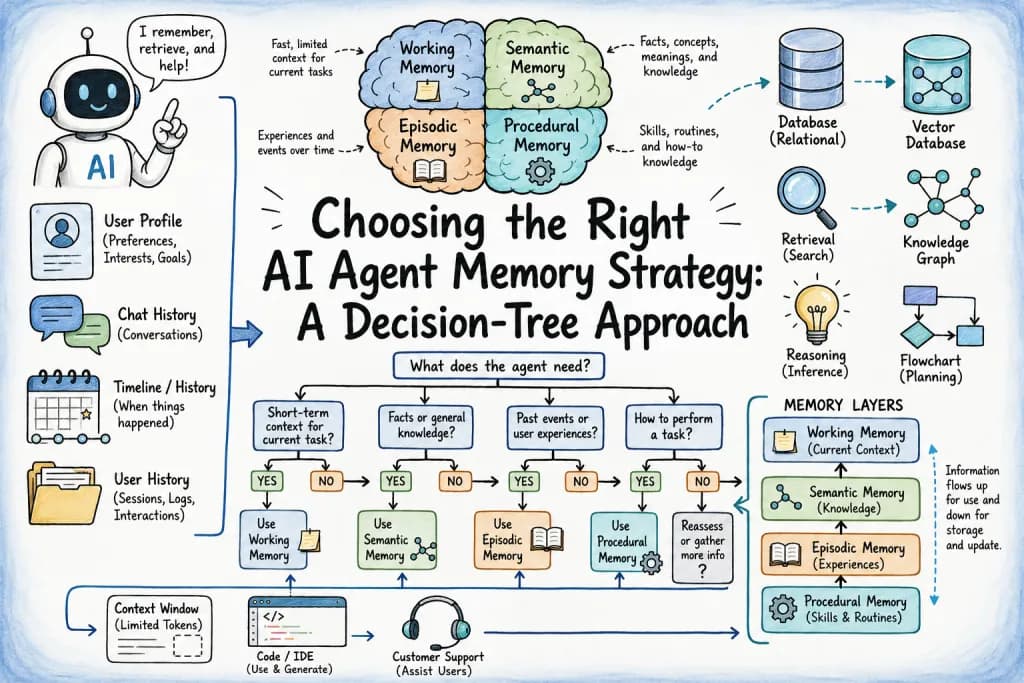
تصور کنید یک برنامهنویس ماهها وقت صرف ساخت یک عامل هوش مصنوعی میکند، اما محصول نهایی یا نام کاربر را فراموش میکند یا زیر فشار یک پایگاهداده برداری غولپیکر سقوط میکند. این سریعترین مسیر برای شکست یک محصول است، مگر اینکه حافظه را به جای یک مخزن ساده، به عنوان یک لایه معماری آگاهانه طراحی کنید. برای متوقف کردن این رویکرد آزمون و خطا، وبسایت MachineLearningMastery.com در ۱۱ ژوئیه ۲۰۲۶، چارچوبی را تشریح کرد که در آن با حافظه به عنوان یک لایه معماری عمدی برخورد میشود، نه به عنوان یک فکر بدیع برای ذخیرهسازی در مراحل انتهایی پروژه.
اکثر توسعهدهندگان حافظه یک عامل (Agent) را مانند یک سطل واحد میبینند، در حالی که انواع مختلف اطلاعات، طول عمر کاملاً متفاوتی دارند. این عدم تطابق باعث ایجاد «نشت حافظه» میشود؛ یعنی جایی که عامل ترجیحی را که کاربر تنها دو Turn پیش گفته بود، دوباره میپرسد. یا دچار «نویز بازیابی» میشود؛ جایی که یک ذخیرهساز برداری، حقیقتی منقضیشده از ۶ ماه پیش را بیرون میکشد که باید مدتها پیش بازنویسی میشد. سؤال اصلی طراحی این است: هر نوع اطلاعات باید چه مدت زنده بماند و چگونه بازیابی شود؟

همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی پنجرههای متنی اشاره کردیم، مدیریت درست زمینه (Context) کلید بهرهوری است. برای حل این مشکل، این چارچوب حافظه را به چهار لایه شناختی تقسیم میکند. این لایهها به پرسشهای متفاوتی درباره اطلاعات پاسخ میدهند و به همین دلیل است که اکثر عاملهای تجاری برای عملکرد درست، به بیش از یک لایه نیاز دارند.
چهار لایه اصلی حافظه
- حافظه کاری (Working Memory): — شبیه به تختهسیاه کوچکی است که فقط یادداشتهای ضروری لحظهای روی آن نوشته میشود — و بر این ایده استوار است که هر آنچه در حال حاضر مرتبط است، درون گفتگوی فعال و یک بودجه محدود توکن (Token) جای میگیرد. در اینجا فرض بر این است که هرس کردن یا خلاصهسازی Turnهای قدیمی، باعث حذف بیصدا اطلاعاتی نمیشود که عامل هنوز به آنها نیاز دارد.
- حافظه معنایی (Semantic Memory): — مثل یک دفترچه تلفن یا شناسنامه است که اطلاعات ثابت در آن ثبت شده — و فرض میکند برخی دادهها به اندازه کافی پایدار و قابل استفاده مجدد هستند. ذخیره یک نمایش استاندارد (Canonical) از اطلاعات، ارزشمندتر از این است که عامل هر بار آن را استنتاج کند یا دوباره از کاربر بپرسد. این لایه شامل حقایق دائمی کاربر (نام، نقش، زبان مورد علاقه)، دانش تخصصی دامنه (قوانین کسبوکار، مشخصات محصول) و دانش تعمیمیافتهای است که از تعاملات استخراج شده است.
- حافظه اپیزودیک/رویدادی (Episodic Memory): — شبیه به خاطرات یک روزه در دفترچه خاطرات است — و بر این باور است که تاریخچه اتفاقاتی که رخ داده، به خودی خود دارای ارزش است. این لایه سوابق تصمیمات گذشته، شکایات یا تراکنشهایی است که باید بر تعامل بعدی اثر بگذارد.
- حافظه رویهای (Procedural Memory): — مانند مهارت راندن ماشین است که بعد از تکرار، دیگر نیاز به فکر کردن به هر جزییات ندارد — و پیشفرض آن است که حل مکرر یک تسک با الگوی مشابه، باید عامل را در دفعات بعدی سریعتر یا قابلاعتمادتر کند، به جای اینکه صرفاً ترانسکریپتی از تلاشهای گذشته به جای بگذارد.

به عنوان مثال، یک عامل پشتیبانی مشتری ممکن است تیکت فعلی را در حافظه کاری، سطح اشتراک کاربر را در حافظه معنایی، شکایات پیشین را در حافظه اپیزودیک و یک روتین یادگرفتهشده برای بازپرداخت وجه را در حافظه رویهای نگه دارد. مشکل زمانی رخ میدهد که اطلاعات در لایه اشتباه ذخیره شوند. استفاده از یک ابزار جستوجوی معنایی (Vector Store) برای حقایق ثابتی که باید در یک پروفایل ساختاریافته باشند، بازیابی را کندتر و نامطمئن میکند. این چالش نشان میدهد که مدیریت حافظه در واقع بیشتر از آنکه یک قابلیت فنی باشد، مسئلهای در حوزه حکمرانی داده است تا از تداخل دادههای قدیمی و جدید جلوگیری شود. در مقابل، جستوجو در کل تاریخچه تعاملات ممکن است اطلاعات متناقض یا قدیمی را بیرون بکشد که یک رکورد ساختاریافته میتوانست آنها را بازنویسی کند.
برای مهندسی زمینه یا Context Engineering موثر، حافظه تنها یکی از منابعی است که برای تصاحب پنجره زمینه (Context Window) رقابت میکند. اطلاعات تنها زمانی باید بازیابی شوند که پاسخ عامل را بهطور معناداری بهبود بخشند، زیرا پنجره زمینه محدود است.
درخت تصمیم حافظه
مهندسی زمینه موفق مستلزم اجرای یک درخت تصمیم ۵ پرسشی برای هر دستهبندی از اطلاعات است که عامل هندل میکند. شما نمیتوانید این درخت را یک بار برای کل عامل اجرا کنید؛ بلکه باید آن را بهطور جداگانه برای هر دسته، مثلاً «وضعیت تیکت فعلی»، «پروفایل کاربر» و «تاریخچه تعاملات» اجرا کنید. درخت را برای هر دسته یک بار اجرا کنید تا مشخص شود آن اطلاعات خاص در کدام لایه قرار میگیرد.
پرسش ۱: آیا این اطلاعات باید فراتر از Turn فعلی باقی بمانند؟
این پرسش، اطلاعاتی که واقعاً نیاز به حافظه دارند را از مواردی که فقط شبیه به نیاز به حافظه به نظر میرسند، جدا میکند.
- خودکفا (بدون نیاز به حافظه): مانند عبارتبندی یک درخواست طبقهبندی یکباره یا خروجی میانی یک فراخوان ابزار (Tool Call) که فقط برای پاسخ به سوال فعلی استفاده شده است. پنجره زمینه همان Turn برای این موارد کافی است.
- سیر پیشرو (نیازمند حافظه): مانند اینکه عامل کدام مسئله را در این گفتگو حل کرده است، یا وضعیت یک پروژه کدنویسی که عامل از دیروز در حال ادامه آن است. اگر اطلاعات سیر پیشرو دارد، به پرسش ۲ بروید.
پرسش ۲: آیا این اطلاعات باید فراتر از یک جلسه (Session) زنده بمانند؟
این پرسش، حافظه کاری را از حافظه بادوام (Durable Memory) جدا میکند.
- فقط در طول جلسه: مواردی مانند اینکه چه چیزهایی قبلاً پرسیده شده، کدام ابزارها فراخوانی شدهاند و چه مواردی حل شدهاند. یک بافر گفتگو (Conversation Buffer) کافی است که با هرس کردن یا خلاصهسازی در محدوده توکنها نگه داشته شود. مدیریت حافظه مبتنی بر جلسه در OpenAI Agents SDK مستقیماً این مورد را هندل میکند.
- فراتر از جلسه: ترجیحات یک مشتری بازگشتی، وضعیت یک پروژه جاری، یا یک تسک چند روزه. حافظه کاری اینجا پاسخگو نیست زیرا اطلاعات باید مستقل از هر گفتگوی واحد وجود داشته باشند.
⚠️ یک اشتباه رایج در طراحی، عدم تطبیق اطلاعات با طول عمر آنهاست؛ مثلاً برخورد با وضعیتهای محدود به جلسه (Session-scoped state) به عنوان دادههای دائمی، یا ساخت زیرساختهای پیچیده و دائمی برای اطلاعاتی که فقط در طول یک گفتگو کاربرد دارند.

پرسش ۳: آیا این یک حقیقت ثابت است یا یک رویداد در حال تکامل؟
بیشتر شکستهای معماری اینجا رخ میدهند، زیرا توسعهدهندگان اغلب بدون توجه به شکل دادهها، همه چیز را در یک مخزن میریزند.
- حقایق ثابت (حافظه معنایی): نام، سطح اشتراک، لحن مورد علاقه یا آدرس ارسال پیشفرض. اینها نقاط دانش پایداری هستند که در تمام جلسات معتبر میمانند. این دادهها به عنوان حقایق استاندارد (Canonical) بسیار ارزشمندتر از آن هستند که هر بار استنتاج شوند.
- رویدادهای تکاملی (حافظه اپیزودیک): شکایتی که ماه پیش ثبت شده، تصمیمی که در فازهای اولیه یک پروژه گرفته شده، یا الگوی رفتاری در چندین تعامل متوالی.

معماریهای حافظه این واژگان را از علوم شناختی وام گرفتهاند تا دانش پایدار را از رویدادهای خاص گذشته جدا کنند. برخی چارچوبها بُعد زمانی را در لایه ذخیرهسازی ادغام میکنند. برای مثال، Zep حقایق را روی یک گراف دانش (Knowledge Graph) مدل میکند که در آن هر حقیقت دارای یک پنجره اعتبار است؛ این کار تضمین میکند حقیقتی که جایگزین شده است، باطل گردد تا با دادههای جدیدتر تناقض ایجاد نکند.
بسته به طبقهبندی، مکانیزم ذخیرهسازی تغییر میکند:
- حقایق ثابت متعلق به مخزن دانش پایدار هستند، مانند یک رکورد ساختاریافته برای ویژگیهای کاربر، یک گراف دانش برای روابط، یا یک پایگاهداده برداری برای دانش دامنه که به صورت معنایی قابل جستوجو باشد.
- رویدادهای تکاملی متعلق به چیزی شبیه به یک Log هستند، جایی که ورودیها انباشته میشوند و موارد قدیمی ممکن است نیاز به خلاصهسازی یا هرس شوند.
پرسش ۴: این حافظه چگونه بازیابی خواهد شد؟
هدف در اینجا تطبیق روش بازیابی با اندازه، ساختار و نرخ رشد مخزن است، به جای اینکه از یک استراتژی واحد برای همه جا استفاده شود.
- مخزن کوچک و محدود: اگر فقط تعداد محدودی حقیقت کاربر یا یک پروفایل واحد دارید، کل مخزن را در ابتدای جلسه بخوانید. ابزار حافظه Anthropic به این صورت عمل میکند زیرا مخزن به اندازه کافی کوچک میماند که خواندن کامل آن ارزان باشد.
- مخزن بزرگ و قابل جستوجو: برای تاریخچه تعاملات، مجموعههای سندی یا پایگاههای دانش در حال گسترش، تنها مرتبطترین ورودیها را با استفاده از جستوجوی معنایی (Semantic Search) یا بازیابی ترکیبی (Hybrid Retrieval) استخراج کنید. خواندن همه دادهها در مقیاس بالا غیرعملی است. Google’s Memory Bank برای این مقیاس طراحی شده است. چارچوبهای مستقل از ارائهدهنده مانند Mem0 نیز رویکردهای مشابهی را برای استفاده در LangGraph یا CrewAI ارائه میدهند.
بسیار رایج است که یک عامل به هر دو نیاز داشته باشد: یک خوانش کامل (Full-read) برای پروفایلهای کوچک در ذخیرههای معنایی، و جستوجوی شباهت (Similarity Search) برای لاگهای اپیزودیک بزرگ یا پایگاههای دانش معنایی. در این راستا، برخی ابزارها مانند Sonn با معرفی لایهی استدلال تلاش کردهاند تا بازیابی غیرفعال و ساده را به یک فرآیند هوشمندتر تبدیل کنند.
پرسش ۵: آیا عامل نیاز به یادگیری رویههای قابل استفاده مجدد دارد؟
حافظه رویهای روی لایههای معنایی و اپیزودیک قرار میگیرد و آنها را جایگزین نمیکند.
- تسکهای تکرارشونده: اگر یک تسک (مانند یک دسته خاص از تیکتها یا نوعی بازسازی کد/Refactor) با تکرار بهبود مییابد، ارزش این را دارد که در حافظه رویهای تقطیر شود. این کار اجازه میدهد عامل یک روتین پالایششده را اعمال کند، به جای اینکه صرفاً تلاشهای گذشته را بازپخش کند.
- تسکهای یکباره: اگر تسک تکرار نمیشود، این لایه را رد کنید؛ حافظه معنایی یا اپیزودیک کافی است.

ماژول حافظه در کنار لایههای برنامهریزی و ابزار قرار دارد و زمینه یادگرفتهشده را به نحوه برنامهریزیهای آینده بازمیگرداند. تصمیم کلیدی در اینجا این است که «چه چیزی نوشته شود». Logهای خام از اجراهای گذشته، حافظه اپیزودیک را ثبت میکنند. در مقابل، حافظه رویهای درسهای تقطیرشده، گامهای موفق و استراتژیهای قابل استفاده مجدد را که از آن تجربهها استخراج شدهاند، ذخیره میکند. یک ذخیره رویهای مفید برای کاربردهای آینده نوشته میشود و به عامل اجازه میدهد جریانهای کاری (Workflows) و الگوهای اثباتشده را روی تسکهای مشابه اعمال کند.
ترکیبات معماری حافظه
اجرای درخت تصمیم برای هر دسته از اطلاعات، یک «پروفایل حافظه» ایجاد میکند. ترکیب این پروفایلها، معماری نهایی را مشخص میکند:
- عامل کدنویسی: ممکن است همزمان از حافظه کاری (برای ویرایشهای جلسه فعلی)، حافظه معنایی (برای ترجیحات کاربر و دانش ابزارها)، حافظه اپیزودیک (برای تاریخچه تغییرات در طول پروژهها) و حافظه رویهای (برای گردشکارهای تکرارشونده تست و تایید که از طریق استفاده مکرر بهبود یافتهاند) استفاده کند.
- عامل FAQ: احتمالاً فقط به حافظه کاری نیاز دارد، زیرا هیچکدام از اطلاعاتش نیاز به ماندگاری فراتر از گفتگو ندارند.
هر دو نتیجه معتبر هستند. تفاوت از نوع اطلاعاتی میآید که عامل باید حفظ کند و نحوه استفاده از آن اطلاعات.
شکستهای رایج در پیادهسازی
حتی با داشتن برنامه، توسعهدهندگان اغلب در طول استقرار با چالشهای پیشبینیشدنی مواجه میشوند. موارد زیر علائم را به دلایل و راهکارهایشان متصل میکند:
- عامل اطلاعات دادهشده در همان جلسه را دوباره میپرسد: علت معمولاً هرس تهاجمی حافظه کاری یا حذف جزئیات در خلاصهسازی است. راهکار: پنجره نگهداشت را گسترش دهید یا کیفیت خلاصهسازی را بالا ببرید؛ لایه حافظه بلندمدت اضافه نکنید.
- بازیابی نتایج نامرتبط یا متناقض میدهد: به دلیل ترکیب حقایق ثابت و رویدادهای تکاملی در یک مخزن واحد و تفکیکنشده است. راهکار: آنها را به یک مخزن ساختاریافته کوچک برای حقایق و یک Log مجزا برای رویدادها تقسیم کنید.
- حافظه معنایی با اطلاعات غلط بازنویسی میشود: این اتفاق زمانی میافتد که هیچ اعتبارسنجی یا نسخهبندی در لحظه نوشتن وجود ندارد. راهکار: مرحله تأیید، نسخهبندی یا بازبینی را قبل از اینکه یک حقیقت جایگزین حقیقت موجود شود، اضافه کنید.
- حافظه رویهای تأثیری در بهبود عملکرد ندارد: احتمالاً مخزن شامل بازپخش خام اجراهای گذشته است، نه درسهای تقطیرشده. راهکار: درس آموختهشده را بنویسید، نه ترانسکریپت تلاشها را.
- یک سامانه همه چیز (حقایق، تاریخچه، وضعیت جلسه) را همزمان هندل میکند: تمام دستهها در یک مخزن اجبار شدهاند. راهکار: درخت تصمیم را برای هر دسته اجرا کرده و اجازه دهید هر کدام در لایه مورد نیاز خود قرار گیرند.
با طبقهبندی اطلاعات بر اساس طول عمر مورد نظر و روش بازیابی، توسعهدهندگان میتوانند مقدار دادههای رقیب در پنجره زمینه را به حداقل برسانند. این کار تضمین میکند هر داده بازیابیشده، پاسخ عامل را بهطور معناداری بهبود بخشد، نه اینکه نویز اضافه کند.
برای کسانی که عاملهای در سطح تولید (Production-grade) میسازند، گام حیاتی بعدی ارزیابی چارچوبهای حافظه خاص است. شما باید مزایا و معایب ابزارهای وابسته به ارائهدهنده مانند Google’s Memory Bank را در برابر گزینههای مستقل مانند Mem0 بر اساس نیازهای خاص خود در زمینه تأخیر (Latency) و مقیاس-پذیری بسنجید.
گام بعدی شما
- برای هر دستهبندی از دادههای کاربر در سیستم خود، یک بار درخت ۵ پرسشی را اجرا کنید تا لایه ذخیرهسازی درست مشخص شود.
- اگر از پایگاهدادههای برداری برای حقایق ثابت (مانند نام یا ایمیل) استفاده میکنید، آنها را به یک ذخیره ساختاریافته (Structured Store) منتقل کنید تا دقت بازیابی افزایش یابد.
- در صورت استفاده از LangGraph یا CrewAI، ابزارهای مستقل مانند Mem0 را برای مدیریت حافظه اپیزودیک در مقیاس بالا بررسی کنید.
این تنها آغاز ماجراست؛ اثر موجگونهی این تصمیم بر اکوسیستم مدلهای بازمتن و کاهش هزینههای استنتاج را در گزارش بعدی بررسی خواهیم کرد.



گفتگو