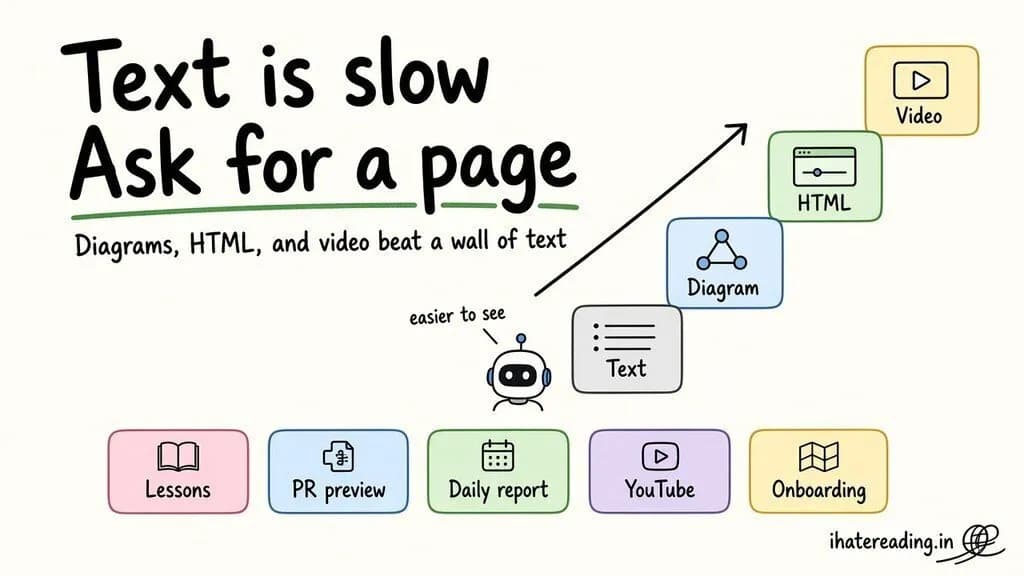
اگر هنوز برای درک رفتار عاملهای هوش مصنوعی به خواندن صدها خط لاگ متنی تکیه میکنید، در واقع دارید از کندترین روش ممکن برای تحلیل دادهها استفاده میکنید. باید بدانید که با افزایش حجم عملیاتهای خودکار، نقش انسان از «اجراکننده» به «ناظر» تغییر کرده و ابزارهای نظارتی ما باید با این سرعت همگام شوند.
آندری کارپاتی (Andrej Karpathy) بهتازگی در شبکه اجتماعی X اشاره کرد که با بر عهده گرفتن بخشهای بیشتری از اجرا توسط هوش مصنوعی، نقشهای انسانی به سمت نظارت و درک عمیقتر تغییر میکند. او استدلال میکند که لاگهای متنی سنتی اکنون به یک گلوگاه تبدیل شدهاند؛ زیرا متن ساده اغلب کندترین راه برای درک خروجیهای پیچیده هوش مصنوعی زاینده (Generative AI) است — چیزی شبیه به خواندن یک دفترچه تلفن قدیمی برای پیدا کردن یک شماره در عصر دیجیتال.
این تغییر رویکرد در زمانی رخ میدهد که عاملهای هوش مصنوعی بهطور فزایندهای حجم عظیمی از دادههای خام تولید میکنند؛ از لاگهای اجرای عملیات گرفته تا تغییرات کد (diffs). برای اکثر کاربران، مرور یک فایل لاگ ۵۰۰ خطی، استفادهای ناکارآمد از توان ذهنی (Cognitive Load) است. راهکار جایگزین، ایجاد یک «نردبان از فرمتهای خروجی» است که از متنهای کنترلشده شروع شده و به نمودارها، صفحات HTML تعاملی و در نهایت ویدیوهای توضیحی میرسد.
طبق راهنمایی که در ۵ اکتبر ۲۰۲۶ منتشر شد، مکانیسم اصلی این تحول، استفاده از «فایلهای HTML مستقل» (Self-contained HTML file) است. با درخواست از مدل برای جاسازی تمام دادهها و استایلها در یک فایل واحد، نیاز به سرورها، مراحل بیلد (Build steps) یا وابستگیهای خارجی حذف میشود. این کار باعث میشود خروجی فوراً قابل انتقال و در عین حال یکبارمصرف باشد. کارپاتی اشاره میکند که اکنون هزینه تولید کد بهقدری پایین آمده که میتوان نرمافزارهای بزرگ و «یکبارمصرف» ساخت که فقط برای یک بار مشاهده و سپس دور ریختن طراحی شدهاند. این رویکرد در حالی مطرح میشود که توسعهدهندگان برای کاهش خطاهای کدنویسی در مقیاس بالا، به دنبال راهکارهای ساختاری هستند؛ مشابه آنچه در طراحی زبان Bend برای تلفیق سرعت و موازیسازی دیده میشود.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی گردشکار با مدلهای زبانی اشاره کردیم، هدف نهایی کاهش فاصله بین «دیدن نتیجه» و «درک پیامد» است.
چرخه اصلی اجرا
هر پیادهسازی از یک چرخه سه مرحلهای ثابت پیروی میکند:
- ورودی: دریافت متن موجود (مانند یک دوره آموزشی، یک diff کد، لاگهای سیستم یا متن پیادهشده از یک ویدیو).
- درخواست: درخواست از مدل برای تولید یک فایل HTML مستقل که تمام دادهها در داخل آن جاسازی شده باشد.
- بررسی: باز کردن فایل در مرورگر، خواندن آن و سپس تصمیمگیری برای حفظ یا دور ریختن آن.
یادگیری تعاملی و آنبوردینگ
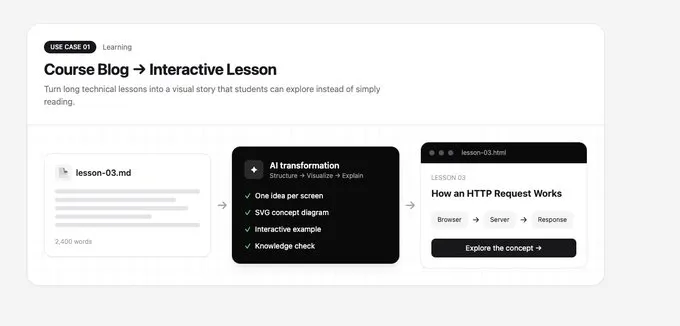
یکی از کاربردهای اصلی، تبدیل محتوای آموزشی طولانی به روایتهای مبتنی بر اسکرول (Scroll-based storytelling) است. بهجای استفاده از Markdown ایستا، میتوانید از Claude Code یا Cursor بخواهید صفحهای بسازند که در هر صفحه تنها یک ایده مطرح شود. در این صفحات میتوان از نمودارهای SVG برای مفاهیم اصلی و از اسلایدرهای تعاملی، دکمههای سوئیچ (Toggles) یا کوئیزهای کوتاه استفاده کرد. این روش مانع از آن میشود که دانشجویان با مرور سریع متن، نکات کلیدی را فراموش کنند. برای حفظ یکپارچگی، کاربران باید درخواست کنند که همین چیدمان در تمام پوشههای دروس رعایت شود. همچنین تأیید دستی حقایق ضروری است، زیرا یک صفحه شیک و صیقلخورده میتواند ادعاهای غلط را درست جلوه دهد. این نکته یادآور آن است که صرفاً تغییر ظاهر متن کافی نیست و ابزارهای انسانیساز متن نمیتوانند خلأ محتوایی یا نقصهای منطقی پیشنویسهای AI را برطرف کنند.
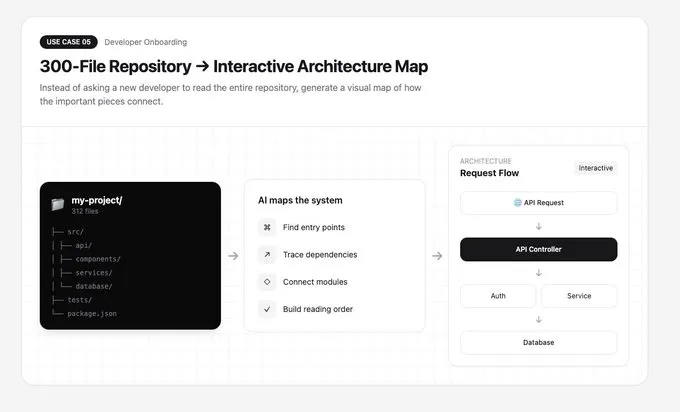
برای توسعهدهندگان، همین منطق در آشنایی با کدهای جدید (Onboarding) کاربرد دارد. بهجای خواندن دایرکتوری شامل ۳۰۰ فایل، مدل میتواند یک نقشه معماری تعاملی تولید کند. در این ساختار، جعبههای قابل کلیک پنلهایی را باز میکنند که عملکرد ماژولها، فایلهای کلیدی و نحوه اجرای تستها را توضیح میدهند. این ابزار حتی میتواند یک راهنمای «دنبال کردن یک درخواست» (Follow one request) از نقطه ورود تا پایگاه داده و یک ترتیب پیشنهادی برای مطالعه در هفته اول را ارائه دهد. Claude Code بهدلیل توانایی در خواندن کل مخزن کد (Repository)، در این زمینه بسیار مؤثر است.
بصریسازی گردشکارهای فنی
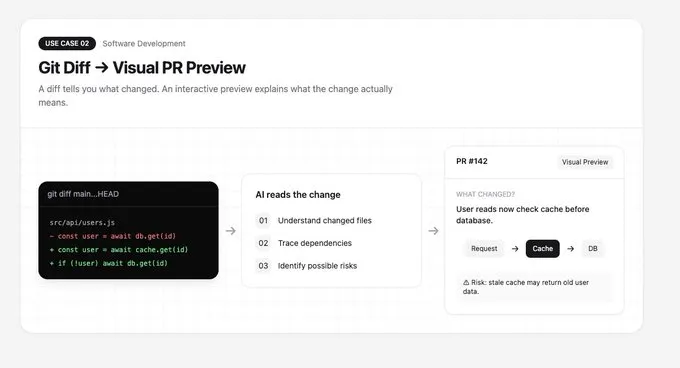
بررسی کدها (Code Review) اغلب بهدلیل اینکه تغییرات Git فقط «چه چیزی» تغییر کرده را نشان میدهند و نه «معنای» آن تغییرات، دشوار است. با اجرای دستور git diff main...HEAD و ارسال آن به هوش مصنوعی، میتوان یک پیشنمایش بصری از PR تولید کرد. این خروجی شامل یک خلاصه پنج خطی به زبان انگلیسی ساده و نموداری از نحوه اتصال توابع تغییریافته است که بهعنوان نقشهای برای بازبین انسانی عمل میکند. برای تیمها، این فایل میتواند بهعنوان یک آرتیفکت در CI اضافه شود تا هر PR لینک مستقیمی به تحلیل بصری داشته باشد. بازبینها باید لیست «ریسکهای» تولید شده توسط هوش مصنوعی را بهعنوان یک نقطه شروع در نظر بگیرند، نه یک حسابرسی کامل و نهایی.
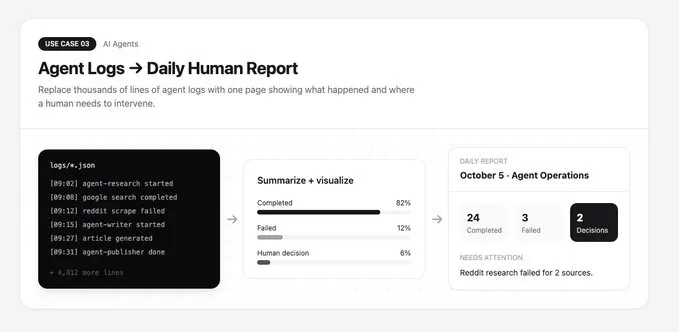
مدیریت عاملهای هوش مصنوعی نیز از این روش بهره میبرد. بهجای لاگهای JSON خام، مدیران، مشتریان یا حتی والدین دانشآموزانی که از عاملهای یادگیری استفاده میکنند، میتوانند گزارشهای تعاملی روزانه دریافت کنند. این گزارشها میتوانند شامل موارد زیر باشند:
- کارتهای سطح بالا: هایلایت کردن کارهای تکمیلشده، موارد شکستخورده و مواردی که نیاز به تصمیم انسانی دارد.
- خط زمانی عاملها: نمای کرونولوژیک از فعالیت هر عامل بهصورت مجزا.
- فیلترها: امکان فیلتر کردن نماها بر اساس عاملهای خاص.
- پنلهای «چرا»: توضیحات مفصلی که با کلیک باز میشوند تا دلیل یک تصمیم را شرح دهند.
این گزارشها از زبانی ساده و آرام برای خوانندگان غیرفنی استفاده میکنند. بهدلیل جاسازی دادهها، این فایلها بهصورت آفلاین و بهعنوان پیوست ایمیل کار میکنند. برای دادههای حساس (مثلاً مربوط به کودکان)، در پرامپت باید مشخص شود که فقط اطلاعات ضروری نمایش داده شود و جزئیات خصوصی بهطور پیشفرض حذف شوند.
آرشیو محتوا و مستندسازی
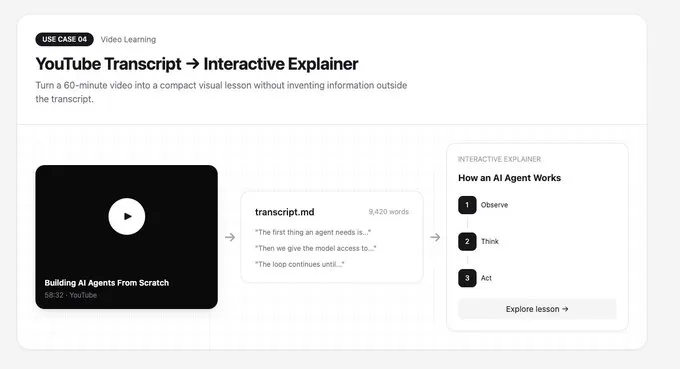
ویدیوهای آموزشی را میتوان با آرشیو کردن متنها (Transcripts) و تبدیل آنها به توضیحات HTML بازسازی کرد. با استفاده از ابزارهایی مثل TubeLog برای ذخیره متنها بهصورت Markdown، میتوان از هوش مصنوعی خواست کارتهایی برای ۵ ایده کلیدی، یک نمودار فرآیند و یک واژهنامه از اصطلاحات بسازد. در اینجا حیاتی است که به مدل دستور داده شود صرفاً در محدوده متن ویدیو بماند و حقایق خارجی اضافه نکند. اگر کاربر بهجای صفحه، ویدیو را ترجیح میدهد، میتواند از مدل بخواهد یک پلان صحنه (Scene plan) و کدهای Manim یا Remotion تولید کند تا صحنهها یکییکی رندر شوند.
فراتر از این پنج مورد، سایر کاربردهای باارزش عبارتاند از:
- کاوشگر مستندات API: تبدیل یک فایل OpenAPI به صفحهای که در آن بتوان درخواست را ویرایش کرد و پاسخ نمونه را مشاهده نمود.
- تحلیل پس از حادثه (Postmortem): تبدیل لاگها و تاریخچه چتها به یک خط زمانی همراه با نمودار علت و معلولی.
- صفحات اقدام جلسات: تبدیل متن جلسات به چکلیستهایی شامل تصمیمات، مسئولین و ضربالاجلها.
- توضیحگر سیاستها: ایجاد نسخه ساده به زبان عامیانه از قراردادها با هایلایت کردن بندهای ریسکی.
- خلاصههای پژوهشی: ایجاد نمودارهای تعاملی از متدهای علمی در کنار یک واژهنامه تخصصی.
ابزارهای پیادهسازی
بسته به مقیاس پروژه، ابزارهای مختلفی توصیه میشود:
- Claude Code: بهترین گزینه برای مخازن کد، لاگها و پردازش همزمان چندین فایل. کافی است یک پوشه و یک نام فایل هدف به آن بدهید.
- Cursor: ایدهآل برای زمانی که در محیط ویرایشگر هستید؛ از حالت Agent استفاده کنید و فایل HTML را در پنل مرورگر باز کنید.
- Claude (chat): مناسب برای صفحات تکموردی؛ متن را آپلود کرده و درخواست یک Artifact HTML برای انتشار یا دانلود کنید.
این رویکرد فرض بنیادی تعامل با هوش مصنوعی را تغییر میدهد: متن پیشفرض است، اما بهندرت بهترین گزینه است. با نگاه به کد بهعنوان ابزاری «ارزان برای ساخت نرمافزارهای یکبارمصرف»، کاربران میتوانند برای هر تکه دادهای که نیاز به درک آن دارند، یک رابط کاربری اختصاصی بسازند.
برای شما بهعنوان کاربر، این به معنای تغییر نقش از «خواننده» به «ویراستار» رابطهای کاربری تولیدشده توسط هوش مصنوعی است. هدف، کاهش زمان بین مشاهده نتیجه و درک پیامدهای آن است که در واقع پهنای باند همکاری انسان و هوش مصنوعی را افزایش میدهد.
گام بعدی شما
یکی از گزارشها یا لاگهای متنی که هر روز با آن سر و کار دارید را شناسایی کنید.
از مدل بخواهید آن را به یک «فایل HTML مستقل و تعاملی» (Self-contained HTML) تبدیل کند.
خروجی را در مرورگر باز کرده و بررسی کنید که آیا سرعت درک شما از دادهها افزایش یافته است یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو