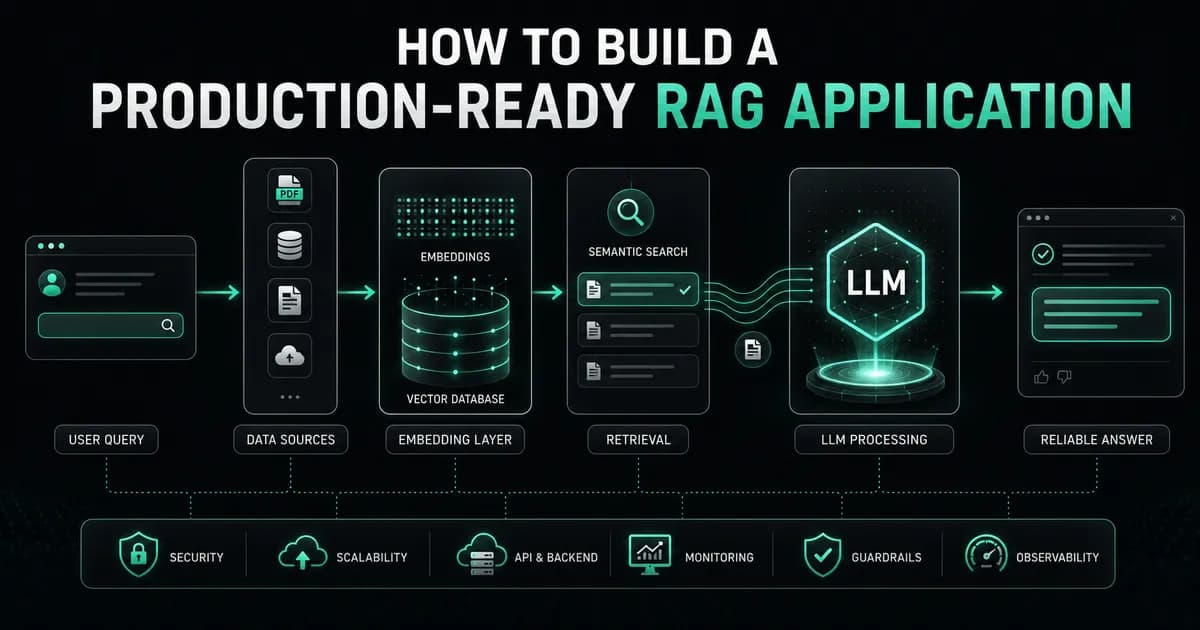
تصور کنید مدیر محصول شرکتی هستید که دموهای هوش مصنوعیاش در جلسات نمایش عالی عمل میکنند، اما به محض رسیدن به دست کاربر، پاسخهای متناقض میدهند. این دقیقاً همان شکافی است که بسیاری از تیمهای توسعه را در مسیر تبدیل یک ایده به محصول متوقف میکند.
به گزارش SolveMotive، یک شرکت لجستیکی در روتردام این درس را به سختی آموخت؛ آنها متوجه شدند که یک دموی RAG فعال، لزوماً به معنای یک اپلیکیشن آماده برای محیط عملیاتی نیست. چتبات آنها سه هفته پس از عرضه در بهار گذشته، شروع به ارجاع به سیاستهای حملونقلی کرد که اصلاً وجود نداشتند و با اطمینان کامل اطلاعات غلط میداد. طبق راهنمای SolveMotive، این شکست نه از مدل زبانی، بلکه از فقدان استراتژیهای قدرتمند تکهبندی، بازیابی و لایههای حفاظتی (Guardrails) ناشی شده بود. برای درک عمیقتر از نحوه پیادهسازی این لایهها، میتوانید سازوکار درگاههای ایمنی برای چتباتهای صنعتی را بررسی کنید. اکثر تیمها دقیقاً در همین فاصله بین دمویی که کار میکند و اپلیکیشنی که در برابر کاربران واقعی دوام میآورد، گیر میکنند.
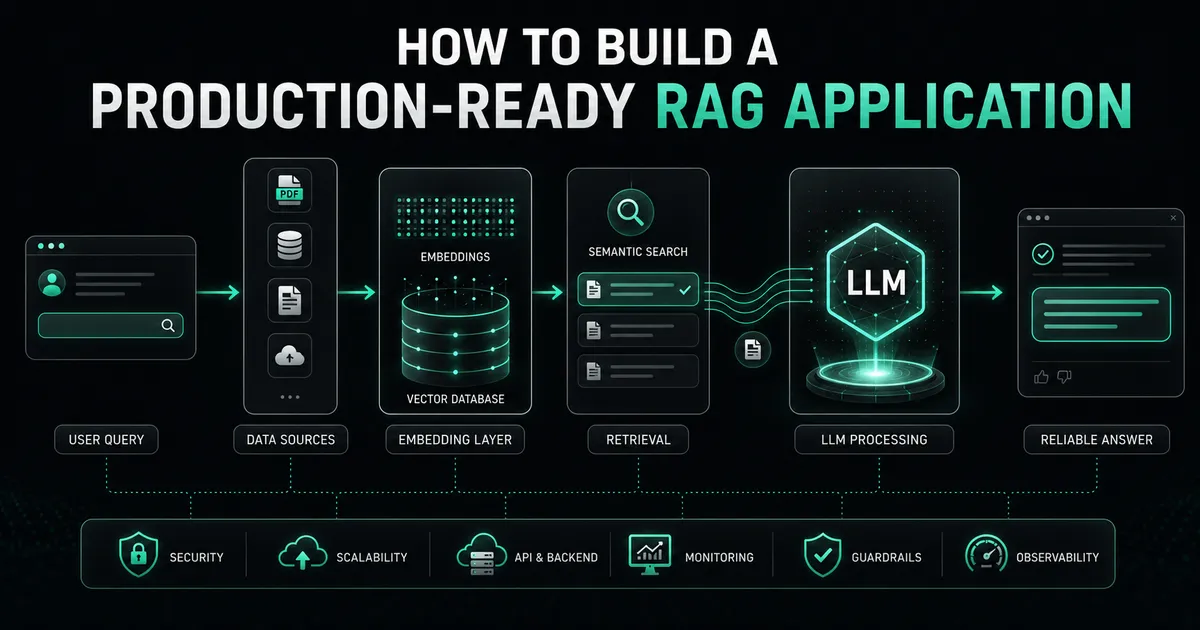
ساخت یک سیستم عملیاتی به معنای فراتر رفتن از یک فراخوانی ساده API است. یک پروتوتایپ زمانی کار میکند که خودتان آن را تست کنید؛ اما یک سیستم عملیاتی زمانی کار میکند که ۲۰۰ غریبه، سؤالاتی با عبارتبندیهای عجیب را در برابر اسنادی بپرسند که هر هفته تغییر میکنند. برای بقا در چنین محیطی، تیمها باید با تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — نه به عنوان یک افزونه چتبات، بلکه به عنوان یک خط لوله مهندسی کامل برخورد کنند. تیمهای SolveMotive این فرآیند را به ۶ مرحله حیاتی تقسیم کردهاند: ورود داده، بردارسازی، بازیابی، تولید، ارزیابی و نظارت. نادیده گرفتن هر یک از این مراحل معمولاً جایی است که سیستم در مراحل بعدی از هم میپاشد.
مرحله ۱: ورود داده و تکهبندی
اسناد خام بهندرت با نحوه پرسش کاربران همخوانی دارند. یک فایل PDF ۴۰ صفحهای که به یک تکه بزرگ تبدیل شود، بازیاب را در نویز غرق میکند و باعث میشود اطلاعات مفید گم شوند؛ در مقابل، تکههای تکجملهای هم زمینه (Context) حیاتی را از بین میبرند و مدل نمیتواند ارتباط بین جملات را درک کند.
تکهبندی (Chunking) — مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — باید بر اساس مرزهای معنایی مثل تیترها و پاراگرافها باشد، نه بر اساس تعداد کاراکترهای ثابت. در همین راستا، رویکردهای جدید برای رفع گسست بافت در RAG نشان میدهد که چگونه تکهبندی معنایی میتواند جایگزین روشهای تصادفی شود. SolveMotive توصیه میکند اندازه تکهها بین ۲۰۰ تا ۵۰۰ توکن (Token) باشد و همپوشانی (Overlap) اندکی داشته باشند تا رشته افکار و معنا در وسط یک جمله قطع نشود.
بسیار حیاتی است که متادادهها در کنار هر تکه ذخیره شوند تا فیلتر کردن و ارجاعدهی ممکن شود. این متادادهها باید شامل موارد زیر باشند:
- نام سند منبع
- عنوان بخش یا فصل
- تاریخ آخرین بهروزرسانی
- مجوزهای دسترسی کاربر
از آنجایی که مستندات سازمانها تکامل مییابند، فرآیند ورود داده باید بر اساس یک زمانبندی (Schedule) اجرا شود، نه اینکه فقط یک بار انجام شود. یک سیستم RAG که بر اساس یک کپی قدیمی از شش ماه پیش ساخته شده باشد، ناگزیر است اطلاعات منقضی شده ارائه دهد.
مرحله ۲: بردار معنایی و ذخیرهسازها
انتخاب مدل بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — مستقیماً بر هزینه و کیفیت بازیابی اثر میگذارد. گزینهها از مدلهای تجاری مثل text-embedding-3 شرکت OpenAI و embed-v3 شرکت Cohere تا مدلهای بازمتن قدرتمندی مثل BGE یا E5 متغیر است. هر یک از این مدلها بسته به ترکیب زبانها و دامنه تخصصی دادهها، نقاط قوت متفاوتی دارند.
برای ذخیرهسازی، تصمیمگیری بر اساس حجم داده، نیاز به فیلتر کردن متادادهها در زمان پرسوجو و ترجیحات زیرساختی است:
- Pinecone و Weaviate: ایدهآل برای تیمهایی که به دنبال سرویسهای کاملاً مدیریتشده (Managed Services) هستند.
- pgvector: بهترین گزینه برای دادههایی که از قبل در پایگاه داده Postgres هستند تا از هزینههای اضافی انتقال داده جلوگیری شود.
- Qdrant: تعادلی میان عملکرد بالای مدلهای بازمتن و کارایی عملیاتی ارائه میدهد.
مرحله ۳: استراتژیهای پیشرفته بازیابی
جستوجوی برداری خالص اغلب در یافتن تطابقهای دقیق کلمات کلیدی، مانند کدهای محصول یا شمارههای خطا، شکست میخورد؛ زیرا مدلهای Embedding گاهی نمیتوانند این موارد را در رتبههای بالا قرار دهند. برای حل این مشکل، مهندسان از جستوجوی ترکیبی (Hybrid Search) استفاده میکنند که جستوجوی برداری را با جستوجوی سنتی کلمات کلیدی (مانند الگوریتم BM25) ادغام میکند.
لایه دوم، یعنی بازرتبهبندی (Reranking)، دقت را بیش از پیش افزایش میدهد. پس از استخراج اولیه ۲۰ تکه کاندید، یک مدل cross-encoder — مانند Rerank API شرکت Cohere یا bge-reranker — آنها را بر اساس ارتباط واقعی با سؤال مرتب میکند. این فرآیند معمولاً کمتر از ۲۰۰ میلیثانیه تأخیر اضافه میکند، اما جهشی معنادار در دقت پاسخها ایجاد میکند، پیش از آنکه ۳ تا ۵ تکه برتر به مدل زبانی (LLM) ارسال شوند.
مرحله ۴: تولید مبنیسازی شده
طراحی پرامپت به اندازه بازیابی حیاتی است. صرفاً چسباندن تکهها به بالای یک سؤال اغلب باعث میشود مدل، محتوای منبع را با دادههای آموزشی داخلی خودش ترکیب کند و دچار توهم (Hallucination) شود — یعنی زمانی که مدل با اطمینان چیزی را میگوید که در واقعیت یا در متن منبع وجود ندارد.
پرامپتهای عملیاتی باید شامل دستورات صریح باشند: فقط از متن ارائهشده پاسخ بده، اگر پاسخ در متن موجود نیست صراحتاً اعلام کن و به تکههای خاص ارجاع بده. افزودن یک دستور ساده برای رد درخواست — مثلاً اینکه به مدل بگوییم «اگر متن به سؤال پاسخ نمیدهد، به جای حدس زدن، این موضوع را اعلام کن» — نرخ پاسخهای توهمآمیز را بهطور محسوسی کاهش میدهد.
مرحله ۵: ارزیابی سختگیرانه
عرضه یک سیستم بر اساس چند تست دستی، یکی از رایجترین نقاط شکست است. یک سیستم RAG عملیاتی به یک مجموعه آزمون (Test Set) شامل ۵۰ تا ۱۰۰ پرسش نماینده نیاز دارد که پاسخهای صحیح آنها از روی تیکتهای پشتیبانی واقعی یا پرسوجوهای مستندات استخراج شده باشد.
تیمها باید از ابزارهایی مثل RAGAS یا TruLens برای سنجش سه معیار مجزا استفاده کنند:
- صحت بازیابی (Retrieval accuracy): آیا سیستم توانست تکههای درست را استخراج کند؟
- وفاداری (Faithfulness): آیا پاسخ تولید شده دقیقاً با متن بازیابی شده مطابقت دارد؟
- ارتباط پاسخ (Answer relevance): آیا پاسخ واقعاً سؤال کاربر را حل میکند؟
تفکیک این معیارها حیاتی است؛ زیرا ممکن است سیستمی تکهها را عالی بازیابی کند اما پاسخ بدی تولید کند، یا برعکس.
مرحله ۶: نظارت و مشاهدهپذیری
کیفیت بازیابی بهمرور زمان بهدلیل پدیده «رانش برداری» (Embedding Drift) یا بهروزرسانی اسناد، بهطور نامحسوسی افت میکند. ثبت (Logging) هر پرسوجو در کنار تکههای بازیابی شده و پاسخ نهایی، به تیمها اجازه میدهد پیش از آنکه کاربران شکایت کنند، مشکلات را شناسایی کنند.
مدیریت تأخیر (Latency) نیز باید از روز اول در اولویت باشد؛ پاسخی که ۸ ثانیه طول بکشد، از نظر کاربر خراب است. برای حفظ سرعت، تیمها باید این موارد را پیاده کنند:
- کشینگ (Caching) برای پرسوجوهای رایج و تکراری
- اجرای موازی فرآیندهای بازیابی و بازرتبهبندی
- تعیین مهلت زمانی (Hard Timeouts) همراه با جایگزینهای مناسب (Graceful Fallbacks)
تحلیل: نقاط شکست رایج
این چارچوب، گفتگو درباره RAG را از «کدام مدل زبانی بهتر است» به «دادهها چگونه مدیریت میشوند» تغییر میدهد. چندین اشتباه تکراری معمولاً چند هفته پس از عرضه ظاهر میشوند:
- شکافهای امنیتی: برخورد با ذخیرهساز برداری به عنوان یک منبع واحد حقیقت بدون کنترل دسترسی، که باعث میشود کاربران اسنادی را ببینند که مجاز به دیدن آنها نیستند.
- میانبر در ارزیابی: نادیده گرفتن مجموعه آزمون رسمی و عرضه محصول تنها بر اساس چند پرسوجوی دستی.
- تکهبندی یکنواخت: اعمال یک اندازه تکه ثابت برای مجموعهای متنوع از PDFها، ویکیها و تیکتهای پشتیبانی.
- دستکم گرفتن پرامپت: تصور اینکه داشتن یک بازیاب قوی، نیاز به مهندسی دقیق پرامپت را از بین میبرد.
برای یک متخصص، ارزشمندترین مهارت نه مهندسی پرامپت، بلکه «مشاهدهپذیری خط لوله» (Pipeline Observability) است. توانایی تشخیص اینکه شکست در کدام مرحله (ورود داده، بازیابی یا تولید) رخ داده، همان چیزی است که یک پروژه آماتور را از یک ابزار سازمانی متمایز میکند.
ساخت یک اپلیکیشن RAG که در برابر کاربران واقعی دوام بیاورد، در گرو این است که هر مرحله را به عنوان یک مسئله مهندسی مجزا ببینید. تیمهای موفق معمولاً در تلاش اول به نتیجه نرسیدند؛ آنها ساختند، نقاط شکست را رصد کردند و هر لایه را بهطور مجزا اصلاح کردند. اگر تیم شما در حال تصمیمگیری بین «ساختن یا خریدن» است یا در لایهای از این پشته تکنولوژی گیر کرده است، مهندسان SolveMotive بهطور منظم روی این مسائل کار میکنند. بیایید گفتگو کنیم. انگیزه شما، راهکار ما.
گام بعدی شما
- اگر از RAG استفاده میکنید، همین امروز یک مجموعه آزمون (Test Set) از ۱۰۰ سؤال واقعی بسازید و نرخ وفاداری پاسخها را اندازه بگیرید.
- لایه بازرتبهبندی (Reranking) را به خط لوله خود اضافه کنید تا دقت بازیابی را بدون تغییر مدل زبانی افزایش دهید.
- متادادههای دسترسی را به تکههای داده اضافه کنید تا از نشت اطلاعات حساس بین کاربران جلوگیری کنید.
اما بهینهسازی هزینه استنتاج در این مقیاس، چالش بعدی است — به تحلیل ما دربارهی کاهش هزینههای GPU در محیطهای سازمانی مراجعه کنید.



گفتگو