اگر امروز در حال طراحی یک معماری پیچیده برای اپلیکیشن هوش مصنوعی خود هستید، احتمالاً در حال ساختن چیزی هستید که هرگز به آن نیاز نخواهید داشت. واقعیت این است که اکثر تیمهای توسعه نه به دلیل انتخاب مدل اشتباه، بلکه به دلیل افزودن لایههای پیچیدگی پیش از تعریف دقیق مسئله، شکست میخورند. ساختن یک نمودار معماری پیچیده آسان است، اما عرضه محصولی که واقعاً کار کند، جایی است که اکثر تیمهای هوش مصنوعی در آن شکست میخورند.
به نقل از راهنمای مفصلی که در ۲۴ اوت ۲۰۲۶ در dev.to منتشر شد، توسعهدهندگان تمایل دارند به جای حل مسئله، «کلیساهایی» از زیرساختهای عظیم بسازند. آنها لایههایی از داربستها شامل پایگاهدادههای برداری (Vector Database) — شبیه به یک بایگانی دیجیتال که به جای نام فایل، بر اساس «معنا و مفهوم» مطالب را دستهبندی میکند —، گرافهای ارکستراسیون چندعاملی، مدلهای تنظیمشده (Fine-tuned)، لایههای حافظه، پوشانندههای ابزار سفارشی (Custom tool wrappers) و سیستمهای تکرار درخواست با تأخیر نمایی (Exponential backoff) را دور یک هستهٔ ساده میپیچند. آنها اغلب انتزاعاتی را اضافه میکنند که برای «آیندهنگری» است اما در حال حاضر هیچکس از آنها استفاده نمیکند. همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هر لایهٔ اضافی در معماری، سطح شکست سیستم را گسترش میدهد و باعث افزایش تأخیر، هزینه و غیرقابلپیشبینی شدن خروجیها میشود.
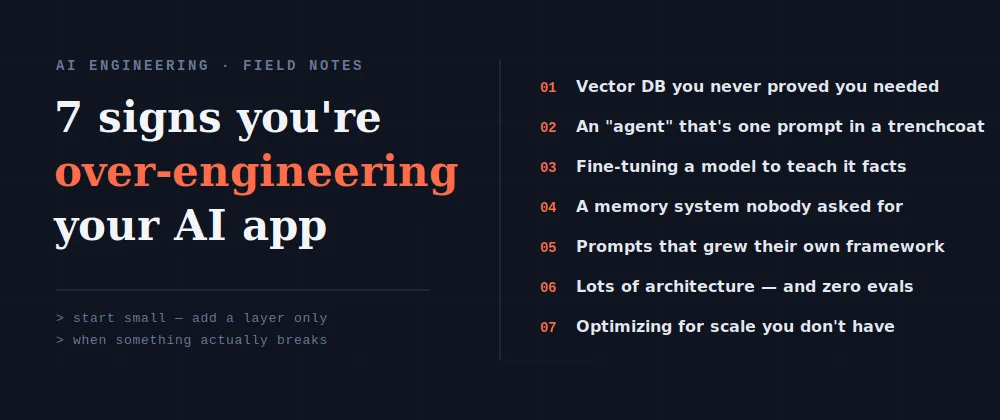
هفت پرچم قرمز مهندسی بیشازحد
استفاده زودهنگام از پایگاهداده برداری: جمله «ابتدا پایگاهداده برداری خود را راهاندازی کنید» به خط شروع پیشفرض هر آموزش هوش مصنوعی تبدیل شده است. در نتیجه، تیمها به صورت رفلکسی سراغ Pinecone یا Chroma میروند، پیش از آنکه تأیید کنند آیا اصلاً با مسئلهای در بازیابی دادهها روبرو هستند که به بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — نیاز داشته باشد.
- نکته جالب سال گذشته این است که در بسیاری از موارد، این کار کاملاً زیادهروی است.
- برخی از توانمندترین عاملهای کدنویسی، بیسروصدا جستوجوی برداری را به نفع جستوجوی ابزار-محور ساده کنار گذاشتهاند؛ کارهایی مثل استفاده از
grepبرای جستوجوی متنی، خواندن درخت فایلها یا درخواست فایلها با نام دقیق. - در یک مورد مشهور، حذف خط لوله (Pipeline) بردارسازی و جایگزینی آن با
grepمنجر به عملکردی شد که به طور قابل توجهی از تنظیمات برداری بهتر بود. - پایگاهدادههای برداری همچنان برای پایگاههای دانش بزرگ و ثابت مانند مستندات محصول، سوالات متداول (FAQs) و واژهنامهها، بهویژه زمانی که با یک رنکر (Reranker) خوب ترکیب شوند، مناسب هستند. اما اگر دادهها در پنجره متنی (Context Window) — میزان متنی که مدل همزمان «در ذهن» نگه میدارد، شبیه به میز کاری که جا برای چند ورق دارد — جای میگیرند یا از طریق کلمات کلیدی و فیلترها قابل جستوجو هستند، یک دستور سادهٔ SQL
WHEREاغلب کافی است.
عاملهای «پالتوپوش»: ساخت سامانههای چندعاملی جذاب است. توسعهدهندگان یک عامل برنامهریز (Planner)، یک عامل پژوهشگر (Researcher)، یک عامل منتقد (Critic) و یک عامل ترکیبکننده (Synthesizer) میسازند که همگی پیامها را در یک گراف رد و بدل میکنند. این کار شبیه به مهندسی واقعی به نظر میرسد، اما بسیاری از این اپلیکیشنهای «عاملمحور» در واقع فقط یک پرامپت هستند که لباس چند عامل را پوشیدهاند.
- یک پرامپت خوشساخت یا توالی کوتاهی از ۲ یا ۳ فراخوانی خطی، اغلب قابلاعتمادتر، ارزانتر و راحتتر برای عیبیابی است.
- هر عامل اضافی، نقاط احتمالی برای توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — و تعداد دفعات انتقال پیام (Handoff) که میتواند باعث شکست سیستم شود را افزایش میدهد.
- اگر نمیتوانید به وضوح بیان کنید که هر عامل چه کاری انجام میدهد که یک فراخوانی واحد نمیتوانست انجام دهد، شما یک سامانه چندعاملی ندارید؛ بلکه یک پرامپت دارید که چندین کلاه بر سر گذاشته و برای هر کدام از آنها از شما هزینه میگیرد.
تنظیم دقیق برای یادگیری حقایق: یک اشتباه رایج و گرانقیمت، استفاده از تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — روی دادههای شرکتی با این امید است که مدل آن اطلاعات را به طور قابلاعتمادی به خاطر بسپارد. این یک سوءتفاهم بنیادی در مورد ابزار است.
- مدلها حقایق را بد به خاطر میسپارند و آنها را به صورت غیرقابلپیشبینی فراموش میکنند.
- تنظیم دقیق برای شکل دادن به «رفتار» است — مانند لحن، فرمت و همسویی با وظیفه (Task-alignment) — نه برای ذخیره دانش.
- حقایق باید در لایه بازیابی (Retrieval layer) باشند که میتوان آنها را در چند ثانیه بهروز کرد، نه اینکه در وزنهای مدل پخته شوند که برای تغییر آنها نیاز به آموزش مجدد است.
سیستمهای حافظهٔ ناخواسته: شعار «هوش مصنوعی که شما را به یاد میآورد» جذاب است و باعث میشود تیمها لایههای حافظه دائمی، گرافهای دانش زمانی و وضعیتهای بین-نشستی (Cross-session state) را خیلی زود اضافه کنند.
- در حالی که حافظه برای عاملهایی که واقعاً در چندین جلسه فعال هستند مهم است، برای اپلیکیشنهایی که اساساً تک-مرحلهای (Single-shot) هستند، صرفاً یک سربار اضافی است.
- سیستمهای حافظه به منطق پیچیدهای نیاز دارند تا تصمیم بگیرند چه چیزی را نگه دارند، چه چیزی را قدیمی کنند و چه چیزی را دوباره بازیابی کنند.
- حافظههای نیمبند میتوانند فعالانه به عملکرد آسیب بزنند، زیرا زمینههای قدیمی یا اشتباه بازیابی شده، پاسخها را بدتر میکنند، نه بهتر.
تورم چارچوبهای پرامپت: همه چیز با یک پرامپت سیستمی و چند مثال شروع میشود. سپس یک موتور قالبساز (Templating engine)، منطق اسمبل کردن شرطی پرامپت، یک «روتر» پرامپت و کتابخانهای از ۴۰ تکه (Partial) میآید که در زمان اجرا به هم میچسبند.
- پیچیدگی در لولهکشی همچنان پیچیدگی است.
- وقتی پرامپت نهایی به چیزی تبدیل میشود که هیچ انسانی نمیتواند در یک نشست بخواند، شما یک مشکل خوانایی آشکار را با یک مشکل نامرئی جایگزین کردهاید.
- اگر نمیتوانید پرامپت نهایی رندر شده را دنبال کنید، کار مدل سختتر از آن چیزی است که باید باشد.
معماری بدون ارزیابی: این همان نشانهای است که تمام پرچمهای قرمز دیگر را به هم وصل میکند. تیمها هفتهها وقت خود را صرف خط لولههای بازیابی و گرافهای عامل میکنند اما کیفیت را با «حس» (Vibes) میسنجند — یعنی کلیک میکنند و خروجیها را با چشم میبینند تا زمانی که «خوب به نظر برسد».
- نادیده گرفتن ارزیابی (Evaluation) یکی از خطرناکترین اشتباهات در هوش مصنوعی تولیدی است.
- بدون ارزیابی، نمیتوانید پاسخ دهید که آیا یک تغییر باعث خرابی چیزی شده است یا اینکه سیستم در برابر ورودیهای مختلف به طور سازگار رفتار میکند یا خیر.
- هر لایه معماری بر اساس یک فرض است؛ بدون یک مجموعه تست برچسبگذاریشده از ۳۰ تا ۵۰ نمونه، آن فرضها آزمایشنشده باقی میمانند.
- ارزیابیها اغلب فاش میکنند که مشکل واقعی، شفافیت پرامپت یا کیفیت بازیابی است، نه کمبود یک معماری پیچیده.
مقیاسدهی زودهنگام: پیادهسازی شاردینگ (Sharding)، لایههای کش پیچیده، سیستمهای جایگزین در مناطق مختلف (Multi-region failover)، سیستمهای صف و مقیاسدهی خودکار استنتاج GPU برای اپلیکیشنی با چند ده کاربر روزانه، نمونه کلاسیک مهندسی بیشازحد است.
- این در واقع مقیاسدهی زودهنگام است که لباس هوش مصنوعی پوشیده است.
- توسعهدهندگان بابت ترافیکی که ممکن است هرگز نیاید، هزینه زمان ساخت و بار شناختی میپردازند.
- مشکلات مقیاسدهی «مشکلات خوب» هستند زیرا نشاندهنده استفاده کاربران است.
- توصیه این است که برای تقریباً ۱۰ برابر بار فعلی بسازید، نه ۱۰۰۰ برابر، و سیستم را طوری طراحی کنید که تغییر آن آسان باشد.
دستورالعمل مینیمال برای هوش مصنوعی
برای اجتناب از این تلهها، گزارش dev.to پیشنهاد میکند با یک «پایهٔ خستهکننده» (Boring baseline) شروع کنید. بدترین و سادهترین نسخه ممکن را بسازید: یک پرامپت که اسناد مربوطه مستقیماً در آن چسبانده شدهاند، بدون بازیابی و بدون عامل. اندازهگیری کنید که این نسخه واقعاً چقدر خوب است. این عدد، خط مبنای شماست؛ هر لایه بعدی باید به طور ملموس این عدد را بهبود ببخشد تا وجودش توجیهپذیر باشد. ممکن است متوجه شوید که همان پایه خستهکننده برای عرضه محصول کافی است.
تیمها باید یک قانون سختگیرانه را بپذیرند: هیچ لایه جدیدی بدون پاسخ یکجملهای به این سؤال اضافه نشود که «این لایه دقیقاً کدام مشکل مشاهدهشده را حل میکند؟». توجیهاتی مثل «شاید بعداً به درد بخورد» یا «در آموزش (Tutorial) وجود داشت» پذیرفته نیست. اگر نمیتوانید شکستی را نام ببرید که این لایه آن را برطرف میکند، این فقط یک حدس است که باید در لیست کارهای آینده (Backlog) باشد، نه در کد برنامه.
علاوه بر این، توسعهدهندگان باید ترتیب معمول عملیات را برعکس کنند: ابتدا تست ارزیابی را بنویسید و سپس ویژگی را بسازید. اگر نمیتوانید تعریف کنید که «بهبود» به صورت عددی و قابل اندازهگیری چه معنایی دارد، آماده ساخت آن ویژگی نیستید. اغلب، یک تغییر بسیار سادهتر میتواند عدد ارزیابی را به همان اندازه تغییر دهد که یک افزودنی معماری پیچیده.
استراتژی کلیدی دیگر، افزودن لایهها به صورت تکبهتک و اندازهگیری هر یک است. افزودن سه بهبود به طور همزمان باعث میشود غیرممکن شود که بفهمید کدام یک کمک کرده یا کدام یک بیسروصدا اوضاع را بدتر کرده است. گردش کار «یک تغییر، یک اندازهگیری، حفظ یا بازگشت» از تحجر پیچیدگیهای تصادفی در سیستم جلوگیری میکند.
ابزارهای «خستهکننده و قابل حذف» را ترجیح دهید. اگر بین دو گزینه هستید، گزینهای را انتخاب کنید که راحتتر بیرون کشیده و حذف شود.
- یک فراخوانی تابع ساده را راحتتر از یک چارچوب (Framework) حذف میکنید.
- جستوجوی کلمات کلیدی را راحتتر از یک ذخیرهساز برداری حذف میکنید.
با به تأخیر انداختن تصمیمات غیرقابل بازگشت — مانند طرحهای پایگاهداده (Schemas)، چارچوبهای صلب عاملها یا مدلهای تنظیمشده — تیمها گزینههای خود را باز نگه میدارند. تصمیمات بازگشتپذیر، مانند تغییرات پرامپت یا تعویض مدل، باید آزادانه و زود انجام شوند.
این تغییر دیدگاه، هدف را از ساخت یک نمونهٔ خیرهکننده برای رزومه، به ساخت یک محصول قابل نگهداری تغییر میدهد. بسیاری از مهندسیهای بیشازحد صرفاً تلاش مهندسان برای ساخت نسخهای است که برای خودشان تحسینبرانگیز باشد. مهندسی ارشد اغلب حرکت کوچکتر است: پرسیدن این سؤال که «چه چیزی را میتوانم حذف کنم و اپلیکیشن همچنان کار کند؟» خویشتنداری، مهارت سختتری است.
این رویکرد، فرض بنیادی توسعه هوش مصنوعی را از «چقدر میتوانم اضافه کنم» به «به کمترین مقدار چه چیزی نیاز دارم» تغییر میدهد. با به دست آوردن هر لایه از استک از طریق اثبات نیاز، توسعهدهندگان احتمال عیبیابی سیستمهای پیچیده و غیرضروری را در ساعت ۲ صبح کاهش میدهند. بهترین اپلیکیشنهای هوش مصنوعی آنهایی نیستند که خیرهکنندهترین نمودارها را دارند، بلکه آنهایی هستند که هر جعبه در نمودارشان به این دلیل وجود دارد که بدون آن، چیزی در سیستم میشکند.
برای عملی کردن این موضوع، استک فعلی خود را همین امروز بازبینی کنید. یک لایه — مثلاً یک پایگاهداده برداری، یک عامل دوم یا یک کش حافظه — را شناسایی کنید و سعی کنید آن را با یک جایگزین سادهتر جایگزین کنید تا ببینید آیا ارزیابیهای شما واقعاً افت میکنند یا خیر. اجازه دهید واقعیت به شما بگوید که مرحله بعد چه چیزی را بسازید.
گام بعدی شما
- استک فعلی خود را بازبینی کنید و یک لایه (مثلاً پایگاهداده برداری یا عامل دوم) را حذف کنید تا ببینید آیا ارزیابیهای شما واقعاً افت میکنند یا خیر.
- برای هر ویژگی جدید، ابتدا یک مجموعه داده آزمون (Test Set) کوچک شامل ۵۰ نمونه بسازید.
- هر تغییر معماری را در یک چرخه «یک تغییر، یک اندازهگیری، حفظ یا بازگشت» اجرا کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو