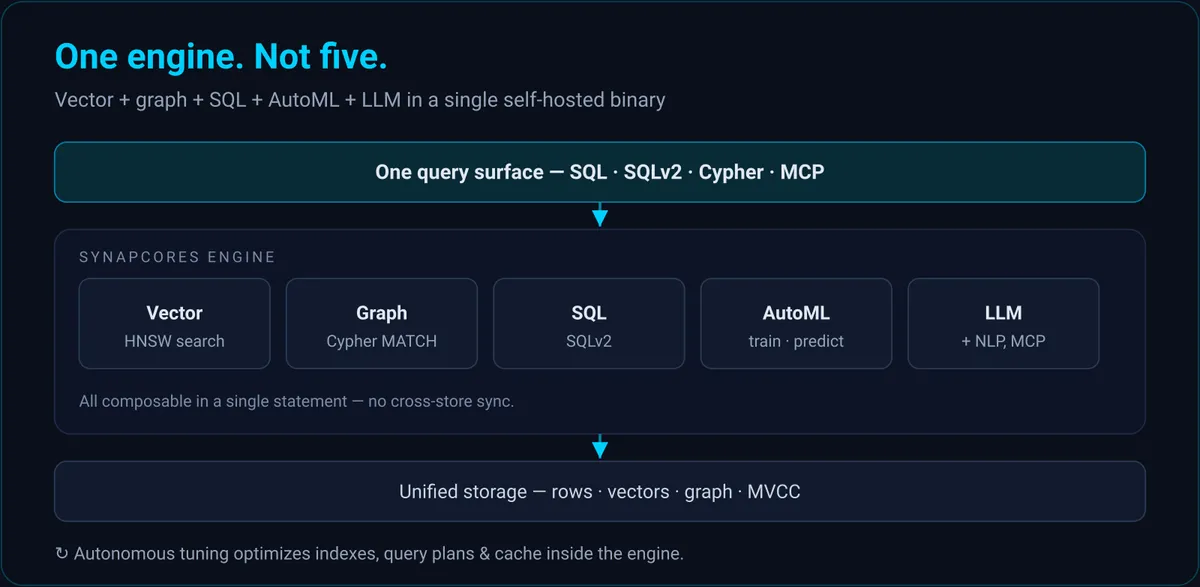
تصور کنید یک فایل اجرایی واحد بتواند جایگزین تمام ابزارهای پراکنده، از پایگاهدادههای برداری گرفته تا سرورهای مدل شود. طبق تحلیل دقیقی که در ۱۱ اکتبر ۲۰۲۶ توسط dev.to منتشر شد، صنعت در حال حرکت به سمت موتورهای بومی هوش مصنوعی است که با بردارها، گرافها و دادههای رابطهای به عنوان شهروندان درجهیک برخورد میکنند.
سالهاست توسعهدهندگان برنامههای هوش مصنوعی را با چسباندن سیستمهای نامرتبط به هم میسازند. شما احتمالاً از یک پایگاهداده رابطهای برای دادههای کاربر، یک پایگاهداده برداری برای بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایهی چه کلمات دیگری است — و یک سرور مجزا برای استنتاج (Inference) — یعنی همان لحظهی آشپزی و تولید جواب، نه دورهی آموزش — استفاده میکنید. این رویکرد «چند-ذخیرهگاهی» بدهی فنی عظیمی ایجاد میکند که ریشه در خطاهای همگامسازی و ناسازگاری دادهها دارد. این پیچیدگیها در واقع بخشی از نقشه عملیاتی استک توسعه AI در سال ۲۰۲۶ است که گذار از مدلهای تکبعدی به معماریهای لایهای را نشان میدهد.
همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، پیچیدگی زیرساخت همیشه نقطه ضعف امنیت و پایداری است. حالا تصور کنید میخواهید پرسشی پیچیده اجرا کنید که همزمان به جستوجوی شباهت، فیلتر رابطهای و یک پیشبینی نیاز دارد. در یک پشته سنتی، شما باید سه درخواست مجزا به سه سیستم مختلف بفرستید. اما یک پایگاهداده بومی هوش مصنوعی این کار را در یک برنامهی اجرا (Query Plan) انجام میدهد و تأخیر و هزینههای عملیاتی را به شدت کاهش میدهد.
تعریف استاندارد بومی هوش مصنوعی
برچسب «بومی هوش مصنوعی» اغلب توسط فروشندگانی استفاده میشود که صرفاً یک ستون برداری به پایگاهدادههای قدیمی اضافه کردهاند. طبق گزارش dev.to، دیتابیسی که فقط ستون برداری اضافه میکند «آماده برای هوش مصنوعی» است، نه بومی. یک موتور واقعاً بومی باید هفت معیار سختگیرانه را داشته باشد:
- مدلهای دادهای یکپارچه: بردارها، گرافها و ردیفهای رابطهای باید در یک موتور باشند تا مرز ثبات دادهها یکی شود و نیاز به همگامسازی بین ذخیرهگاههای مجزا حذف شود.
- جستوجوی برداری بومی: ایندکسگذاری نزدیکترین همسایه تقریبی (معمولاً HNSW) باید در لایهی ذخیرهسازی تعبیه شده باشد و برای برنامهریز پرسوجو (Query Planner) قابل مشاهده باشد، نه اینکه به عنوان یک افزونه بیرونی اضافه شود.
- یادگیری ماشین درون-دیتابیسی: موتور باید بتواند مدلها را از طریق توابعی مثل
EMBED()،PREDICT()و AutoML درست در جایی که دادهها هستند آموزش داده و اجرا کند، نه اینکه دادهها را به یک خط لوله خارجی بفرستد. - پیمایش گراف: پشتیبانی بومی از پیمایش روابط تایپشده برای اجرای تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — در یک موتور واحد ضروری است تا نیاز به پیکربندی دو-ذخیرهگاهی نباشد.
- یکپارچگی با عاملها: پشتیبانی از استانداردهایی مثل پروتکل زمینهٔ مدل (MCP) به عاملها (Agents) اجازه میدهد از دیتابیس به عنوان ابزاری مستقیم، شامل حافظه پایدار برای سیستمهای عاملمحور، استفاده کنند.
- کنترل دادهها: قابلیت میزبانی شخصی (Self-hosting) روی سختافزار خصوصی برای جلوگیری از وابستگی به ابر (Cloud Lock-in) و هزینههای مصرفی، که مستقیماً بر هزینه و انطباق با قوانین تأثیر میگذارد. در این راستا، تفاوت زیرساخت داده در برابر پایگاهداده برداری برای سازمانهایی که نیاز به انطباق نظارتی و ردیابی دقیق دادهها دارند، حیاتی است.
- سادگی عملیاتی: کاهش ردپای تولید (Production Footprint) از پنج سرویس به همراه لایههای اتصال، به یک فایل اجرایی واحد.
چشمانداز پایگاهدادهها در سال ۲۰۲۶
بازار فعلی بر اساس این معیارها به پنج دسته تقسیم میشود. نامگذاری این دستهها مفیدتر از یک جدول رتبهبندی است، چون هر کدام برای حجم کاری خاصی طراحی شدهاند.
پایگاهدادههای برداری اختصاصی
سیستمهایی مثل Pinecone، Qdrant، Weaviate و Milvus همچنان استاندارد طلایی برای جستوجوی شباهت با بازخوانی بالا در مقیاس وسیع هستند. اگر تمام مشکل شما جستوجوی برداری است، اینها بهترین ابزارند. اما طبق تعریف سختگیرانه، آنها بومی نیستند چون گراف، دادههای رابطهای و یادگیری ماشین درون-دیتابیسی در محدوده آنها نیست. شما باید بقیه پشته را دور آنها اسمبل کنید.
پایگاهدادههای رابطهای با افزونه
PostgreSQL به همراه pgvector مسیری عملگرایانه برای تیمهایی است که هوش مصنوعی را به عنوان یک ویژگی کوچک به برنامههای تراکنشی موجود اضافه میکنند. موازنه اینجاست که با رشد نیازهای هوش مصنوعی، رویکرد «افزونه» در نهایت شما را مجبور میکند پشتهای چند-ذخیرهگاهی را تکهتکه بازسازی کنید.
گزینههای گراف-محور
Neo4j و همتایانش برای گرافهای دانش و مسائل گراف-محور فوقالعادهاند. اما قابلیتهای برداری و یادگیری ماشین آنها ثانویه است، به این معنی که حجمهای کاری هوش مصنوعی که به چیزی بیش از پیمایش گراف نیاز دارند، در نهایت به یک پیکربندی دو-ذخیرهگاهی ختم میشوند.
انبار دادههای ابری با توابع هوش مصنوعی
Snowflake (Cortex) و BigQuery برای اجرای هوش مصنوعی روی دادههای تحلیلی تاریخی ساخته شدهاند. آنها برای مسیرهای عملیاتی با تأخیر کم که عاملهای هوش مصنوعی در لحظه (Request Path) به آن نیاز دارند، طراحی نشدهاند.
موتورهای یکپارچه بومی هوش مصنوعی
SynapCores نماینده این دسته جدید است. این موتورها بردار، گراف، SQL و AutoML را در یک فایل اجرایی میزبانی شخصی ادغام میکنند. هرچند شاید در یک محور خاص به عمق یک متخصص نرسند، اما «مشکل اسمبل کردن» قطعات را کاملاً حذف میکنند.
مقایسه جزئیات قابلیتها
برای درک بهتر موازنه، امتیاز این دستهها را در برابر نیازهای اصلی بررسی کنید:
- مدلهای داده یکپارچه: فقط موتورهای یکپارچه پاسخ «بله» کامل دارند. پستگرس و دیتابیسهای گراف پشتیبانی جزئی ارائه میدهند که نیاز به لایههای اتصال دارد. انبار دادههای ابری نیز پشتیبانی جزئی دارند.
- جستوجوی برداری بومی: در دیتابیسهای برداری و موتورهای یکپارچه بومی است. پستگرس از افزونه استفاده میکند. دیتابیسهای گراف آن را ثانویه میبینند و انبار دادههای ابری از ایندکسگذاری تحلیلی استفاده میکنند.
- یادگیری ماشین درون-دیتابیسی: موتورهای یکپارچه AutoML بومی دارند. انبار دادههای ابری توابع ارائه میدهند و دیتابیسهای برداری و پستگرس به خط لولههای خارجی وابستهاند.
- گراف برای GraphRAG: در دیتابیسهای گراف و موتورهای یکپارچه بومی است. برای بقیه، نیاز به افزونهها یا ذخیرهگاههای مجزا است.
- یکپارچگی با عامل/MCP: در موتورهای یکپارچه بومی است و در بقیه به صورت دستی یا با پیادهسازیهای متغیر اجرا میشود.
- میزبانی شخصی / کنترل داده: برای موتورهای یکپارچه، پستگرس و گرافها بله است. برای دیتابیسهای برداری متغیر است و برای انبار دادههای ابری خیر است.
- تعداد سیستمها برای مدیریت: موتور یکپارچه ۱ فایل اجرایی میخواهد، در حالی که پشتههای رابطهای اغلب به ۳ تا ۵ سرویس یا بیشتر نیاز دارند و دیتابیسهای گراف معمولاً به ۲ سرویس یا بیشتر نیاز دارند.
موازنه عملکرد و استقرار
انتخاب دیتابیس اکنون کاملاً به پیچیدگی حجم کاری شما بستگی دارد. اگر سختترین پرسوجوهای شما فقط به جستوجوی شباهت نیاز دارد، دیتابیس برداری تخصصی ابزار درست است. اما اگر پرسوجوهای شما مدلهای داده را رد و بدل میکنند — یعنی ترکیب شباهت، روابط و فیلترها — موتور یکپارچه پاسخ کمهزینهتری است، حتی قبل از اینکه میلیثانیههای ذخیره شده را حساب کنید.
SynapCores یک نسخه Community برای macOS، لینوکس و داکر ارائه میدهد که رایگان است. این نسخه شامل پشتیبانی بومی از MCP و پلاگین حافظه بلندمدت OpenClaw است. توجه داشته باشید قابلیتهایی که به عنوان Enterprise یا در نقشه راه (Roadmap) علامتگذاری شدهاند، امروز در نسخه رایگان CE نیستند، اما تمام ویژگیهای بدون علامت در دسترس هستند. این به توسعهدهندگان اجازه میدهد در ۳۰ ثانیه دستورات پیچیدهای را تست کنند، مانند:
- جستوجوی معنایی اسناد: اجرای جستوجوی برداری با استفاده از SQL ساده.
- پرسوپاسخ چند-گامی GraphRAG: ترکیب دادههای برداری و گراف در یک پرسوجوی واحد.
- تشخیص کلاهبرداری کارت اعتباری: استفاده از AutoML درون-دیتابیسی برای آموزش و پیشبینی.
- تحقیق فروش عاملمحور: استقرار یک عامل با حافظه از طریق SQL.
تحلیل تحریری: مرگ لایه «چسب»
این تغییر سیگنالی برای شروع پایان لایه «ارکستراسیون هوش مصنوعی» است که در دو سال گذشته غالب بود. وقتی دیتابیس بتواند بردارسازی (Embedding)، پیمایش روابط و پیشبینی را در یک مرحله انجام دهد، نیاز به میانافزارهای پیچیده از بین میرود.
برای توسعهدهنده، این به معنای کاهش شدید کارهای «لولهکشی» است. به جای نوشتن اسکریپتهای همگامسازی برای هماهنگ نگه داشتن یک ذخیرهگاه برداری با یک دیتابیس SQL، شما یک دستور SQL واحد مینویسید. این کار فقط میلیثانیههای تأخیر را کاهش نمیدهد، بلکه دستههای کاملی از باگهای مربوط به رانش دادهها (Data Drift) را حذف میکند. این سادهسازی در زیرساخت، مستقیماً بر مسیرهای یادگیری AI در سال ۲۰۲۶ تأثیر میگذارد و تمرکز توسعهدهندگان را از مدیریت ابزارها به سمت حل مسائل تجاری سوق میدهد.
با این حال، ریسک موجود، تلهی «همهفنحریف بودن» است. موتورهای یکپارچه باید ثابت کنند که میتوانند در مقیاس میلیاردها بردار — مشابه آنچه Milvus یا Pinecone مدیریت میکنند — مقیاسپذیر باشند. نبرد سال ۲۰۲۷ بر سر این خواهد بود که آیا موتورهای یکپارچه میتوانند سادگی خود را حفظ کنند و در عین حال با عملکرد خام متخصصان برابری کنند یا خیر.
برای تعیین بهترین گزینه، سه مورد از پیچیدهترین پرسوجوهای خود را ترسیم کنید. بشمارید که برای پاسخ به آنها به چند سیستم مجزا نیاز است؛ گزینهای که به کمترین تعداد سیستم نیاز داشته باشد، برنده است.
گام بعدی شما
- سه مورد از پیچیدهترین پرسوجوهای برنامه خود را بنویسید و تعداد سیستمهای مورد نیاز برای پاسخ به آنها را بشمارید.
- اگر از پشتههای چند-ذخیرهگاهی استفاده میکنید، هزینه زمانی همگامسازی دادهها را محاسبه کنید تا نقطه شکست معماری فعلی را بیابید.
- نسخه رایگان SynapCores را روی داکر نصب کنید و یک نمونه GraphRAG ساده را بدون استفاده از لایههای ارکستراسیون خارجی تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو