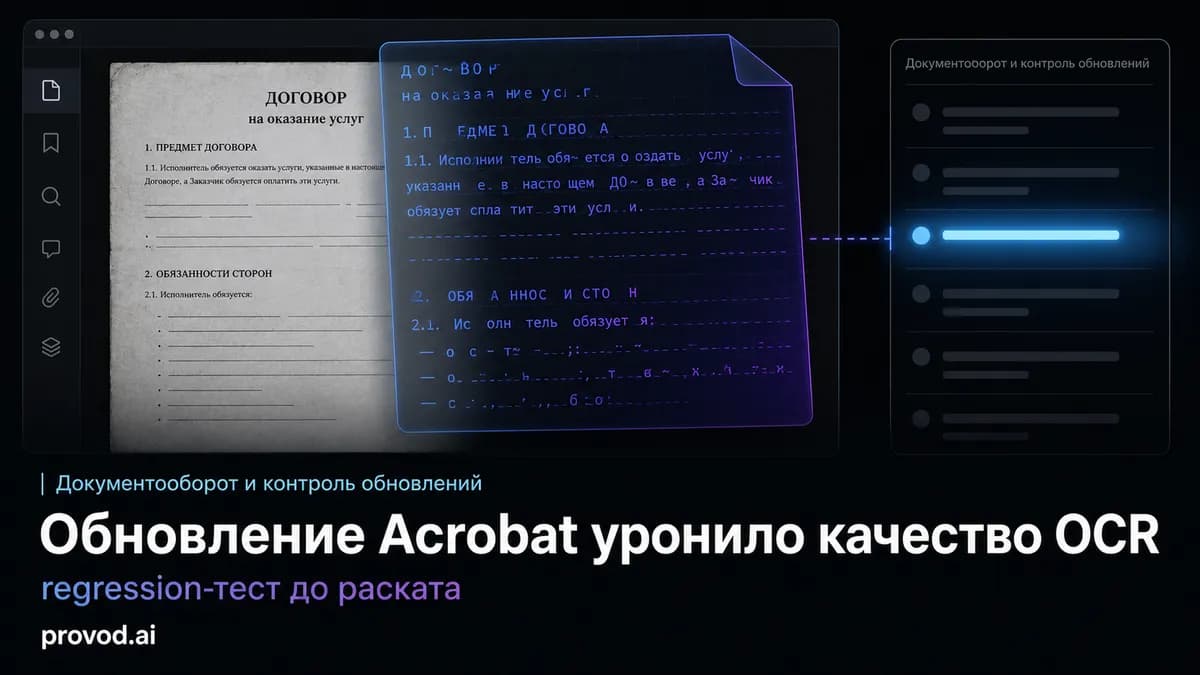
اگر کسبوکار شما بر اساس استخراج خودکار دادهها از اسناد اداره میشود، یک بهروزرسانی خاموش میتواند کل خط لولهی دادههای شما را به زباله تبدیل کند. تصور کنید هزاران سند مالی که پیش از این بهدرستی خوانده میشدند، ناگهان با خطاهای نامحسوس در اعداد و نامها پر شوند و تا زمان صدور گزارش نهایی، کسی متوجه این فاجعه نشود.
به نقل از کاربران انجمن r/Acrobat، در ۱۰ ژوئیه ۲۰۲۶ خبر رسید که بهروزرسانی جدید ادوبی اکروبات (Adobe Acrobat) کیفیت نویسهخوانی نوری (OCR) — شبیه به چشم انسان که متن چاپشده را میبیند و آن را به حروف دیجیتال تبدیل میکند — را بهشدت کاهش داده است. این یک شکست بحرانی است؛ زیرا در بسیاری از سازمانها، OCR اولین حلقه از یک زنجیره است. اگر این مرحله دچار خطا شود، تمام مراحل بعدی از جستوجو و نمایهسازی تا گزارشگیری، دادههای غلط را پردازش میکنند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و پایداری ابزارهای سازمانی اشاره کردیم، شکاف میان «یک شکایت تصادفی در اینترنت» و «یک شکست در محیط تولید» باید با فرآیندهای اعتبارسنجی رسمی پر شود. خطر اصلی اینجاست که بهروزرسانیهای نرمافزاری اغلب بهصورت خودکار رخ میدهند و تیمهای فنی تا زمانی که نتایج نهایی را نبینند، از افت کیفیت بیخبر میمانند. برای بستن این حفرهها، سه مورد حیاتی نیاز است: یک آزمون تکرارپذیر، ردیابی دقیق نسخه و یک برنامه بازگشت (Rollback).

کالبدشکافی رگرسیون
بر اساس مستندات موجود در r/Acrobat، افت کیفیت دقیقاً با چرخه بهروزرسانی ۱۰ ژوئیه ۲۰۲۶ همزمان شده است. برای اثبات این موضوع، باید شهادت کاربران در ردیت را با «دفترچه تغییرات» (Changelog) رسمی ادوبی تطبیق داد. با این حال، باید واقعبین بود؛ طبق گزارشهای بررسی شده، ادوبی هنوز این نقص را بهصورت رسمی پذیرفته یا لیستی از زبانها و کاراکترهای آسیبدیده ارائه نکرده است.
از آنجا که تایید رسمی وجود ندارد، باید گزارشهای جامعه کاربران را به عنوان «فرضیه» در نظر گرفت. یک شکایت ممکن است مربوط به یک پروفایل خراب یا تداخل فونتهای محلی باشد. برای تبدیل این فرضیه به یک حقیقت فنی، شما به سه چیز نیاز دارید: یک مجموعه سند تکرارپذیر، شماره دقیق بیلد (Build Number) و یک معیار عددی.
ساخت مجموعه آزمون تکرارپذیر
یک مجموعه آزمون حرفهای برای OCR، صرفاً چند فایل PDF تصادفی نیست. شما به یک پوشه ثابت و نسخهبندی شده شامل ۱۵ تا ۴۰ پرونده نیاز دارید که دقیقاً سناریوهای واقعی کسبوکارتان را پوشش دهد و از دادههای روزمره جدا باشد.

جزئیات مورد نیاز در مجموعه آزمون
برای پوشش کامل، مجموعه شما باید شامل موارد زیر باشد:
- اسکنهای ماشینی تمیز (300 dpi): این خط پایه شماست؛ OCR باید در اینجا بینقص باشد.
- اسکنهای نویزی موبایل: اسنادی با سایه و کجی که واقعیت ورودیهای حسابداری را نشان میدهد.
- طرحهای پیچیده: فاکتورهایی با جداول و فونتهای بسیار ریز.
- متون چندزبانه: اسنادی با ترکیب زبانها (مثلاً قراردادهای انگلیسی با اصطلاحات حقوقی لاتین).
- لایههای رویهمافتاده: اسنادی که مهرها یا یادداشتهای دستنویس روی متن اصلی آنهاست.
- آزمونهای پایداری: فایلهای PDF بالای ۲۰ صفحه برای اطمینان از عدم کرش یا افت کیفیت در اسناد طولانی.
- قالببندی پیشرفته: اسکنهایی با ستونهای متعدد و صفحهآرایی پیچیده.
هر فایل باید یک «داده مرجع» (Ground Truth) — یعنی نمونه متن صحیح و تاییدشده توسط انسان — داشته باشد. لازم نیست کل سند را بازنویسی کنید؛ کافی است ۵ تا ۱۰ خط کلیدی، مبالغ نهایی و شناسههای طرفین را ذخیره کنید تا بتوانید بهجای جملاتی مثل «به نظر بدتر شده»، از اعداد استفاده کنید.
پیادهسازی سیستم اعتبارسنجی
اعتبار سنجی OCR با نگاه کردن به متن انجام نمیشود. شما باید از نرخ خطای نویسه (CER) و نرخ خطای کلمه (WER) استفاده کنید که نسبت کاراکترهای غلط به کل متن را میسنجند. این معیارها با کتابخانههای فاصله لوانشتاین (Levenshtein distance) محاسبه میشوند.
قاعده ساده است: مجموعه آزمون را قبل از بهروزرسانی اجرا کنید و اعداد را ثبت کنید؛ سپس همان مجموعه را بعد از بهروزرسانی اجرا کرده و مقایسه کنید. اگر CER در چندین فایل افزایش یابد، شما با یک رگرسیون فنی طرف هستید، نه یک احساس شخصی.

برای اتوماسیون این فرآیند، میتوان از یک اسکریپت پایتونی استفاده کرد که متن شناسایی شده را با داده مرجع مقایسه کرده و CER هر فایل را خروجی دهد. معمولاً آستانه ۰.۰۳ برای اسکنهای تمیز به عنوان سیگنال رگرسیون در نظر گرفته میشود:
import Levenshtein
from pathlib import Path

def cer(pred: str, truth: str) -> float:
    truth = truth.strip()
    if not truth: return 0.0
    return Levenshtein.distance(pred, truth) / len(truth)

def run(pred_dir: str, truth_dir: str):
    rows = []
    for t in sorted(Path(truth_dir).glob("*.txt")):
        p = Path(pred_dir) / t.name
        if not p.exists():
            print(f"MISS {t.name}")
            continue
        score = cer(p.read_text("utf-8"), t.read_text("utf-8"))
        rows.append((t.name, round(score, 4)))
    rows.sort(key=lambda r: -r[1])
    for name, score in rows:
        flag = " <--- REGRESS" if score > 0.03 else ""
        print(f"{score:.4f} {name}{flag}")
این ابزار لیستی مرتبشده از نقاط شکست را به شما میدهد و نیاز به ورق زدن دستی اسناد را حذف میکند.
کنترل نسخه و بازگشت (Rollback)
شکایت از رگرسیون OCR بدون ذکر شماره نسخه، فریاد زدن در فضای خالی است. پیش از هر اقدامی، شماره دقیق بیلد را از بخش Help -> About Adobe Acrobat استخراج کنید.
این رشته متنی را با لیست تغییرات رسمی ادوبی تطبیق دهید. پروتکل گزارشدهی شما باید اینگونه باشد:
۱. ثبت دقیق رشتههای نسخه «قبل» و «بعد».
۲. اجرای مجموعه آزمون برای هر نسخه و ذخیره جداول CER.
۳. شناسایی تغییرات ثبت شده در لاگ ادوبی بین این دو نسخه.
۴. ارسال یک تیکت جامع شامل رشتههای نسخه، تفاوتهای CER، ارجاع به لاگ و لینک پست r/Acrobat.

مدیریت بازگشت به نسخه پیشین
اگر رگرسیون تایید شد، باید به نسخه پایدار بازگردید و از تکرار بهروزرسانی خراب جلوگیری کنید:
- غیرفعال کردن بهروزرسانی خودکار: جلوگیری از آپدیت خودسرانه در ماشینهای مدیریتشده.
- نگهداری «بیلد طلایی» (Golden Build): داشتن یک نصبکننده تاییدشده از نسخه قبلی که تست CER را پاس کرده است.
- استقرار متمرکز: استفاده از GPO یا MDM برای اعمال بازگشت در کل شبکه.
- اعتبارسنجی مجدد: اجرای دوباره مجموعه آزمون پس از بازگشت برای اطمینان از بازگشت CER به خط پایه.
به یاد داشته باشید که «منجمد کردن همیشگی» نسخه خطرناک است، زیرا آسیبپذیریهای امنیتی را میپذیرد. چرخه درست این است: منجمد کردن شاخه خراب $\rightarrow$ رصد لاگ ادوبی برای اصلاحیه $\rightarrow$ تست بیلد جدید $\rightarrow$ باز کردن بهروزرسانی.
استراتژی کنترل بهروزرسانی بر اساس مقیاس
| سناریو | کنترل بهروزرسانی | مجموعه آزمون OCR | برنامه بازگشت |
|---|---|---|---|
| ۱ تا ۳ کاربر | بررسی دستی نسخه | مجموعه کوچک (۱۰ فایل) | نصبکننده محلی روی دیسک |
| ۱۰ تا ۵۰ کاربر | غیرفعالسازی آپدیت خودکار | مجموعه (۲۰-۴۰ فایل) + CER | بازگشت متمرکز گروهی |
| سازمانی ۱۰۰+ کاربر | گروههای آزمایشی (Pilot) | مجموعه کامل + متریک در تیکت | GPO/MDM, Golden Build |
| خط لوله سرور | نسخهبندی موتور | رگرسیون ادغامشده با CI | بازگشت Image/Package |
لایه کنترل متقاطع با مدلهای زبانی
از آنجا که OCR معمولاً مرحله نهایی نیست، میتوانید از یک مدل زبانی بزرگ (LLM) — مثل دستیاری که متنهای نامفهوم را میخواند و سعی میکند معنای کلی را حدس بزند — به عنوان سیگنال ثانویه برای شناسایی افت کیفیت در ترافیک زنده استفاده کنید.
سازوکار: قطعه متنی شناسایی شده را به LLM بدهید و بخواهید فیلدهای ساختاریافته (عدد، تاریخ، مبلغ) را همراه با یک «پرچم اطمینان» (Confidence Flag) بازگرداند. اگر LLM ناگهان شروع به بازگرداندن confidence=low کند، این یک هشدار برای بررسی مجموعه آزمون CER شماست.
برای تیمهایی که با محدودیتهای پرداخت یا VPN مواجهاند، سرویس provod.ai دسترسی به مدلهایی نظیر Claude، GPT، Gemini، DeepSeek و Qwen را از طریق یک API سازگار با OpenAI فراهم میکند تا مانع پیادهسازی پردازشهای پس از OCR نشود.

نمونه یک بررسی حداقلی پس از پردازش:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://api.provod.ai/v1",
)

ocr_text = "ООО Ромашка ИНН 7701234567 сумма 154 200,00"
resp = client.chat.completions.create(
    model="claude-opus-4-8",
    messages=[
        {"role": "system", "content": "Return JSON: counterparty, inn, sum. If text is corrupted, set confidence=low."},
        {"role": "user", "content": ocr_text},
    ],
)
print(resp.choices[0].message.content)
باید به خاطر داشت که LLM جایگزین OCR نیست؛ بلکه خروجی آن را تحلیل میکند. جهش خطا در LLM، ماشگی برای بررسی مجموعه CER است، نه جایگزینی برای آن.
مرزهای کنترل
برای داشتن نگاهی واقعبینانه، محدودیتهای این فرآیند را بشناسید:
- پوشش: یک مجموعه آزمون تضمین نمیکند که رگرسیون در اسنادی که در مجموعه نیستند رخ ندهد. با هر شکست در دنیای واقعی، مجموعه آزمون را گسترش دهید.
- بدهی فنی: بازگشت به نسخه قدیمی دلیل ریشه ای را حل نمیکند و ریسک امنیتی ایجاد میکند.
- وابستگی به فروشنده: فقط ادوبی میتواند موتور را تعمیر کند؛ فرآیند شما فقط ابزاری است تا با دادههای محکم، خواستار اصلاح شوید.
- نقش API: ابزارهایی مثل provod.ai دسترسی را فراهم میکنند، اما خط لوله یا مقررات درونسازمانی شما را نمیسازند.
پرسشهای متداول
آیا این قطعاً یک باگ ادوبی است؟
منابع بهطور قطعی این را نمیگویند. فقط یک شکایت جمعی و یک لاگ نسخه وجود دارد. تنها شما میتوانید با استفاده از مجموعه آزمون خود، رگرسیون را تایید کنید.
کدام شماره بیلد آسیب دیده است؟
منابع شماره دقیقی ندادهاند. نسخه خود را در بخش About بررسی کرده و با لاگ تغییرات ادوبی مقایسه کنید.
چه تعداد سند در مجموعه آزمون باشد؟
برای یک دپارتمان معمول، ۲۰ تا ۴۰ فایل کافی است. تنوع (تمیز در برابر نویزی) مهمتر از تعداد است.
افت کیفیت چگونه اندازهگیری میشود؟
با استفاده از CER و WER نسبت به داده مرجع. این کار «احساس بدتر شدن» را به عددی تبدیل میکند که قابل دفاع در برابر مدیریت است.
چکلیست نهایی
۱. تشکیل مجموعه آزمون تکرارپذیر با دادههای مرجع.
۲. پیادهسازی ابزار محاسبه CER.
۳. ثبت دقیق رشتههای نسخه «قبل» و «بعد».
۴. تطبیق نسخهها با لاگ تغییرات ادوبی.
۵. در صورت تایید رگرسیون: بازگشت به بیلد طلایی $\rightarrow$ غیرفعال کردن آپدیت خودکار $\rightarrow$ رصد لاگهای فروشنده.
۶. ادغام چکلیست LLM از طریق provod.ai به عنوان هشدار زودهنگام برای ترافیک عملیاتی.
با دنبال کردن این چارچوب، یک پست تصادفی در r/Acrobat از عامل پانیک سازمانی به کاتالیزوری برای یک فرآیند کنترل کیفیت دادهمحور تبدیل میشود.
گام بعدی شما
- یک مجموعه آزمون شامل ۲۰ سند متنوع (تمیز و نویزی) را همین امروز ایجاد کنید.
- اسکریپت CER را روی نسخهی فعلی خود اجرا کنید تا خط پایه (Baseline) را داشته باشید.
- تنظیمات بهروزرسانی خودکار Acrobat را در سیستمهای حساس غیرفعال کنید.
اما اثر این رگرسیون بر مدلهای استخراج داده در مقیاس بزرگتر حتی پیچیدهتر است — به تحلیل ما دربارهی استقرار مدلهای لبه در خطوط لوله داده مراجعه کنید.



گفتگو