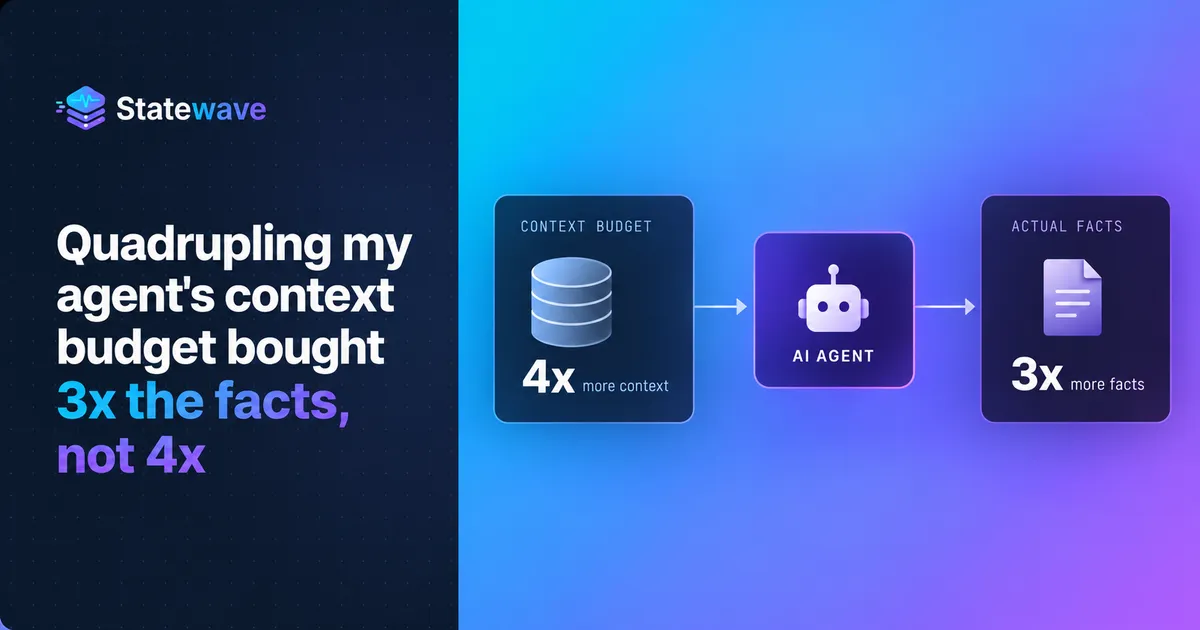
اگر برای بهینهسازی حافظهٔ عاملهای هوش مصنوعی خود فقط روی افزایش پنجرهٔ متنی حساب کردهاید، احتمالاً دارید بودجهٔ محاسباتی خود را دور میریزید. واقعیت این است که در حافظهٔ عاملها، هر توکن اضافی لزوماً به معنای دانستن یک حقیقت جدید نیست.
طبق گزارشی که در ۱۴ سپتامبر ۲۰۲۶ در dev.to منتشر شد، افزایش بودجهٔ حافظه از ۲۰۰ به ۸۰۰ توکن، علیرغم افزایش ۴ برابری هزینه، تنها منجر به بازیابی ۳ برابر بیشترِ حقایق شده است. این یافته فرض رایج توسعهدهندگان را که پنجرهٔ زمینه (Context Window) — مثل میز کاری است که هرچه بزرگتر باشد، جای کاغذهای بیشتری برای مطالعه دارد — را یک ظرف ساده میبینند که هرچه پرتر شود، دانش مدل بیشتر میشود، به چالش میکشد.
در واقع عاملها از روش «کیسهٔ حریصانه» (Greedy Knapsack) برای پر کردن حافظه استفاده میکنند. آنها ابتدا مهمترین خاطرات را بر اساس اولویت میچینند و به محض اینکه مورد بعدی از بودجهٔ توکنها فراتر رود، توقف میکنند. این یعنی اولین حقایق بازیابیشده، متراکمترین و حیاتیترینها هستند و موارد بعدی، کمارزشتر و توکنبرترند.
برای درک بهتر، حافظهٔ عامل خود را مانند یک چمدان تصور کنید. شما ابتدا ضروریترین وسایل را میچینید. وقتی به گوشههای چمدان میرسید، وسایل حجیم و کمفایدهای را به زور میتپانید تا فقط فضا پر شود. شما هزینهٔ فضای چمدان را میپردازید، اما ارزش آنچه اضافه میکنید به شدت افت میکند. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت دقیق ورودیها بسیار حیاتیتر از افزایش کورکورانه حجم آنهاست.
هزینهٔ بازدهی نزولی
به نقل از تحلیل dev.to، هزینهٔ نهایی برای هر خاطرهٔ جدید با گسترش بودجه افزایش مییابد. نویسنده این آزمایش را روی یک کاربر از طریق یک سازماندهندهٔ زمینه در سه سطح بودجهٔ مختلف در اپلیکیشن statewave-personal-assistant اجرا کرد. دادههایی که در ۳ اوت ۲۰۲۶ استخراج شدهاند، روند مصرف توکنها را چنین نشان میدهند:
- بودجه ۲۰۰ توکنی: ۱۷۸ توکن مصرف شد (۸۹٪ بهرهوری). نتیجه: ۲ خاطره (۸۹ توکن برای هر حقیقت).
- بودجه ۵۰۰ توکنی: ۴۴۳ توکن مصرف شد (۸۸.۶٪ بهرهوری). نتیجه: ۴ خاطره (۱۳۳ توکن برای هر حقیقت).
- بودجه ۸۰۰ توکنی: ۷۶۱ توکن مصرف شد (۹۵.۱٪ بهرهوری). نتیجه: ۶ خاطره (۱۵۹ توکن برای هر حقیقت).
این یعنی هزینهٔ نهایی هر حقیقت در این بازه، ۷۹٪ افزایش یافته است. اگر بین ۴۰۰ و ۸۰۰ توکن انتخاب کنید، در واقع بین چهار حقیقت و هشت حقیقت انتخاب نمیکنید؛ بلکه برای دو مورد اضافی که از همان ابتدا امتیازشان کمتر از بقیه بسته بود، دو برابر هزینه میپردازید.
درک بهرهوری و فضای خالی (Slack)
بهرهوری یک معیار حیاتی است زیرا آیتمها بهصورت کامل پذیرفته میشوند. خاطرهای که حتی یک توکن از سقف بودجه فراتر رود، بهجای اینکه نصفه قطع شود، بهطور کامل حذف میشود. در اجراهای تستشده، فضای خالی (Slack) به ترتیب ۱۱.۰٪، ۱۱.۴٪ و ۴.۹٪ بود. توسعهدهندگان باید برای ۵ تا ۱۱٪ فضای خالی برنامهریزی کنند و تصور نکنند که دقیقاً همان تعداد توکن درخواستی را دریافت میکنند.
مکانیسم رتبهبندی حافظه
سامانه از یک لایهٔ رتبهبندی قطعی (Deterministic) استفاده میکند تا تصمیم بگیرد چه چیزی بماند و چه چیزی حذف شود. این فرآیند بسیار ساده است و اساساً یک پر کردن کیسهٔ حریصانه است، مشابه الگوریتم ۱ در مقالهٔ مسیریابی چندعاملی RCR-Router: مرتبسازی بر اساس اهمیت، جمعآوری و توقف در لحظهٔ سرریز.
چهار سیگنال مشخص، ترتیب خاطرات را تعیین میکنند:
- اولویت نوع (۳ تا ۱۰): حقایق پروفایل (۱۰ امتیاز) بر روی دستورالعملها (۸ امتیاز)، خلاصههای اپیزود (۵ امتیاز) و اپیزودهای خام (۳ امتیاز) برتری دارند.
- تازگی (۰ تا ۵): مقیاسی خطی که در آن جدیدترین خاطره بیشترین امتیاز را میگیرد.
- ارتباط با وظیفه (۰ تا ۸): همپوشانی کلمات تا ۵ امتیاز و شباهت کسینوسی (Cosine Similarity) تا ۸ امتیاز میآورد.
- اعتبار زمانی (-۴ تا +۳): حقایق معتبر فعلی ۳ امتیاز میگیرند و موارد منقضیشده ۴ امتیاز کم میشوند.
این وزندهی تضمین میکند که هویت اصلی عامل تحت فشار بودجه باقی بماند و «حرفهای اضافی» ابتدا حذف شوند. برای مثال، یک حقیقت پایدار در پروفایل، تنها بر اساس «نوع»، ۷ امتیاز بیشتر از یک نوبت گفتگوی خام دارد. همچنین یک حقیقت منقضیشده، یک نوسان ۷ امتیازی علیه خودش ایجاد میکند.
قدرت کامپایل (Compilation)
این فرآیند بر یک مرحلهٔ کامپایل متکی است که در آن اپیزودهای خام به حقایق تایپشده با امتیاز اطمینان و منشأ (Provenance) به رویدادهای منبع تبدیل میشوند. همین موضوع است که بودجههای کوچک را کاربردی میکند.
این کار حجم تاریخچهٔ خام را حدود ۷۳٪ کاهش میدهد و ۲۸۰۰ توکن تاریخچهٔ خام را به ۷۶۱ توکن سیگنال خالص تبدیل میکند. در این حالت، دویست نوبت گفتگو میتواند به یک تک حقیقت از نوع profile_fact تبدیل شود. رتبهبندی چرخشهای خام گفتگو به معنای مرتبسازی واحدهایی با تراکم پایین، هزینه توکن بالا و نبود سیگنال اطمینان بود.
تلهٔ «گمشده در میانه»
صرفاً گسترش پنجرهٔ متنی به ۱۲۸ هزار توکن، مشکل بازیابی را حل نمیکند. این گزارش به پژوهش Liu et al. دربارهٔ پدیدهٔ «گمشده در میانه» (Lost in the Middle) اشاره میکند. یافتههای آنها نشان میدهد صحت مدلها یک منحنی U شکل دارد؛ مدلها در بازیابی اطلاعات ابتدایی و انتهایی پرامپت بهترین هستند، اما دادههای دفنشده در وسط را گم میکنند. این موضوع حتی برای مدلهایی که مخصوص زمینهٔ طولانی ساخته شدهاند نیز صادق است.
پر کردن یک پنجرهٔ عظیم با ۱۰۰ هزار توکن تاریخچه، در واقع یک «میانهٔ بزرگ» به مدل تحویل میدهد که ریسک توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد — یا نادیده گرفتن حقایق را افزایش میدهد.
قطعی بودن در برابر فشردهسازی
سازماندهی قطعی — جایی که یک موضوع، رشتهٔ وظیفه، بودجه و نقطهٔ زمانی یکسان همیشه خروجی یکسانی تولید میکند — ارزشمندتر از فشردهسازی خام است.
پژوهشگران دانشگاه Penn State جایگزین این روش را از طریق فشردهسازی موازی زمینه اندازهگیری کردند. آنها دریافتند که با رشد زمینه، هم حجم خروجی مدل و هم اطلاعات حفظشده در هر اجرا تغییر میکند. دستورالعملهای پرامپت برای طولهای خاص خلاصه، تا حد زیادی نادیده گرفته میشوند. اگر مرحلهٔ فشردهسازی شما یک فراخوانی مدل زبانی بزرگ (LLM) باشد، لایهٔ بازیابی شما غیرقطعی میشود و هر ارزیابی، دو متغیر را همزمان میسنجد. قطعی بودن تضمین میکند که وقتی پاسخی تغییر میکند، این تغییر از مدل یا پرامپت ناشی شده است، نه از تغییر در زمینه.
راهنمای پیادهسازی برای توسعهدهندگان
برای بهینهسازی بودجهٔ حافظهٔ یک عامل، نویسنده یک چارچوب ششمرحلهای را پیشنهاد میکند:
- ابزارگذاری را شروع کنید: تعداد توکنهای بازگشتی و تعداد خاطرات را در هر فراخوانی ثبت کنید. اگر بهرهوری شما همیشه زیر ۸۵٪ است، افزایش بودجه هیچ تغییری ایجاد نمیکند.
- از ۸۰۰ توکن شروع کنید: هدف را روی ۵ تا ۸ حقیقت کامپایلشده بگذارید که معمولاً بین ۶۰۰ تا ۱۲۰۰ توکن برای اندازهٔ معمول حقایق و دستورالعملها هزینه دارد.
- هزینههای ثابت را محاسبه کنید: پرامپتهای سیستمی و طرحهای ابزار (Tool Schemas) اغلب ۲ تا ۴ هزار توکن مصرف میکنند و هر بار محاسبه میشوند. حافظه معمولاً کوچکترین ردیف هزینه است.
- منحنی نهایی را رصد کنید: یک تست سه-بودجهای اجرا کنید تا نقطهای را بیابید که در آن ۲۰۰ توکن اضافی دیگر تأثیری در پاسخهای عامل ندارد.
- بودجههای نقشمحور: برای هر عامل بودجه متفاوتی تعیین کنید؛ یک برنامهریز به طرحهای ساختاریافته نیاز دارد، اما یک اجراکننده به جزئیات کمتری نیاز دارد.
- کامپایل غیرهمزمان: فرآیند فشردهسازی حافظه را از مسیر اصلی (Hot Path) خارج کنید. آن را بهصورت زمانبندیشده (هر N اپیزود یا شبانه) با استفاده از حالت غیرهمزمان و یک Job ID برای نظارت اجرا کنید.
نقاط شکست احتمالی
دو ریسک اصلی باقی میماند. اول، استخراج بد در مراحل بالادستی؛ در این صورت عامل صرفاً «زبالهها» را با دقت رتبهبندی کرده و آنها را دقیقاً در ۸۰۰ توکن جای میدهد. کامپایلر در ابتدای تمام مسیر قرار دارد.
دوم، تغییر توالی پرامپتها برای صرفهجویی در توکنها میتواند کش پیشوند KV (KV prefix cache) را باطل کند. همانطور که نویسندگان TokenPilot اشاره کردهاند، این خطاهای کش میتواند از نظر تأخیر و محاسبات، بیشتر از توکنهای ذخیره شده هزینه داشته باشد. راه حل، ایجاد یک پیشوند پایدار و تغییر در بخش انتهایی است.
این موضوع با فشردهسازی در سطح توکن متفاوت است. پژوهشهای AGORA نشان میدهد که فشردهسازهای استخراجی در سطح توکن که در ۱۷ پیکربندی عامل تست شدند، باعث فروپاشی هر ۱۷ مورد شدند زیرا فشردهسازی، گرامر عملیاتی (Action Grammar) را میشکست. حذف کامل یک حقیقت با رتبه پایین، عملیاتی متفاوت و ایمنتر از حذف توکنها در داخل یک حقیقت خوشساخت است.
برای توسعهدهندگان، نتیجه روشن است: به دنبال پنجرههای بزرگتر نباشید و شروع به اصلاح سیگنال رتبهبندی کنید. هدف این نیست که موارد بیشتری را جای دهید، بلکه این است که مطمئن شوید ارزشمندترین بایتها، همانهایی هستند که انتخاب میشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو