تصور کنید هر بار که میخواهید با دستیار کدنویسی خود صحبت کنید، مدل مجبور باشد ابتدا یک دفترچه راهنمای ۱۰۰ صفحهای را بخواند تا بفهمد شما چه میخواهید. این حجم از اطلاعات اضافی، دقیقاً همان چیزی است که باعث میشود مدلهای پیشرفته در سادهترین دستورات شما دچار خطا شوند.
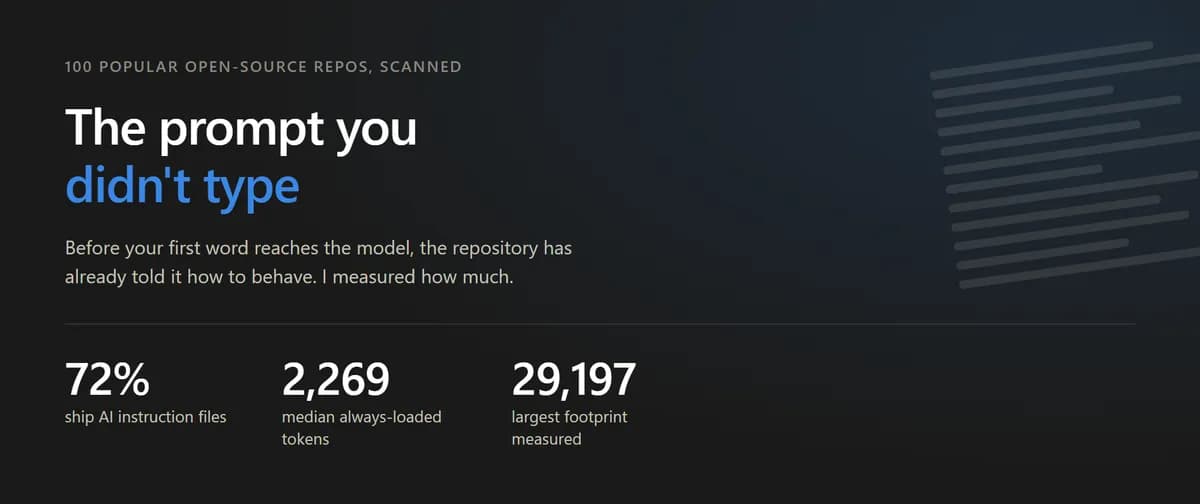
طبق گزارشی که در ۱۵ ژوئیه ۲۰۲۶ در وبسایت dev.to منتشر شد، ۷۲٪ از مخازن کد متنبازِ پیشرو در حوزه هوش مصنوعی، فایلهای دستوری پنهانی دارند که رفتار عامل (Agent) را پیش از اولین پرامپت کاربر تعیین میکنند. بررسی ۱۰۰ مخزن نشان میدهد فایلهایی مثل CLAUDE.md یا .cursorrules لایهای نامرئی از پیکربندیهای رفتاری ایجاد میکنند که اغلب از دید توسعهدهندگان پنهان میماند.
این بستر متنی نامرئی اکنون به یک مشکل جدی تبدیل شده است، زیرا بخش بزرگی از پنجرهٔ زمینه (Context Window) — شبیه به میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — را اشغال میکند. همانطور که در تحلیل قبلی ما دربارهی مدیریت حافظه در مدلهای زبانی اشاره کردیم، اشباع شدن این فضا منجر به فراموشی دستورات کلیدی میشود. وقتی لیستی از قوانین ۱۰ صفحهای وجود داشته باشد، مدل احتمالاً مهمترین محدودیتهای کدنویسی را بهدلیل دفن شدن زیر هزاران توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک — نادیده میگیرد. این چالش با مفاهیمی چون کمبود «هوش محیطی» در عاملهای کدنویس همسو است که باعث شکست آنها در مقیاس صنعتی میشود.

به نقل از دادههای این审计 (Audit)، شکاف عمیقی بین کاربران سبک و سنگین وجود دارد. در حالی که میانگین هر پروژه ۲۲۶۹ توکن دستوری دارد، برخی پروژهها به اعداد خیرهکنندهای رسیدهاند. برای مثال، پروژه cline با ۲۹۱۹۷ توکن در ۱۹ فایل مختلف در صدر این فهرست است و coder با ۲۳۸۷۰ توکن در رده دوم قرار دارد. حتی پروژه bun نیز ۹۰۸۴ توکن را عمدتاً در یک فایل CLAUDE.md حمل میکند.

علاوه بر حجم زیاد، این بررسی مشکلی بحرانی در منطق «فورکینگ» یا تکرار قوانین کشف کرد. از بین ۵۴ مخزنی که چندین فایل دستوری داشتند، در ۲۸ مورد قوانین بهصورت تکراری در ابزارهای مختلف درج شده بود. به عنوان نمونه، پروژه documenso قانون «هرگز از if تکخطی استفاده نکن» را بهطور یکسان در هر دو فایل .cursorrules و AGENTS.md نگه داشته بود. این وضعیت باعث ایجاد چندین منبع حقیقت میشود و هر بار که یک فایل بهروزرسانی شود و دیگری فراموش گردد، رفتار مدل دچار انحراف میشود. برای مقابله با این ناپایداری، روشهایی مانند جایگزینی گیتهای مکانیکی با مهندسی پرامپت پیشنهاد شده تا نرخ خطای عاملها کاهش یابد.

برای حل این نبودِ نظارت، پژوهشگر این مطالعه ابزاری به نام ContextGuard را توسعه داد. این افزونه برای VS Code، با دستوراتی مشابه کد تولیدی برخورد میکند و در نوار وضعیت، مجموع توکنهای دستوری را نمایش میدهد. این ابزار فایلهای بیش از حد بزرگ یا ارجاعات شکسته را شناسایی کرده و یک پرامپت پنهان را به یک معیار قابل اندازهگیری تبدیل میکند که توسعهدهنده بتواند آن را بازبینی کند.
این تغییر دیدگاه نشان میدهد که فایلهای دستوری باید به عنوان آثار نرمافزاری درجهیک در نظر گرفته شوند. قوانینی که نحوه نوشتن کد یا ساختار کامیتها را تغییر میدهند، در واقع پیکربندیهای رفتاری هستند. رشد کنترلنشده این لایهها، هزینهی مضاعفی برای توسعهدهنده دارد: ابتدا کاهش فضای پنجرهٔ زمینه و سپس تضعیف توجه مدل به جزئیات.
برای یک توسعهدهنده کاربردی، این یعنی شکست مدل در اجرای یک قانون، همیشه به معنای ضعف مدل نیست. اغلب، مدل صرفاً در حال جنگ با کوهی از سیاستهای متناقض و انباشته شده است. بررسی این فایلها با همان سختگیریِ یک Pull Request، اکنون پیشنیاز دستیابی به گردشهای کاری قابلاعتماد در سامانههای عاملمحور است.
گام بعدی شما
- تمام فایلهای پنهان با پسوند
.mdیا.rulesرا در ریشه پروژه خود بررسی کنید. - قوانین تکراری بین ابزارهای مختلف (مانند Cursor و Claude) را حذف کرده و آنها را در یک فایل واحد متمرکز کنید.
- حجم توکنهای سیستمی خود را بسنجید تا از اشباع شدن پنجرهٔ زمینه مدل جلوگیری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و مدیریت حافظه در مقیاس صنعتی مراجعه کنید.



گفتگو