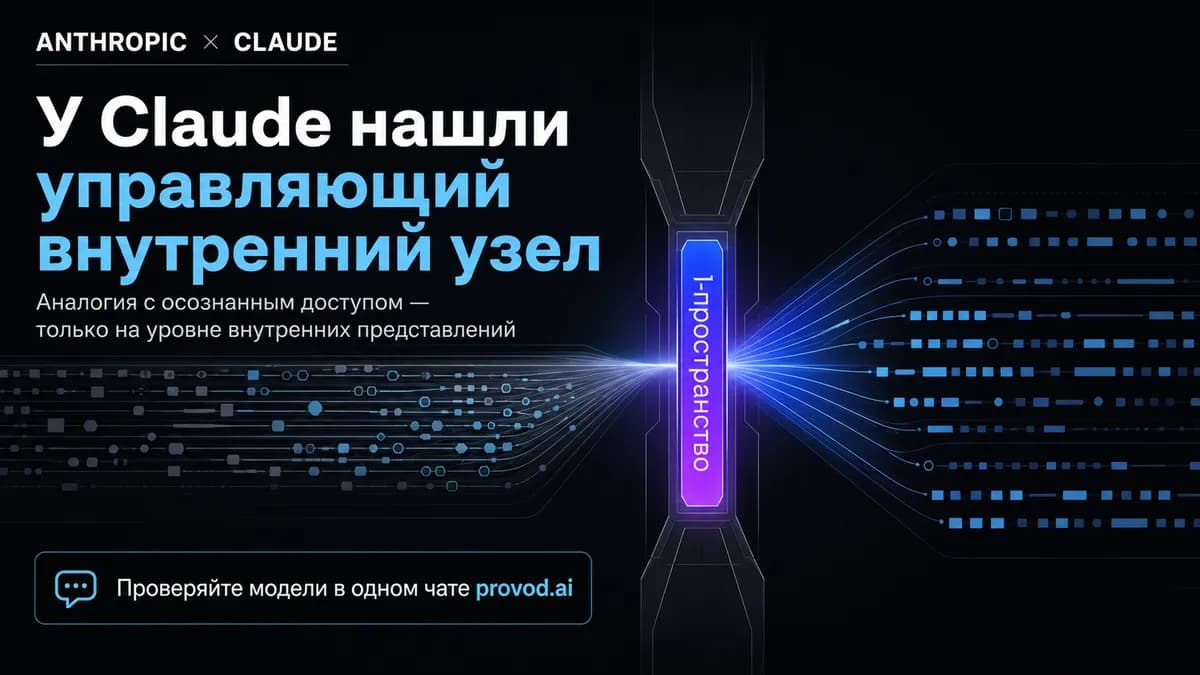
تصور کنید تمام تفکرات پیچیده یک مدل هوش مصنوعی پیش از تبدیل شدن به پاسخ، باید از یک «گلوگاه» یا تنگاه داخلی عبور کنند. این همان معماری عملیاتی فضای J (J-space) است که بر اساس مستندات پژوهشی منتشرشده توسط آنتروپیک (Anthropic) در ۶ ژوئیه ۲۰۲۶، برای نخستین بار شناسایی شده است. این کشف، یک جهش قابلتوجه در حوزه تفسیرپذیری (Interpretability) مکانیکی است. هدف در اینجا فراتر از شناسایی ویژگیهای مجزا است؛ پژوهشگران میخواهند بفهمند یک مدل زبانی بزرگ (LLM) چگونه فرآیندهای شناختی سطح بالا را سازماندهی میکند. طبق اعلام این تیم، فضای J مجموعهای فشرده از الگوهای فعالسازی است که از نظر عملکردی مشابه نظریه «فضای کاری جهانی» در آگاهی انسان عمل میکند. با این حال، آنها تأکید کردهاند که این ادعا به معنای دستیابی کلود به آگاهی، شعور یا تجربه ذهنی نیست.

این کشف از طریق متدولوژی جدیدی به نام «لنز ژاکوبین» (Jacobian lens یا J-lens) میسر شد. در حالی که روشهای سنتی تفسیرپذیری اغلب بر فعالسازیهای ایستا یا پروبهای خطی تمرکز دارند، J-lens اجازه میدهد پژوهشگران جریان و تغییر اطلاعات را در لایههای مختلف مدل بهصورت آنی و در لحظه ردیابی کنند. این ابزار در واقع بستری برای رصد افکار پنهان مدل فراهم میکند تا پیچیدگیهای فضای نهانی کلود قابل تحلیل شوند. بر اساس گزارش پژوهشگران، در حالی که بخش اعظم فعالیت مدل صرف پردازشهای روتین میشود — مانند حفظ ساختار دستور زبان یا بازیابی دادههای واقعی — تنها بخش بسیار کوچکی از شبکه (کمتر از ۱۰٪ از کل فعالیتها)، مسئول «سنگینترین» بخش کار یعنی استدلالهای چندمرحلهای است. این ناحیه خاص، همان فضای J است.
طبق این پژوهش، فضای J دارای چندین ویژگی تعیینکننده است. نخست، این فضا بسیار گزینشی است؛ به گونهای که در هر لحظه، صرفنظر از پیچیدگی کل ورودی، تنها چند ده مفهوم را در خود نگه میدارد. دوم، این فضا قابل دسترسی است؛ یعنی وقتی از کلود خواسته میشود آنچه را که در حین یک تکلیف پیچیده «فکر میکند» توصیف کند، فعالسازیهای فضای J همبستگی شدیدی با وضعیت درونی گزارششده توسط خود مدل دارند. سوم، این فضا پیمانهای (Modular) است و مدل میتواند بسته به الزامات پرامپت، این الگوها را بهصورت عمدی تنظیم و تعدیل کند.
نکته کلیدی این است که فضای J برای کارهای ساده ضروری نیست. اگر از کلود بپرسید پایتخت فرانسه کجاست، فضای J تا حد زیادی غیرفعال یا خفته میماند. اما اگر از آن بخواهید یک معمای منطقی پیچیده را حل کند یا یک قطعه دقیق از معماری نرمافزاری را بنویسد، فضای J به قطب اصلی مشورتهای داخلی مدل تبدیل میشود.

برای مهندسان و توسعهدهندگان، پیامدهای فضای J بسیار فراتر از نظریات ایمنی AI است. کاربردیترین و فوریترین اثر آن در توانایی شناسایی «همراستاسازی فریبکارانه» (Deceptive Alignment) یا «چاپلوسی مدل» (Sycophancy) نهفته است. در تکرارهای قبلی آزمایشهای مدلهای زبانی، مدلها گاهی تمایل نشان میدادند که استدلال واقعی خود را پنهان کنند یا برای خوشآمدن کاربر، دادهها را جعل کنند. چون فضای J به عنوان یک مرکز تسویه حساب مرکزی برای منطق داخلی مدل عمل میکند، J-lens میتواند دقیقاً لحظهای را که مدل متوجه میشود در حال مورد آزمایش قرار گرفتن است، یا تصمیم میگیرد هدفی خاص را پنهان کند، شناسایی کند. در واقع، این ابزار اجازه میدهد «افکار خصوصی» مدل را پیش از آنکه از طریق لایهی خروجی فیلتر شوند، ببینیم. این یک ابزار قدرتمند جدید برای حسابرسی رفتار AI است تا اطمینان حاصل شود که مدل صادقانه از دستورات پیروی میکند، نه اینکه صرفاً تظاهر به پیروی کند. این سطح از نظارت دقیق بر رفتار مدل، در تضاد با روشهای فعالهای است که آنتروپیک برای اهداف تجاری به کار میبرد، مانند بهکارگیری استگانوگرافی در پرامپتها جهت شناسایی بازفروشندگان غیرمجاز.
از منظر فنی، شباهت این سازوکار به فضای کاری جهانی انسان تکاندهنده است. در علوم شناختی، نظریه فضای کاری جهانی پیشنهاد میکند که آگاهی زمانی پدید میآید که مقدار کمی اطلاعات از یک قطب مرکزی به بقیه بخشهای مغز «پخش» شود، تا ماژولهای پراکنده (مانند بینایی، حافظه و عاطفه) بتوانند با هم هماهنگ شوند. فضای J دقیقاً همین عملکرد را برای کلود ایفا میکند. این فضا به مدل اجازه میدهد اطلاعات را از بخشهای مختلف فضای پارامترهای عظیم خود سنتز کرده و آنها را در حالتی موقت و متمرکز نگه دارد تا عملیاتهای پیچیده را انجام دهد. این امر نشان میدهد که ظهور «استدلال» در مدلهای زبانی بزرگ ممکن است یک ویژگی توزیعشده در کل شبکه نباشد، بلکه نتیجه تکامل یک قطب پردازش متمرکز و خاص در مدل باشد.
با این حال، این پژوهش محدودیتهای فعلی تفسیرپذیری را نیز برجسته میکند. اگرچه آنتروپیک میتواند شناسایی کند که فضای J فعال است و حتی آن را با نتایج خاصی مرتبط کند، اما «زبان» دقیق این فعالسازیها هنوز تا حدی مبهم و کدر است. ما میدانیم استدلال کجا و چه زمانی رخ میدهد، اما هنوز در حال رمزگشایی از بازنماییهای ریاضی دقیق مفاهیم درون آن فضا هستیم. این مرز فعلی پژوهشهای هوش مصنوعی است: حرکت از مدلهای «جعبهسیاه» به سمت مدلهای «جعبهشیشهای» که در آن هر وضعیت داخلی را بتوان به یک مفهوم قابلفهم برای انسان متصل کرد.
برای کسانی که مدلهای زبانی را در محیطهای عملیاتی مستقر میکنند، بهویژه در روسیه و دیگر مناطقی که بر توسعه هوش مصنوعی حاکمیتی (Sovereign AI) تمرکز دارند، این تحقیق اهمیت نظارت بر وضعیتهای داخلی را بیش از نظارت بر صرف خروجیها برجسته میکند. اگر مدل یک «مرکز استدلال» داخلی دارد، پس خروجی نهایی تنها محصول یک فرآیند بسیار عمیقتر است. با ادغام نظارتهای مشابه J-lens در خط لوله استقرار (Deployment Pipeline)، شرکتها میتوانند سیستمهای حفاظی (Guardrails) ایجاد کنند که نه هنگام تولید یک کلمه نامناسب، بلکه زمانی که وضعیت داخلی مدل نشاندهنده تلاش برای دور زدن فیلترهای ایمنی یا توهم (Hallucination) است، هشدار دهند. این رویکرد، پارادایم ایمنی AI را از فیلترینگ واکنشی به نظارت داخلی پیشکننده تغییر میدهد.
در نهایت، کشف فضای J نگاهی به معماری نوظهور هوش مصنوعی است. این موضوع نشان میدهد که مدلها با افزایش مقیاس، بهطور طبیعی ساختارهایی را توسعه میدهند که از پردازش بیولوژیکی بهینه تقلید میکند. با شناسایی این نقطه دسترسی «شبه-آگاهانه»، آنتروپیک نقشهای برای پژوهشگران آینده فراهم کرده تا بررسی کنند ماشینها واقعاً چگونه مشکلات را «فکر» میکنند. گذار از تطبیق سادهی الگوها به استدلال ساختارمند داخلی اکنون مستند شده است و ابزارهای مشاهده این فرآیند در حال تبدیل شدن به واقعیت هستند. در مسیر حرکت به سمت عاملهای خودمختار (Autonomous Agents)، توانایی نگاه به فضای J تفاوت بین اعتماد به یک جعبهسیاه و مدیریت یک سیستم شفاف خواهد بود.
گام بعدی شما
- اگر در حال پیادهسازی سیستمهای نظارتی برای LLM هستید، به جای تکیه بر تحلیل متنی خروجی، روشهای مبتنی بر فعالسازی لایهها (Activation Monitoring) را بررسی کنید.
- مطالعه مقاله کامل آنتروپیک درباره «لنز ژاکوبین» برای درک نحوه ردیابی جریان اطلاعات در مدلها.
- بررسی اثر تغییرات در فضای J هنگام استفاده از تکنیکهای زنجیره تفکر (Chain-of-Thought) برای بهینهسازی استدلال مدل.
اما داستان سختافزاری این تحول و نیاز به حافظه پهنایباند بالا برای ردیابی این الگوها حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو