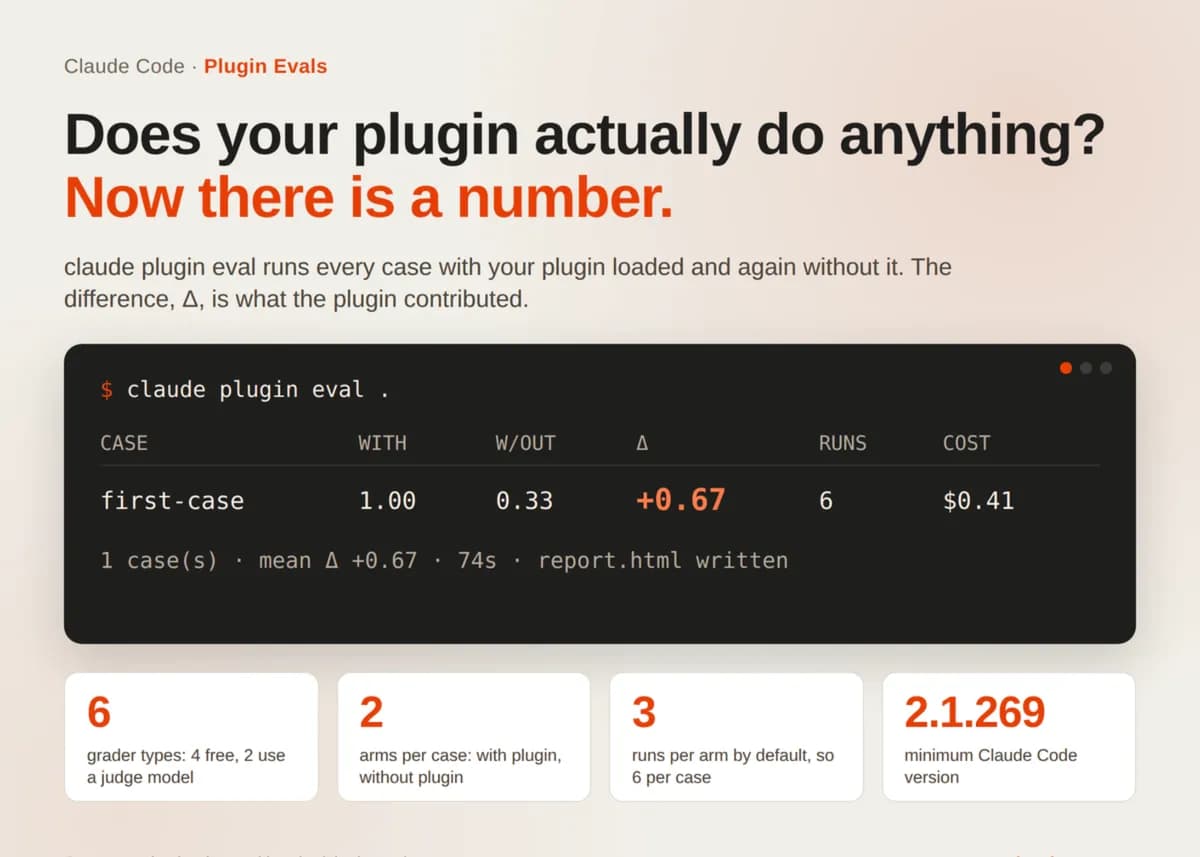
اگر یک عامل هوش مصنوعی در پاسخ به درخواست کاربر، ابزاری را فراخوانی نمیکند، دیگر لازم نیست حدس بزنید که مشکل از پرامپت است یا مدل. آنتروپیک (Anthropic) با عرضه یک گردشکار ارزیابی جدید برای Claude Code (نسخه ۲.۱.۲۶۹ به بالا)، امکان اندازهگیری دقیق اثرگذاری مهارتها را فراهم کرد تا توسعهدهندگان بفهمند آیا یک قابلیت پس از بهروزرسانی مدل همچنان کار میکند یا خیر، یا اینکه آیا عملکرد آن از یک مدل خام (Bare Model) بهتر است یا خیر.
این ابزار در واقع یک سیستم مقایسهای است؛ شبیه به آزمایشهای پزشکی که یک گروه را با دارو و گروه دیگر را با دارونما میسنجند تا اثر واقعی دارو مشخص شود. همانطور که در تحلیل قبلی ما دربارهی اجرای مدلهای پیشرو در Claude Code اشاره کردیم، تمرکز اکنون از «اتصال ساده» به «اعتبارسنجی رفتاری» تغییر کرده است. در حالی که اعتبارسنجیهای پایه فقط بررسی میکنند که آیا نحو (Syntax) یک مانیفست درست است، این ارزیابیهای جدید میسنجند که آیا مدل در مواجهه با درخواستهای واقعی، واقعاً تصمیم میگیرد از ابزار استفاده کند یا خیر. این رویکرد برای مقابله با چالشاتی است که در پژوهش Armature درباره سوگیری ابزاری در عاملهای کدنویس شناسایی شده بود و نشان میداد مدلها لزوماً بهینهترین ابزار را انتخاب نمیکنند.
زمینه و استقرار
این گردشکار هماکنون روی Claude Code نسخه ۲.۱.۲۶۹ یا نسخههای جدیدتر قابل استقرار است. این سیستم روی هر دایرکتوری که شامل یک مانیفست plugin.json یا .claude-plugin/plugin.json باشد، و همچنین روی پلاگینهای دایرکتوری-محور (skills-directory) کار میکند.
این ابزار بهطور مشخص به سه پرسش حیاتی پاسخ میدهد که پیش از این برای توسعهدهندگان پلاگین غیرقابل اندازهگیری بود: اول اینکه آیا مهارت اصلاً فعال (Trigger) میشود؟ دوم اینکه آیا این مهارت پس از یک ویرایش یا تغییر مدل، همچنان پایداری خود را حفظ میکند؟ و سوم اینکه آیا عملکرد آن واقعاً از یک مدل بدون پلاگین بهتر است؟ از آنجا که هر اجرای ارزیابی و هر داور (Judge Grader) در واقع یک فراخوانی واقعی مدل است، هزینهی این عملیات طبق طرح کاربر یا حساب API محاسبه و کسر میشود.
به گزارش MarkTechPost، این سامانه هر مورد آزمایشی را دو بار اجرا میکند: یک بار با پلاگین بارگذاری شده (که به آن With-arm یا بازوی آزمایش گفته میشود) و یک بار بدون آن (Without-arm یا بازوی کنترل). تفاوت بین این دو امتیاز که با نماد Δ (دلتا) نمایش داده میشود، تنها معیاری است که ثابت میکند پلاگین واقعاً ارزش افزوده ایجاد کرده است. اگر یک مورد آزمایشی در هر دو حالت امتیاز ۱.۰ بگیرد، به این معناست که موفقیت مدل به دلیل وجود پلاگین نبوده است.
مکانیسم امتیازدهی
توسعهدهندگان برای قضاوت خروجیها میتوانند از ۶ نوع داور مختلف استفاده کنند:
- داوران رایگان: شامل Regex،
tool_used(بررسی استفاده از ابزار)،tool_order(بررسی ترتیب فراخوانی ابزارها) وfile_exists(بررسی وجود فایل) هستند که مستقیماً از روی ترنسکریپتها و فایلهای دیسک محاسبه شده و هزینهای ندارند. - داوران پولی: داور
llmکه پاسخها را بر اساس معیارهای متنی (Prose Criteria) میسنجد و داورbaselineکه نتایج را با یک پاسخ مرجع مقایسه میکند؛ هر دو نیازمند پرداخت هزینه استنتاج (Inference) هستند.
هر مجموعه ارزیابی در یک دایرکتوری به نام evals/ قرار میگیرد. هر مورد آزمایشی (Case) یک زیردایرکتوری است که شامل یک فایل prompt.md و یک پوشه graders/ است. متن پرامپت دقیقاً همانطور که نوشته شده به کلود ارسال میشود و ارجاعات @path در اینجا بسط داده نمیشوند.
توسعهدهندگان میتوانند محدودیتهای خاصی را در متادیتای (Frontmatter) فایل prompt.md تعریف کنند؛ از جمله max_turns (پیشفرض ۱۰ دور)، timeout_seconds (پیشفرض ۳۰۰ ثانیه)، نوع مدل، تگها و allowed_tools (ابزارهای مجاز). داوران نیز فایلهای مارکداون هستند که در متادیتای آنها نوع داور و وزن یا بازوی اختیاری تعیین میشود.
یکپارچگی با CI و نتایج
برای کسانی که این ابزار را در خط لولههای خودکار (CI) ادغام میکنند، این سیستم قابلیت ایجاد گیتهای امنیتی (CI Gate) را دارد. یک فراخوانی مستند شده در CI از دستور claude plugin eval . به همراه فلگهایی مانند --threshold 0.8 (برای تعیین حد نصاب موفقیت)، --max-cost-usd 20 (برای جلوگیری از هزینههای پیشبینینشده) و --trust-plugin استفاده میکند. فلگهای دیگر شامل --json results.json برای خروجی متنی، --model claude-sonnet-5 و --judge-model claude-haiku-4-5 برای تعیین مدل داور است.
در صورتی که فلگ --trust-plugin استفاده نشود و ترمینالی در دسترس نباشد، هرگونه تلاش برای اجرای یک کد غیرقابل اعتماد با کد خروجی ۱ رد میشود. نتایج در مسیر evals/results/<timestamp>/report.html ذخیره میشوند که شامل آرای مدل داور و احکام هر داور است. این گزارشها بهصورت پیشفرض در claude.ai منتشر میشوند، مگر اینکه فلگ --no-publish فعال باشد.
به عنوان یک مثال عینی از مستندات، یک مورد خاص با پلاگین امتیاز ۱.۰۰ و بدون آن ۰.۳۳ گرفته است که منجر به Δ مثبت ۰.۶۷ در ۶ بار اجرا شده است. این اجرای خاص ۷۴ ثانیه زمان برده و هزینه تخمینی آن ۰.۴۱ دلار بوده است.
این تغییر در ابزارها به این معناست که توسعهدهندگان دیگر مجبور نیستند حدس بزنند آیا تغییر در پرامپت باعث بهبود شده یا پلاگین نادیده گرفته شده است. آنتروپیک با جداسازی سهم پلاگین، با مهارتهای هوش مصنوعی مانند واحدهای نرمافزاری سنتی برخورد میکند که نیاز به تست رگرسیون (Regression Testing) دارند.
برای کاربر نهایی، این رویکرد احتمالاً به معنای کاهش توهم (Hallucination) — شبیه به دوستی که با اطمینان خاطرهای ساختگی را تعریف میکند — در فراخوانی ابزارها و رفتار قابلاعتمادتر عاملها در محیط عملیاتی است. این رویکرد در کنار استفاده از فایلهای CLAUDE.md برای کنترل توهمات در React Native، لایهی جدیدی از دقت را به توسعهی نرمافزار با هوش مصنوعی میافزاید. این سیستم، انضباطی مبتنی بر شواهد را جایگزین روش آزمون و خطای سنتی میکند.
توسعهدهندگان میتوانند با دستور claude plugin eval init شروع کنند تا سیستم بهطور خودکار پلاگین را تحلیل کرده و موارد آزمایشی و داوران اولیه را پیشنهاد دهد. در محیط CI، فلگ --bare <name> به جای تحلیل، یک قالب خالی (Blank Template) ایجاد میکند.
باید منتظر ماند و دید که این چارچوب ارزیابی در بهروزرسانیهای آینده Claude Code چگونه برای پشتیبانی از ارکستراسیون چندعاملی یا بنچمارکهای بین-مدلی (Cross-model) گسترش مییابد.
گام بعدی شما
- اگر پلاگین برای Claude Code نوشتهاید، از دستور
eval initبرای شناسایی نقاط ضعف رفتاری مدل استفاده کنید. - در محیط CI، حتماً از فلگ
--max-cost-usdاستفاده کنید تا از مصرف ناگهانی اعتبار API جلوگیری شود. - تفاوت امتیاز (Δ) را به جای امتیاز کلی، به عنوان معیار اصلی موفقیت مهارت در نظر بگیرید.



گفتگو