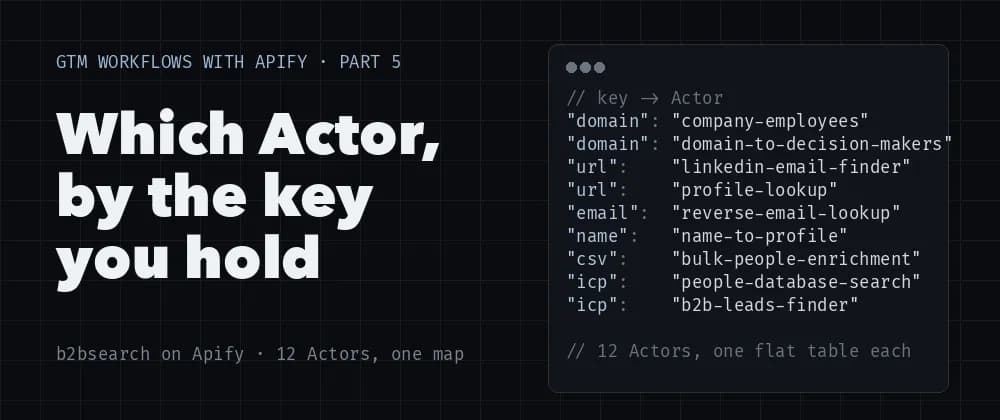
اگر امروز برای غنیسازی دادههای B2B هزینه میکنید، احتمالاً بخش زیادی از بودجه خود را صرف ردیفهای «بدون نتیجه» میکنید. مشکل اینجاست که اکثر کاربران با غنیسازی دادهها مانند یک فرآیند یکپارچه و تکبعدی برخورد میکنند، در حالی که در واقعیت، هر داده ورودی نیاز به ابزار متفاوتی دارد تا به نتیجه برسد.
Apify با معرفی مجموعهای از عاملهای b2bsearch، تمرکز را از «چه دادهای میخواهید» به «چه دادهای در دست دارید» تغییر داده است. در واقع، کارایی یک عملیات استخراج داده به «کلید» ورودی شما بستگی دارد؛ خواه این کلید یک دامنه باشد، یک لینک لینکدین، یک ایمیل یا صرفاً یک نام. استفاده از عامل اشتباه برای یک کلید خاص منجر به اتلاف اعتبارها (Credits) و ایجاد ردیفهای «صفر-نتیجه» میشود که هیچ ارزشی برای کسبوکار ندارند.
همانطور که در تحلیلهای قبلی ما دربارهی اتوماسیون دادهها اشاره کردیم، کلید موفقیت در مقیاس بالا، حذف مراحل زائد است. این رویکرد ماژولار اجازه میدهد یک «زنجیره» ایجاد کنید که در آن خروجی یک عامل تبدیل به ورودی عامل بعدی میشود. برای مثال، یک اجرای People Search ابتدا لینک پروفایل را فراهم میکند و سپس این لینک به LinkedIn Email Finder تغذیه میشود. این استراتژی از اشتباه رایج پرداخت هزینه برای غنیسازی کامل لیستی که هنوز از نظر قابلیت دسترسی فیلتر نشده است، جلوگیری میکند.
منطق نقشهبرداری دادهها
برای پیمایش در این ابزارها، باید عامل را بر اساس کلیدی که در حال حاضر در اختیار دارید انتخاب کنید، نه بر اساس نتیجه نهایی مورد نظر. منطق این سیستم از مسیرهای زیر پیروی میکند:
- داشتن دامنه شرکت: استخراج لیست کارکنان، تصمیمگیرندگان یا کارت شناسایی شرکت.
- داشتن لینک پروفایل: دریافت ایمیل، شماره تلفن یا سوابق شغلی کامل.
- داشتن ایمیل یا نام: یافتن لینک پروفایل لینکدین.
- داشتن تنها ICP (پروفایل مشتری ایدهآل): تولید ردیفهایی که تمام کلیدهای بالا را در خود دارند.
دو قانون برای تمام ۱۲ عامل این مجموعه حاکم است: اول، هر عامل یک لیست ساده را به عنوان ورودی میگیرد و یک جدول تخت (Flat Table) تحویل میدهد تا خروجی یکی بهطور یکپارچه در ورودی دیگری قرار گیرد. دوم، هر عامل بر اساس ردیفهایی که با موفقیت حل (Resolve) شوند، محاسبه میشود. اگر یک ورودی حل نشود، ردیفی با وضعیت _status برمیگرداند که دلیل عدم موفقیت را توضیح میدهد؛ این ردیفها به عنوان رویدادهای هزینهبر محاسبه نمیشوند.
غنیسازی بر پایه دامنه
وقتی دامنهی یک شرکت را در اختیار دارید، سه عامل اصلی عملیات استخراج را مدیریت میکنند:
Company Employees: استخراج کامل لیست کارکنان. در یک تست مورخ ۱۴ اکتبر ۲۰۲۶، این عامل دامنههایی مثل
linear.appوposthog.comوn8n.ioرا با تنظیمات نقشهای["cxo", "vp", "director"]و حداکثر ردیف (maxRows) ۶۰ بررسی کرد. نتیجه این بود که در ۶ ثانیه، ۱۵ ردیف بازگردانده شد (۸ مورد از Linear، ۴ مورد از PostHog و ۳ مورد از n8n) که شامل ۸ معاون (VP)، ۶ مدیر سطح C و ۱ مدیر (Director) بود.- دادههای استخراجی: عنوان شغلی، دستهبندی ارشدیت، سال شروع به کار (
positionStartYear)، کشور، شهر، تعداد ارتباطات (connectionsCount)، پرچمهای مربوط به داشتن ایمیل کاری (hasWorkEmail) و شخصی (hasPersonalEmail)، پرچمlowSignalو تازگی دادهها (_freshness) که در این تست ۱۴ مورد از ۱۵ ردیف با وضعیتupdated_1yبودند. - سفارشیسازی: میتوانید بخش نقشها را خالی بگذارید تا کل لیست کارکنان استخراج شود، یا با استفاده از
titleContainsوtitleExcludesنتایج را محدود کنید. همچنین میتوانیدprofileDetailرا از حالت ردیف لیست به پروفایل کامل یا مخاطبین در همان اجرا تغییر دهید. - تلهی سیگنال ضعیف: پرچمی به نام
lowSignalبرای پروفایلهایی که کمتر از ۱۰ ارتباط دارند و تاریخ شروع به کار در موقعیت شغلیشان ثبت نشده است، وجود دارد. این الگو اغلب در پروفایلهای «مدیرعامل در برندهای مشهور» دیده میشود. برای لیستهای مدیران ارشد، حتماًexcludeLowSignal: trueرا فعال کنید، اما برای کارکنان ردهپایین که ممکن است شبکههای پنهانی داشته باشند، آن را غیرفعال بگذارید. - مورد استفاده: نقشهبرداری از یک حساب قبل از شروع توالی پیامها یا بررسی «موج استخدام» از طریق گروهبندی لیست بر اساس
positionStartYearبرای شناسایی رشد و بودجه شرکت.
- دادههای استخراجی: عنوان شغلی، دستهبندی ارشدیت، سال شروع به کار (
Decision Maker Finder by Domain: هدفگیری مستقیم رأس سازمان. در ۹ اکتبر ۲۰۲۶، اجرای این عامل روی ۱۰۰ دامنه با نقشهای
["cxo", "founder", "vp"]و حداکثر ۳ نفر به ازای هر شرکت (maxPerCompany: 3)، چهار دقیقه زمان برد و ۲۹۳ تصمیمگیرنده را در ۹۹ شرکت شناسایی کرد (۲۱۵ مدیر سطح C، ۶۶ مؤسس و ۱۲ معاون).- رتبهبندی: ردیفها ابتدا بر اساس مؤسس و مدیرعامل، سپس مدیران سطح C، معاونان و در نهایت مدیران رتبهبندی میشوند. هر شخص تنها یک بار ظاهر میشود.
- دادههای استخراجی: رتبه (
_rank)، دامنه، تعداد کارکنان شرکت (companyEmployeeCount)، نام، عنوان شغلی، ارشدیت، لینک لینکدین، سال شروع به کار و دو پرچم ایمیل. - مورد استفاده: شناسایی «کمیته خرید» یک سطح بالاتر از کاربر نهایی؛ در حالی که لیستهای دیگر نشان میدهند چه کسی استخدام شده، این عامل نشان میدهد چه کسی استخدام آن نیروی جدید را تأیید کرده است.
Company by Domain: به عنوان یک پیشبررسی حیاتی عمل میکند. در ۹ اکتبر ۲۰۲۶، سه حساب در یک نقشه مسیر گرم (warm-path map) هیچ فارغالتحصیل یا کارمند سابق را نشان نمیدادند. عبور دادن آنها از این عامل فاش کرد که
sumup.comبه جای گروه اصلی، به یک زیرمجموعه کوچک ۱۲۵ نفره متصل شده است، در حالی که دو مورد دیگر به رکوردهایی با ۴,۴۸۸ و ۳,۶۴۴ نفر متصل شدند که ثابت کرد آن صفرها واقعی بودند.- دادههای استخراجی: تعداد کارکنان، صنعت، دفتر مرکزی و لینک پروفایل رکورد شناسایی شده.
- تله: اگر یک دامنه به رکورد اشتباهی متصل شود، تمام ردیفهای پاییندستی هدر میروند. این تنها عاملی است که اجازه میدهد قبل از پرداخت هزینه برای ردیفهای فردی، صحت شناسایی دامنه را بررسی کنید.
استخراج مخاطب و پروفایل
اگر لینک پروفایل لینکدین را در اختیار دارید، جریان کاری به سمت استخراج مخاطبین و عمق سوابق شغلی میرود:
- LinkedIn Email Finder: ورودی آن
profileUrlsو به صورت اختیاریincludePersonalEmailsاست. هر ردیف یافت شده با برچسبwork_current(دامنه کارفرمای فعلی) یاwork_other(کارفرمای قبلی) مشخص میشود.- دادههای عملکرد (۹-۱۰ اکتبر ۲۰۲۶):
- رهبران فروش جدید: ۱۰۰ لینک $
- دادههای عملکرد (۹-۱۰ اکتبر ۲۰۲۶):
ightarrow$ ۱۰۰ مورد یافت شد (۲۹ مورد work_current و ۷۱ مورد work_other).
* مشتریان سابق: ۱۲۵ لینک $
ightarrow$ ۱۰۰ مورد یافت شد (۴۴ مورد work_current و ۵۶ مورد work_other؛ ۲۱ مورد بدون آدرس و ۴ مورد پروفایل حذف شده).
* مؤسسان سابق شرکتهای بزرگ تکنولوژی: ۶۰ لینک $
ightarrow$ ۵۷ مورد یافت شد (۳ مورد work_current و ۵۴ مورد work_other).
* درس آموخته شده: مؤسسانی که اخیراً شرکتهای بزرگی را ترک کردهاند، اغلب هنوز آدرس کارفرمای قبلی را در رکورد خود دارند. برای مؤسسان، کلید اصلی یافتن صندوق پستی شخصی در سطح مخاطبین People Search با تنظیم mustHave: ["personalEmail"] است.
LinkedIn Profile Scraper: استخراج کامل سوابق شغلی. ورودی آن
profileUrlsاست و با فعال کردنcontacts: trueآدرسها/تلفنها و باcompact: trueبرای ایجنتها استخراج میشود.- دادههای استخراجی: تجربه کاری (تقسیم شده به موقعیتهای شغلی و داوطلبانه با تاریخ)، تحصیلات، مهارتها، گواهینامهها، تیتر (Headline)، بخش درباره من (About)، ارتباطات، دنبالکنندگان و
_freshness. - مکانیسم: این ابزار به جای یک نشست زنده (Live Session)، یک رکورد پایگاه داده را میخواند؛ بنابراین هیچ کوکی مصرف نمیشود و هیچ خطری برای مسدود شدن حساب (Ban) وجود ندارد. رکوردها به اندازه آخرین بهروزرسانی شخص تازه هستند (که به صورت
updated_1yیا قدیمیتر گزارش میشود). - مورد استفاده: ایجاد یک لیست کوتاه. ردیفهای پایه را برای همه استخراج کنید، اما رکورد کامل را فقط برای تعداد محدودی از افراد منتخب.
- دادههای استخراجی: تجربه کاری (تقسیم شده به موقعیتهای شغلی و داوطلبانه با تاریخ)، تحصیلات، مهارتها، گواهینامهها، تیتر (Headline)، بخش درباره من (About)، ارتباطات، دنبالکنندگان و
LinkedIn Phone Number Finder: به طور خاص رکوردهای تلفن را هدف قرار میدهد. در ۹ اکتبر ۲۰۲۶، اجرای این عامل روی ۱۰۰ مؤسس و مدیر اجرایی آمریکایی ۲۳ ثانیه زمان برد و ۳۳ شماره تلفن یافت (۲۴ نفر با یک شماره، ۷ نفر با دو تا چهار شماره و ۱ نفر با هفت شماره). ۶۳ نفر
no_phoneبودند، ۳ موردprofile_removedو ۱ موردnot_foundبود.- پوشش: پوشش دادهها به ارشدیت و جغرافیا بستگی دارد. برای مقایسه، جستوجوی ۵۰ نیروی عملیاتی (Individual Contributors) از طریق ایمیل تنها ۳ شماره تلفن بازگرداند. برای مدیران آمریکایی، نرخ موفقیت ۱ به ۳ را در نظر بگیرید.
تبدیل ایمیل و نام به پروفایل
برای کاربرانی که با ایمیل یا نام شروع میکنند، هدف معمولاً یافتن لینک لینکدین برای باز کردن قفل غنیسازیهای بیشتر است:
Email to LinkedIn Profile Finder: تبدیل آدرسهای کاری به لینکهای پروفایل. در تستی روی ۱۰ آدرس کاری، ۹ مورد یافت شد و ۱ مورد
ambiguous(مبهم) بود.- ابهام: اگر یک آدرس برای چندین پروفایل (مثلاً ۶ پروفایل) ثبت شده باشد، عامل به جای حدس زدن، تعداد کاندیداها را در
_matchCandidatesو_errorگزارش میدهد. - دادههای استخراجی:
linkedinUrl، نام، عنوان شغلی، تیتر، شرکت، لینک لینکدین شرکت، مکان و نحوه تطبیق (matchedViaمانندas_given).
- ابهام: اگر یک آدرس برای چندین پروفایل (مثلاً ۶ پروفایل) ثبت شده باشد، عامل به جای حدس زدن، تعداد کاندیداها را در
Reverse Email Lookup: ارائه مستقیم رکورد کامل شخص از طریق ایمیل. همان ۱۰ آدرس در ۳ ثانیه به ۱۰ رکورد کامل تبدیل شدند، شامل شرکت فعلی، عنوان، مکان و بلوک کامل تجربه/تحصیلات. فعال کردن
contacts: trueآدرسها و تلفنهای دیگر ثبت شده را اضافه میکند.Profile Finder by Name & Company: استفاده از فرمت «نام کامل، دامنه» (مثلاً "Jane Doe, acme.com"). تستی روی ۱۰ نام، ۱۰ مورد را در ۸ ثانیه شناسایی کرد.
- تله: فیلدهای
companyNameوjobTitleاز اولین موقعیت شغلی فعلی در رکورد گرفته میشوند. در ۳ مورد از ۱۰ مورد، این موقعیت یک عضویت در انجمن یا پروژه جانبی بود، در حالی که تیتر (Headline) همچنان نام کارفرمای هدف را داشت. همیشه تیتر و بخشexperience.workرا بخوانید.
- تله: فیلدهای
تولید لید از طریق ICP
وقتی هیچ کلیدی جز پروفایل مشتری ایدهآل (ICP) ندارید، دو عامل «اسب کاری» لیست اولیه را تولید میکنند:
People Search: موتور اصلی برای کشف. فیلترها شامل کشورها، ارشدیت، کلمات کلیدی عنوان، صنایع کارفرما، حداقل/حداکثر تعداد کارکنان، دامنههای شرکت، دامنههای کارفرمای سابق (با
leftPastEmployerAfterYear)، تاریخ شروع نقش فعلی، افرادی که بین دو شغل هستند (onlyBetweenJobs)، کلمات کلیدی مکان، حداکثر تعداد به ازای هر شرکت، حذف مجموعهدادهها،sampleSeedو سگمنتها است.- حالتها: ابتدا حالت را روی
countیاmarketقرار دهید؛ این حالتها بر اساس ردیف هزینه ندارند و اندازه سگمنت را قبل از متعهد شدن به یک اجرای پولی فاش میکنند. - تله: ۱۰۰ ردیف اول، سرِ مرتبشده نتایج هستند، نه یک نمونه تصادفی. یک پرسوجو برای سه کشور ممکن است در صفحه اول فقط نتایج یک کشور را برگرداند. برای دریافت یک برش تصادفی واقعی از
sampleSeedاستفاده کنید.
- حالتها: ابتدا حالت را روی
B2B Leads Finder: تنها ردیفهایی را تحویل میدهد که دارای آدرس تأیید شدهای باشند که امروز به شخص میرسد. اجرایی برای مدیران فروش مستقر در بریتانیا (
jobTitles: ["head of sales", "vp sales"]، حداقل اندازه شرکت ۵۰ و حداکثر ۵۰۰) در ۲۴ ثانیه ۲۵ لید تحویل داد.- نتایج: ۱۶ مورد آدرس کاری، ۹ مورد آدرس شخصی و ۷ مورد تلفن داشتند. ۱۸ نفر دیگر که واجد شرایط بودند اما آدرس قابل دسترسی نداشتند، نادیده گرفته شدند.
- تنظیمات:
emailType: "work"نتایج را به آدرسهای کارفرمای فعلی محدود میکند.titleMatchبه طور پیشفرض رویsubstringاست (که تیتر را میخواند)؛ برای عناوین کوتاهتر و دقیقتر ازtitleMatch: "word"استفاده کنید.
یکپارچهسازی و اتوماسیون
این عاملها برای استفاده برنامهنویسی از طریق Claude Code، n8n یا curl طراحی شدهاند.
- Claude Code & MCP: ایپای (Apify) یک سرور MCP میزبانی میکند. شما میتوانید عاملهای خاصی را به یک ایجنت پین کنید تا آن را از فروشگاه عمومی دور نگه دارید و محدوده استدلال آن را محدود کنید:
claude mcp add --transport http apify "https://mcp.apify.com?tools=b2bsearch/company-employees,b2bsearch/linkedin-email-finder,b2bsearch/people-database-search" - n8n: با استفاده از نود رسمی Apify ("Run an Actor and get dataset")، میتوانید یک فید «موج استخدام» در چهار نود بسازید: نود Schedule $
ightarrow$ Company Employees $
ightarrow$ نود Filter (بر اساسpositionStartYear) $
ightarrow$ نود Slack. - curl: یک فراخوانی Sync ساده میتواند یک عامل را اجرا کرده و مجموعه داده را برگرداند:
curl -X POST "https://api.apify.com/v2/acts/b2bsearch~email-to-linkedin/run-sync-get-dataset-items?token=$APIFY_TOKEN" -H "Content-Type: application/json" -d '{"emails": ["[email protected]"]}'
حفاظهای کیفیت داده
برای اعتماد به خروجی، سیستم پرچمهای وضعیت خاصی را ارائه میدهد:
_status: نشان میدهد که آیا یک ردیفfound(یافت شد)،no_email(بدون ایمیل)،no_phone(بدون تلفن)،ambiguous(مبهم)،skipped_no_email(رد شده به دلیل نبود ایمیل)،profile_removed(پروفایل حذف شده) یاnot_found(نیافت) بوده است. موارد یافت نشده همچنان ردیف هستند و به شما میگویند که آیا کلید دیگری را امتحان کنید یا متوقف شوید._freshness: رکوردها را به عنوانupdated_1yیا قدیمیتر علامتگذاری میکند. در یک اجرای اخیر لیدها، ۲۳ مورد از ۲۵ مورد قدیمیتر بودند؛ این برای یک توالی کلی قابل قبول است اما برای ادعای «شروع در این فصل» مناسب نیست.lowSignal: پرچمی برای پروفایلهای فاقد تاریخ شروع و ارتباطات (زیر ده مورد). اینها را در لیستهای مدیران ارشد حذف کنید.- شناسایی دامنه: یک مقدار صفر در یک دامنه، یک سؤال است نه یک پاسخ، تا زمانی که Company by Domain تأیید کند که دامنه به کدام رکورد متصل شده است.
این معماری، آیندهجویی B2B را از یک بازی حدسزدنی به یک خط لوله قطعی (Deterministic Pipeline) تبدیل میکند. با حل قویترین کلید در ابتدا، کاربران میتوانند لیستهای خود را از نظر قدیمی بودن بازرسی کنند — مانند شناسایی افرادی که شرکت خود را تغییر دادهاند — قبل از شروع یک توالی پیام. در تستی روی ۳۰۰ ردیف از یک لیست ۱۵ هفتهای از طریق Bulk People Enrichment، مشخص شد ۱۴۳ نفر هنوز در شرکت ذکر شده هستند، ۱۳۷ نفر جابجا شدهاند و ۱۹ نفر هیچ موقعیت شغلی فعلی ندارند.
گام بعدی شما
- اگر لیستهای قدیمی دارید، ابتدا آنها را از Bulk People Enrichment رد کنید تا افرادی که جابجا شدهاند شناسایی شوند.
- برای کاهش هزینهها، زنجیره استخراج را از «دامنه $
ightarrow$ پروفایل $
ightarrow$ ایمیل» طراحی کنید. - از فیلتر
excludeLowSignalبرای پاکسازی لیستهای مدیران ارشد استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو