
تصور کنید یک برنامهنویس ابزاری را به عامل هوش مصنوعی خود متصل میکند که برای استخراج دادهها به ۳۵ ثانیه زمان نیاز دارد، اما عامل در ثانیه دهم تصور میکند سیستم کرش کرده است. این شکاف میان «انتظار مدل» و «واقعیت اجرا»، بزرگترین مانع فعلی در مسیر تبدیل چتباتها به عاملهای عملیاتی است.
به گزارش Apify، در ۲ اکتبر ۲۰۲۶، پژوهشگران با ردیابی ترافیک خام JSON-RPC در سرور پروتکل زمینهٔ مدل (Model Context Protocol یا MCP)، دقیقاً بررسی کردند که وقتی یک ابزار دوردست بیش از چند ثانیه اجرا میشود، چه اتفاقی برای عامل میافتد. این بررسی در ادامه قابلیتهای سرور MCP شرکت Apify برای تبدیل وبسایتها به دادههای ساختاریافته صورت گرفته است تا محدودیتهای عملیاتی آن در محیطهای واقعی شناسایی شود. در حالی که اکثر دموهای MCP ابزارهایی را نشان میدهند که آنی پاسخ میدهند، در دنیای واقعی کارهایی مثل خزش وب (Crawling) یا تولید گزارش ممکن است دقایق طول بکشد. این عدم تطابق منجر به Time-out شدن یا توهم عامل دربارهٔ شکست عملیات میشود، زیرا مدلها تصور میکنند اگر پاسخی سریع دریافت نکردند، فرآیند با خطا مواجه شده است.
زمینه و آمادهسازی
همانطور که در تحلیلهای قبلی ما دربارهی مدیریت وضعیت در سیستمهای عاملمحور اشاره کردیم، مدلها بدون یک لایه مدیریت خارجی، حافظهای از زمان جاری ندارند. برای تست این موضوع، تیم پژوهشی از سرور میزبانیشدهٔ Apify (آدرس mcp.apify.com، نسخه ۰.۱۷.۱) استفاده کرد. تسک مشخص برای این آزمایش، استفاده از یک اسکرپر YellowPages برای خواندن یک صفحه از نتایج بود؛ عملیاتی که بهطور معمول حدود ۳۵ ثانیه زمان میبرد تا به پایان برسد.
در مرحله اکتشاف (Discovery)، فراخوانی tools/list نشان داد که برای هر اسکرپر مجاز، یک ابزار اختصاصی تعریف شده است. همچنین، چهار ابزار کمکی (Helper Tools) شناسایی شدند که بهطور خاص برای مدیریت کارهای طولانیمدت طراحی شدهاند. وجود این ابزارها سیگنالی به عامل است که سرور انتظار دارد مدل برای دریافت نتایج دوباره بازگردد، به جای اینکه تمام دادهها را در یک پاسخ واحد و انفجاری دریافت کند.
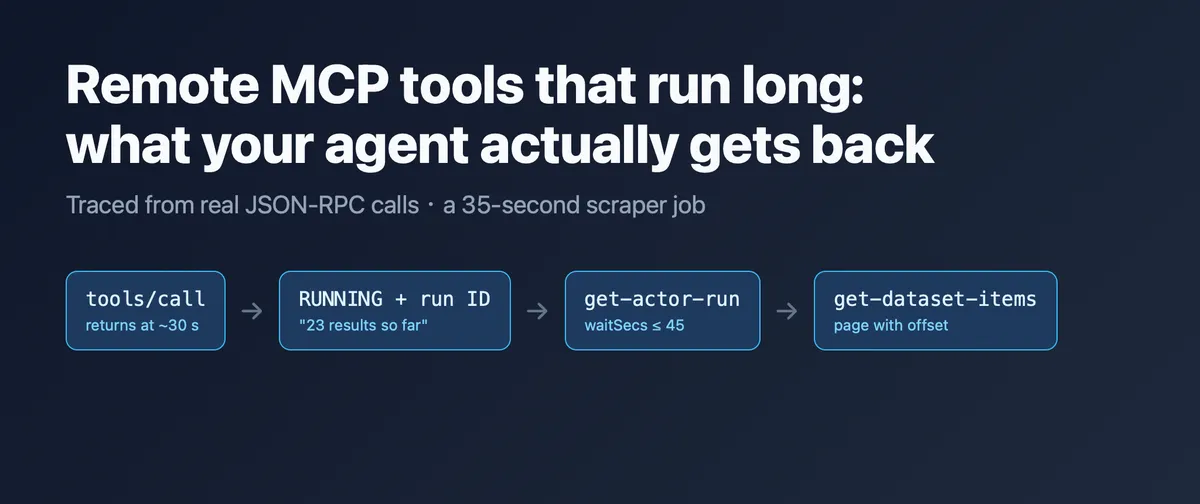
بر اساس گزارش منتشر شده در dev.to، سرور Apify این موضوع را از طریق ارسال یک «پاسخ زودهنگام» مدیریت میکند. برای مثال، وقتی عاملی یک اسکرپر را برای جستجوی «لولهکشها» در شهر «آستین، تگزاس» با تنظیم maxPages: 1 فعال میکند، سرور پس از حدود ۳۰ ثانیه — در حالی که عملیات هنوز در پسزمینه فعال است — پاسخی را برمیگرداند.
این پاسخ شامل دو بخش است: بخش اول یک JSON ساختاریافته است که وضعیت را status: "RUNNING" و یک شناسه اجرا (runId) نشان میدهد. بخش دوم متنی ساده است که مستقیماً برای مدل نوشته شده: «در حال اجرا برای ۳۰ ثانیه. در جریان است. تاکنون ۲۳ نتیجه یافت شده. برای بررسی نهایی از ابزار get-actor-run با runId=... و waitSecs=30 استفاده کن». این طراحی هوشمندانه اجازه میدهد مدلهایی که فقط JSON میفهمند یا فقط متن میخوانند، هر دو متوجه نیاز به نظارت یا همان پولینگ (Polling) شوند.
مکانیسم نظارت (Polling)
برای مدیریت این فرآیندهای طولانی، سرور چهار ابزار کمکی مشخص را در اختیار عامل قرار میدهد:
get-actor-run: وضعیت یک اجرای خاص را بررسی میکند و میتواند برای دریافت نتیجه منتظر بماند.get-dataset-items: نتایج را بهصورت صفحهبندی شده میخواند تا از پر شدن پنجرهٔ زمینه (Context Window) جلوگیری کند — شبیه به ورق زدن یک کتاب به جای سعی در خواندن تمام صفحات بهطور همزمان.get-key-value-store-record: یک فایل یا رکورد ذخیرهشده در حافظه را میخواند.abort-actor-run: در صورتی که کاربر سؤال خود را تغییر دهد، اجرای فعلی را متوقف میکند تا از اتلاف هزینه و منابع جلوگیری شود.
نقاط شکست فنی
تحلیل ترافیک، سه نقطه شکست بحرانی را برای توسعهدهندگان آشکار کرد. نخست، سقف سختگیرانه در نظارت وجود دارد. اگر توسعهدهنده یا مدل سعی کند مقدار waitSecs را روی ۶۰ یا ۱۲۰ ثانیه تنظیم کند، سرور خطای پروتکل ۳۲۶۰۲ را صادر میکند: «آرگومانهای نامعتبر برای ابزار get-actor-run. خطای اعتبارسنجی: waitSecs باید <= ۴۵ باشد».
از آنجایی که این یک خطای سطح پروتکل است و نه یک نتیجهٔ ابزار که دارای پرچم isError باشد، بسیاری از کلاینتها این شکست در اعتبارسنجی را کاملاً نادیده میگیرند. در مقابل، وقتی waitSecs روی ۳۰ تنظیم میشود، فراخوانی با وضعیت "SUCCEEDED" به همراه زمان اجرا و تعداد آیتمهای دیتاست بازمیگردد. همچنین یک بلوک _meta شامل دادههای مصرف پلتفرم ارسال میشود که کلاینتها میتوانند پیش از شروع کارهای بزرگتر، آن را به کاربر نمایش دهند.
دوم، «تلهٔ موفقیت» است. در یک تست با اسکرپر گوگل مپس که ۱۵۷ ثانیه طول کشید، ابزار وضعیت SUCCEEDED را برگرداند، اما ابزار get-dataset-items تعداد آیتمها را صفر (itemCount: 0) گزارش کرد، زیرا یک شکست در وابستگیهای بالادستی (Upstream) رخ داده بود. عاملهایی که موفقیت را بهصورت صفر و یکی (Binary) میبینند، بهاشتباه به کاربر گزارش میدهند که عملیات با موفقیت انجام شد، در حالی که در واقعیت هیچ دادهای استخراج نشده است. این نوع خطاهای پنهان دقیقاً همان جایی است که نیاز به «اعتماد انسانی» در اتوماسیون AI احساس میشود تا از تصمیمات غلط عاملها در محیطهای تجاری جلوگیری شود.
سوم، مدیریت دادههای حجیم است. ابزار get-dataset-items برای جلوگیری از سرریز شدن حافظه مدل، از پارامترهای شناسه دیتاست، آفست (Offset) و لیمیت (Limit) استفاده میکند. این ابزار آیتمها را به همراه totalItemCount و آفست فعلی برمیگرداند. این یعنی توسعهدهندگان دیگر نمیتوانند با ابزارهای AI مثل توابع ساده برخورد کنند؛ آنها باید «ماشینهای وضعیت» (State Machines) بسازند که بتوانند شناسههای اجرا را ذخیره کرده و حلقههای نظارت را با ضربالاجلهای زمانی کلی مدیریت کنند و محتوای واقعی یک پاسخ «موفق» را اعتبارسنجی کنند.
برای یک متخصص، معیار «عامل قابلاعتماد» تغییر کرده است. دیگر بحث فقط توانایی استدلال مدل نیست، بلکه توانایی کلاینت در مدیریت وضعیتهای ناهمگام (Asynchronous) و خطاهای سطح پروتکل است.
توسعهدهندگان باید اکنون کلاینتهای MCP خود را بازبینی کنند تا مطمئن شوند خطاهای ۳۲۶۰۲ را مدیریت میکنند و برای حلقههای نظارت، ضربالاجلهای زمانی (Total Deadlines) تعریف میکنند. مشاهده نحوه مدیریت اعلانهای پیشرفت در کلاینتهای تجاری، کلید بعدی برای مقیاسبندی جریانهای کاری عاملمحور خواهد بود.
گام بعدی شما
- کلاینتهای MCP خود را برای شناسایی و مدیریت خطای ۳۲۶۰۲ بازبینی کنید.
- برای حلقههای نظارت (Polling Loops)، یک ضربالاجل زمانی کلی (Total Deadline) تعریف کنید تا عامل در حلقههای بینهایت گیر نکند.
- منطق اعتبارسنجی پاسخها را تغییر دهید تا موفقیت فقط بر اساس وضعیت
SUCCEEDEDنباشد و محتوای بازگشتی (مانند تعداد آیتمها) را نیز چک کند.
اما مدیریت این وضعیتها در مقیاس هزاران کاربر، چالشهای سختافزاری جدیدی ایجاد میکند — به تحلیل ما دربارهی بهینهسازی هزینه استنتاج در محیطهای توزیعشده مراجعه کنید.



گفتگو