اگر مدیر عملیات هستید و تیمی از برنامهنویسان دارید، احتمالاً متوجه شدهاید که ارزانترین راه دسترسی به مدلها، همیشه بهینه نیست. در مقیاس سازمانی، پایداری سیستم و امنیت دادهها بر قیمت هر توکن ارجحیت پیدا میکند.
برای سازمانهایی که Claude Code را مستقر میکنند، تفاوت میان طرح مستقیم Anthropic و AWS Bedrock در مرزهای امنیتی و ثبات عملیاتی است. این تغییر رویکرد زمانی رخ میدهد که شرکتها از مرحلهی نمونهسازی به تولید تجاری میروند.
همانطور که در تحلیل قبلی ما دربارهی تلاشها برای جذب Anthropic به اتحادیهی اروپا اشاره کردیم، نیاز به بومیسازی دادهها و رعایت قوانین حریم خصوصی به محرک اصلی استفاده از مدلهای ابری تبدیل شده است. این نگرانیها بهویژه پس از آنکه گزارشهایی مبنی بر قربانی کردن حریم خصوصی شرکتها برای دستیابی به دقت بالاتر در مدلهای Anthropic منتشر شد، برای سازمانها حیاتیتر شده است. برای اکثر کسبوکارها، «مرز ابری» یک الزام غیرقابلمذاکره برای مدیریت دادههای مشتریان تحت قانون GDPR است. با استفاده از مدل Opus در Bedrock، هیچ دادهای از مرز ابری خارج نمیشود و اطلاعات کاربران به سرویسهای شخص ثالث ارسال نمیگردد.
به گزارش وبسایت dev.to در ۲۹ ژوئن ۲۰۲۶، AWS Bedrock مزیتی حیاتی در زمینه پایداری ارائه میدهد. در حالی که صفحهی وضعیت عمومی API مدل کلود در زمان حادثهی Opus 4.8 افت عملکرد داشت، سیستم استنتاج (Inference) — که در واقع لحظهی تولید جواب توسط مدل است و شبیه به خودِ آشپزی (و نه دورهی آموزش آشپز) است — در Bedrock بهصورت خودکار درخواستها را به مناطق دیگر AWS منتقل میکند. این سازوکار باعث میشود برنامههای حساس به تأخیر، حتی در صورت بروز مشکل در یک منطقه خاص، فعال بمانند. دادهها نشان میدهند که در ۹۰ روز گذشته، درصد پایداری claude.ai برابر با ۹۸.۹۶٪ و کنسول کلود ۹۹.۴۵٪ بوده است، اما زیرساخت Bedrock برای گردشکارهای عملیاتی حساس، تابآوری بیشتری دارد.
مکانیسمهای کنترل
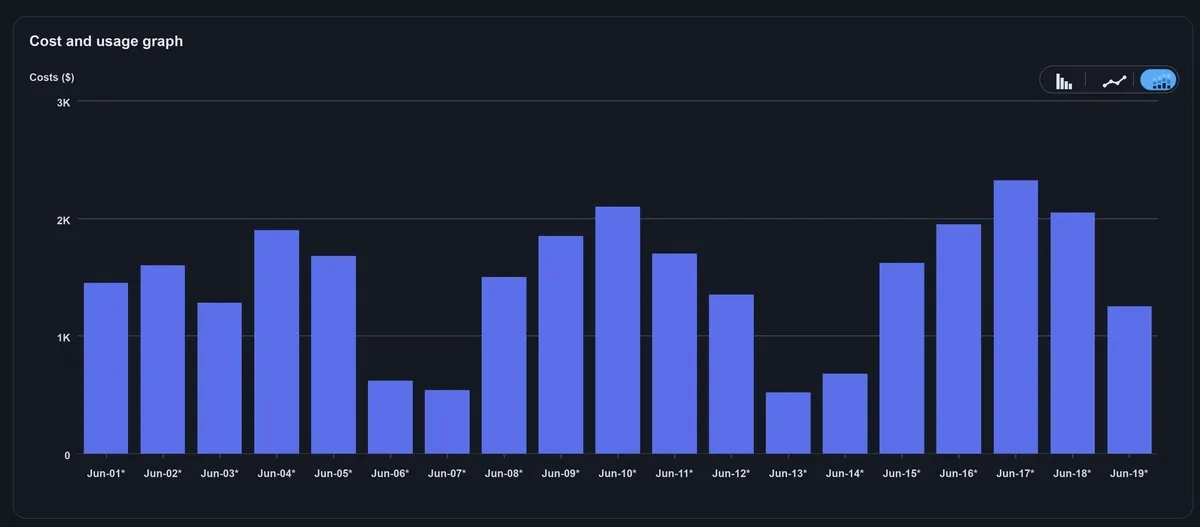
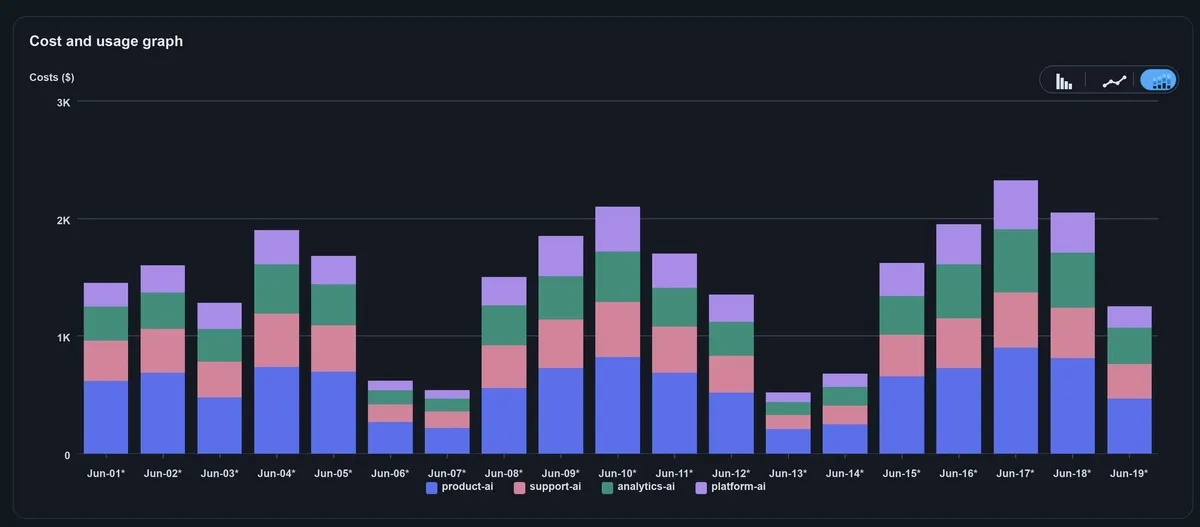
برای مدیریت هزینهها و مجوزها، Bedrock از «پروفایلهای استنتاج کاربرقی» استفاده میکند. این پروفایلها در واقع اشارهگرهایی به مدلهایی مثل Claude Opus 4.8 هستند که هر درخواست را با برچسبهای (Tags) پیشفرض علامتگذاری میکنند. به این ترتیب، یک شرکت میتواند دقیقاً ردیابی کند که کدام تیم داخلی یا سرویس، دلیل افزایش صورتحساب هوش مصنوعی است.
وقتی یک کاربر از طریق SDK، CLI یا HTTP درخواست ارسال میکند، باید یکی از این دو مورد را مشخص کند:
- پروفایل استنتاج تعریفشده توسط AWS (مانند
global.anthropic.claude-opus-4-8) - پروفایل استنتاج کاربرقی سفارشی که توسط کاربر ساخته شده است.
پروفایلهای سفارشی، استفاده از مدل را «بستهبندی» میکنند. یک نمونه از منابع CloudFormation شامل نام پروفایل (مثلاً internal-service-a-opus)، منبع مدل (Opus 4.8) و برچسبهای خاصی مانند owner-team: team-x و environment: production است.
مدیریت دقیق دسترسیها
کلید موفقیت این ساختار، مدیریت دقیق مجوزها است. برای اینکه کاربران نتوانند سیستم ردیابی را دور بزنند، مدیران باید دسترسیهای bedrock:InvokeModel و bedrock:InvokeModelWithResponseStream را محدود کنند.
مجوزها باید بهگونهای تعریف شوند که کاربر اجازه فراخوانی پروفایل استنتاج خاص را داشته باشد، اما تنها در صورتی بتواند مدلهای بنیادی (Foundation Models) — مدلهای مادر و کلی که پایه و اساس مدلهای تخصصیتر هستند — را فراخوانی کند که شرط bedrock:InferenceProfileArn با پروفایل کاربرقی مطابقت داشته باشد. همچنین دسترسیهایی برای لیست کردن و دریافت متادیتای مدلها ضروری است تا کاربر بتواند توضیحات مدل را مشاهده کند.
این سازوکار تضمین میکند که هر فراخوانی مدل حتماً از طریق یک پروفایل استنتاج صورت گیرد و برچسبها بهدرستی به گزارش هزینهها منتقل شوند. این روش مانع از بروز «هوش مصنوعی سایه» (Shadow AI) میشود؛ وضعیتی که در آن توسعهدهندگان بدون اطلاع سازمان از مدلها استفاده میکنند. برای عیبیابی، توسعهدهندگان میتوانند با دستور converse در AWS CLI، مجوزهای خود را در منطقه us-east-1 آزمایش کنند.
تفکیک مصرف انسانی و سرویسهای خودکار
در مدیریت هزینهها، تفاوت چشمگیری میان کاربران انسانی و سرویسهای خودکار وجود دارد:
- برای سرویسها: پروفایلهای استنتاج کاربرقی، استاندارد طلایی شفافیت هستند و باید برای تمام حجمهای کاری استفاده شوند تا هزینهها برای مدیر عملیات شفاف باشد.
- برای انسانها: پروفایلهای سفارشی بهدلیل چرخهی سریع انتشار مدلهایی مثل Claude Sonnet و Haiku، بسیار دشوار و زمانبر هستند.
مدیریت پروفایلهای انسانی سخت است زیرا مدلها مدام بهروزرسانی میشوند و هر بار نیاز به ساخت پروفایل جدید است. علاوه بر این، تیمهای مختلف برای هر مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — به پروفایلهای متفاوتی نیاز دارند و تنظیم متغیرهای محیطی برای کارکنان غیرفنی دشوار است.
برای ادغام Claude Code با Bedrock، کاربران معمولاً متغیرهای محیطی مثل CLAUDE_CODE_USE_BEDROCK=1 را صادر کرده و مدلهای پیشفرض Opus، Sonnet و Haiku را به ARNهای مربوط به پروفایلها متصل میکنند.
برای حل مشکل ردیابی مصرف انسانی، سازمانها سه مسیر اصلی دارند:
۱. درگاههای LLM: استفاده از ابزارهایی مثل LiteLLM، Portkey یا Bifrost بهعنوان پروکسی. این ابزارها بودجههای مشخصی را بهصورت لحظهای اعمال میکنند، هرچند ویژگیهای امنیتی مثل ادغام OAuth هزینه اضافی دارد.
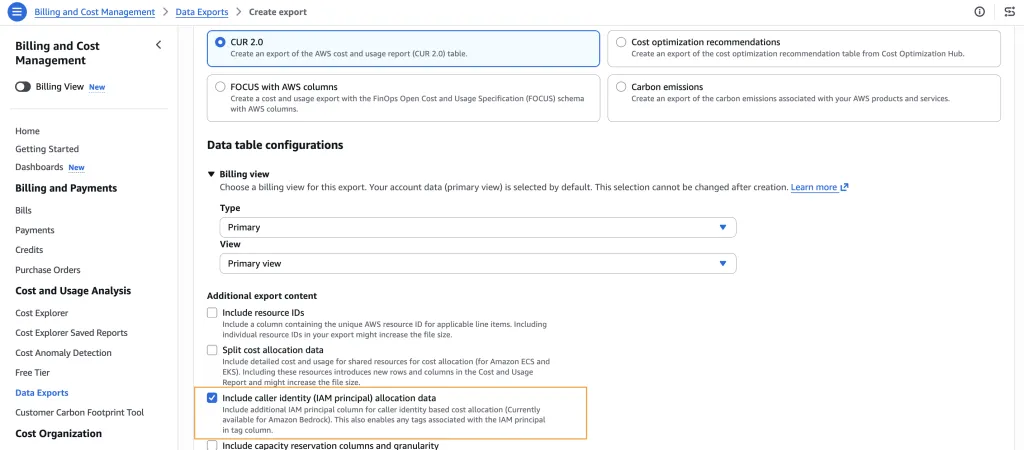
۲. خروجیهای CUR 2.0: استفاده از AWS Cost Explorer با فعالسازی شناسهی فراخواننده. این روش جزئیات هر نشست IAM را ارائه میدهد و اعداد با صورتحساب ابری ۱۰۰٪ مطابقت دارند، اما دادهها با ۲۴ ساعت تأخیر بهروز میشوند.
۳. ثبت وقایع فراخوانی (Invocation Logging): فعالسازی لاگهای Bedrock برای ثبت لحظهای تعداد توکنها (Token) — تکههای کوچکی از متن که شبیه برشهای یک کیک طولانی هستند و مدل آنها را میخورد — و شناسهی کاربران.
قدرت لاگهای فراخوانی
فعالسازی لاگهای فراخوانی فراتر از دادههای هزینه است. یک ورودی لاگ معمولی، برچسب زمانی، شناسه درخواست، عملیات (مثلاً InvokeModelWithResponseStream) و ARN هویت کاربر (مثلاً [email protected]) را ثبت میکند.
مهمتر از آن، این لاگها تمام محتوای درخواست و معیارهای دقیق توکن را فاش میکنند:
inputTokenCount: مجموع توکنهای ارسالی.cacheReadInputTokenCount: توکنهای بازیابیشده از حافظه پنهان (Cache).cacheWriteInputTokenCount: توکنهای نوشتهشده در حافظه پنهان.outputTokenCount: توکنهای تولیدشده توسط مدل.
این دادهها به مدیران اجازه میدهد بفهمند کدام سرورهای MCP محبوبترند و اندازه متنی (Context Size) پیامهای اولیه چقدر است. همچنین مشخص میشود که آیا توسعهدهندگان با ارسال زنجیرههای پیام بسیار طولانی، از گردشکارهای عاملمحور (Agentic) سوءاستفاده میکنند یا خیر. با ضرب کردن این اعداد در قیمت ارائهدهنده، شرکتها به دید مالی لحظهای میرسند و حتی میتوانند هشدارهای هزینه را به Slack ارسال کنند.
این رویکرد معماری، این فرض را که «ارزانتر همیشه بهتر است» تغییر میدهد. برای یک مدیر عملیات، توانایی مشاهده یک ردیف دقیق هزینه برای «سرویس A در استفاده از مدل Opus»، ارزش پرداخت مبلغ بیشتر نسبت به اشتراکهای ماهانه را دارد. اگر تیمی با بیش از ۱۰ توسعهدهنده مدیریت میکنید، بررسی کنید که آیا تنظیمات API فعلی شما اجازه حسابرسی توکن بهازای هر کاربر را میدهد یا خیر. تنظیمات لاگینگ Bedrock خود را بررسی کنید تا متوجه شوید چه دیدگاههای حیاتی را از دست میدهید.
گام بعدی شما
- اگر از AWS Bedrock استفاده میکنید، فوراً فعالسازی Invocation Logging را برای تحلیل نرخ مصرف توکنهای ورودی و خروجی بررسی کنید.
- برای جلوگیری از هزینههای پنهان، دسترسی مستقیم به
InvokeModelرا محدود کرده و کاربران را مجبور به استفاده از Application Inference Profiles کنید. - در صورت نیاز به مدیریت بودجه لحظهای برای کاربران انسانی، پیادهسازی یک LLM Gateway مانند LiteLLM را در نقشه راه خود قرار دهید.
اما داستان مدیریت هزینهها در لایهی سختافزار حتی پیچیدهتر است؛ برای درک تأثیر GPU بر قیمت نهایی استنتاج، تحلیل ما دربارهی هزینههای عملیاتی مدلهای بازمتن را بخوانید.



گفتگو