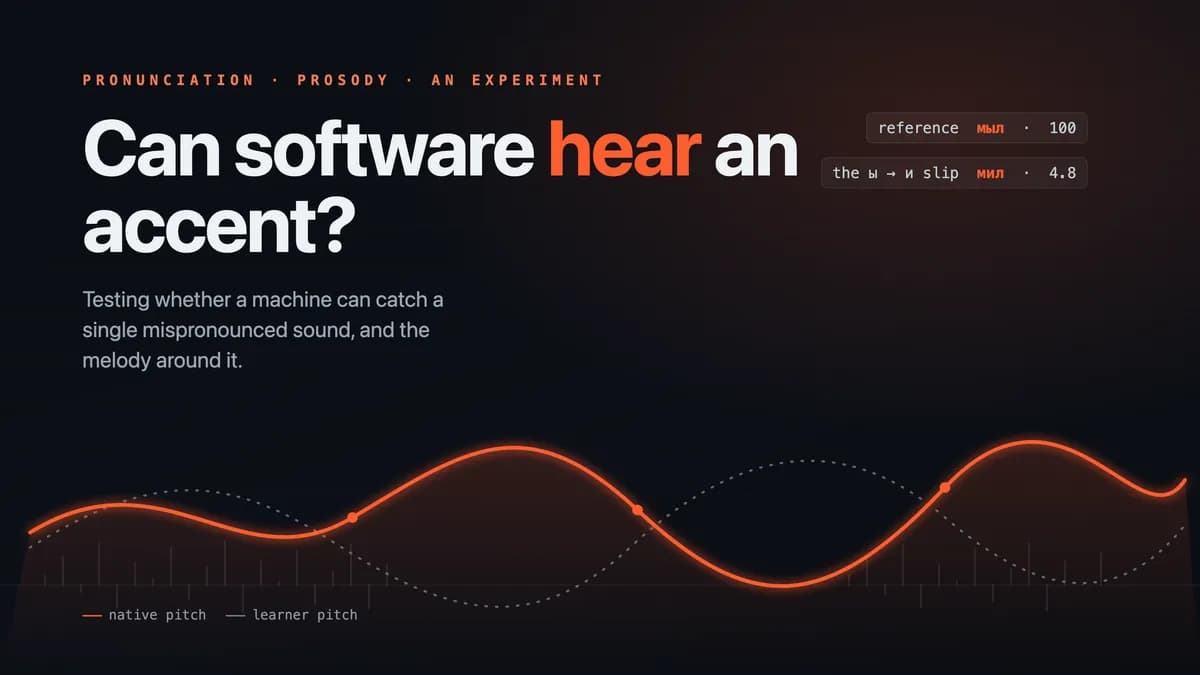
تصور کنید امتیاز تلفظ شما در یک زبان خارجی، تنها بهخاطر یک مصوت اشتباه، از ۱۰۰ به نزدیک صفر سقوط کند. در مجموعهای از آزمایشهای انجامشده در جولای ۲۰۲۶، ابزار ارزیابی تلفظ Azure نشان داد که نرمافزار اکنون میتواند دقیقترین واحد صوتی (Phoneme) اشتباه را شناسایی کند؛ قابلیتی که پیشتر تنها در اختیار گوشهای آموزشدیده انسانی بود و دقت آن اکنون با مهارت یک متخصص زبان برابری میکند.
یادگیری زبان جدید همیشه با یک شکاف کلافهکننده همراه است: مدرس میداند شما «تقریباً» درست گفتید، اما نمیتواند مکانیسم شکست صوتی را دقیقاً توضیح دهد. گوش انسان خطا را فوراً میشنود اما دایره لغات لازم برای توصیف تفاوت دقیق در فرکانس یا زمانبندی را ندارد. به همین دلیل است که زبانآموز کلمه را آرام میگوید، حس میکند که آن را بهطور کامل و درست تلفظ کرده است، اما مدرس فقط لبخندی میزند و میگوید «نزدیک بود»؛ بدون اینکه بتواند بگوید دقیقاً کجای صدا ایراد داشت.
همانطور که در تحلیلهای قبلی ما دربارهی بازشناسی گفتار اشاره کردیم، عبور از تشخیص کلی کلمات به سمت تحلیل ریز-صوتی، مرز جدید این فناوری است. برای بررسی اینکه آیا نرمافزار میتواند این شکاف را پر کند، این فرضیه آزمایش شد که یک موتور گفتار معمولی میتواند یک صدای اشتباه را به اندازه یک گوش آموزشدیده تشخیص دهد. برای این کار ابتدا باید تعریف کنیم «شنیدن لهجه» دقیقاً به چه معناست، چون لهجه یک پدیده واحد نیست و حداقل از دو جزء متمایز تشکیل شده است.
اجزای تشکیلدهنده یک لهجه
لایه اول شامل صداهای منفرد یا فونیمها (Phonemes) است. برای مثال، زبان روسی دارای مصوت ы است؛ صدایی که در زبان انگلیسی وجود ندارد. انگلیسیزبانها هنگام مواجهه با آن، معمولاً به نزدیکترین معادل خود یعنی и (صدای ee در کلمه see) روی میآورند. جایگزینی این دو صدا فقط یک لهجه ایجاد نمیکند، بلکه میتواند معنای کلمه را کاملاً تغییر دهد و منجر به سوءتفاهم شود.
لایه دوم، پروزودی (Prosody) است؛ یعنی ملودی، استرس و ریتم گفتار. پروزودی شبیه «آهنگی است که وقتی کلمات یک ترانه را فراموش میکنید، زیر لب زمزمه میکنید». این همان مکانیزمی است که اجازه میدهد کلمه "really" بسته به لحن، یا معنای تایید بدهد یا کنایه و تمسخر، در حالی که هر دو حالت از سه سیلاب کاملاً یکسان استفاده میکنند. این لایه، جریان رفتوبرگشت گفتگو را مدیریت کرده، احساسات را منتقل میکند و بدون تغییر در حتی یک کلمه، یک جمله خبری را به سوال تبدیل میکند.
دشواریهای تحلیل ملودی
پژوهشها در زمینه گفتار زبان دوم نشان میدهد که درست زدن ملودی و ریتم، بیشتر از اجرای بینقص تکتک صداها به فهم شنینده کمک میکند. انسانها معمولاً با یک مصوت خارجی کنار میآیند و آن را میپذیرند، اما وقتی استرس یا تأکید روی سیلاب اشتباه قرار بگیرد، دچار سردرگمی میشوند و درک مطلب مختل میشود. این وضعیت یک چالش فنی بزرگ برای نرمافزار ایجاد میکند:
- فونیمها بهعنوان عکسهای لحظهای: یک صدای منفرد، رویدادی کوتاه و محلی است. ماشین میتواند آن را با یک مرجع مقایسه کرده و سریعاً نمره دهد.
- پروزودی بهعنوان یک شکل: پروزودی یک منحنی است که در کل عبارت پخش شده است. این مورد شامل بالا و پایین رفتن گام صدا (Pitch) و کشیدگی یا فشردگی سیلابهاست.
- سد نمرهگذاری: برای نمره دادن به پروزودی، ماشین باید آهنگ صدا را در طول زمان دنبال کند و کل منحنی صوتی را قضاوت کند، نه یک لحظه کوتاه یا یک عکس لحظهای را. همین موضوع استخراج دادههای مفید از ملودی صدا را بهطور واقعی سخت میکند.
آزمون دقت صوتی
برای تست اینکه آیا ماشین واقعاً میتواند لهجه را «بشنود»، آزمایش روی «جفتهای کمینه» (Minimal Pairs) متمرکز شد؛ یعنی دو کلمه که تنها در یک صدا با هم تفاوت دارند. در زبان روسی، کلمات мыл (شست) و мил (مهربان) فقط در مصوتهای ы و и تفاوت دارند.
به نقل از نتایجی که در وبسایت juliantellez.com منتشر شد، یافتهها تکاندهنده بود:
- مصوت صحیح روسی (ы): امتیاز ۱۰۰ گرفت.
- لغزش رایج انگلیسیزبانان (и): امتیاز را به ۴.۸ رساند.
- جفت دیگر، быть (بودن) و бить (زدن): با جابجایی مصوت، امتیاز از ۱۰۰ به صفر سقوط کرد.

این نتایج ثابت میکند که موتور Azure صرفاً سختگیر نیست، بلکه قدرت تفکیک دارد. نمرهدهندهای که خطاها را میگیرد، تنها زمانی مفید است که گفتار صحیح را هم قبول کند و همزمان دادههای بیمعنی را رد کند. این نرمافزار ضبطهای پاک بومی (Native) از کلمات معمولی را با امتیاز نزدیک به ۱۰۰ پذیرفت، به این معنی که «سقف نمره» دقیقاً در جایی است که باید باشد. در مقابل، وقتی فایل صوتی اصلاً با کلمات ادعاشده مطابقت نداشت، امتیاز به جای اینکه در محدوده ۸۰ بماند و بهطور تصادفی نمره بگیرد، به صفر رسید.
ظرافتهای انگلیسی و پروزودی
در زبان انگلیسی، جایی که این موتور در «زمین خود» (Home Turf) بازی میکند، نمرهگذاری با ظرافت بیشتری عمل میکند. ماشین از سقوط مطلق به صفر اجتناب کرده و نمرات جزئی (Partial Credit) میدهد. این رفتار صادقانهتر است، زیرا اشتباه در گفتن "ship" به جای "sheep" غلط است اما باعث نمیشود کلمه کاملاً نامفهوم شود.
- لغزش مصوت: در تست "sheep" (مصوت بلند FLEECE) در برابر "ship"، موتور خطا را شناسایی کرد اما امتیاز اشتباه را ۸۸ داد.
- لغزش صامت: تغییر "think" (که با صدای th انگلیسی شروع میشود) به "sink" (استفاده از صدای s) منجر به امتیاز ۶۸ شد و نبود صدای "th" را بهدرستی ثبت کرد.
فراتر از صداهای منفرد، موتور Azure پروزودی انگلیسی را نیز ردیابی میکند. در تست جمله "I would like a cup of tea, please"، سیستم امتیاز جداگانهای (۹۱) برای آهنگ و ریتم ارائه داد. این تایید میکند که ماشین میتواند «آهنگ» یک عبارت را قضاوت کند و شکل صدا را در کل یک جمله دنبال نماید.
شکاف مربیگری و محدودیتها
با وجود این قابلیتها، نرمافزار فعلاً توانایی مربیگری (Coaching) ندارد. شنیدن خطا، نیمه آسان کار است. نیمه سختتر و انسانی، این است که به زبانآموز بگوییم دقیقاً زبان و لبهای خود را چگونه حرکت دهد تا صدا اصلاح شود و این کار را با مهربانی و صبوری انجام دهد.
طبق گزارش این آزمایش، سه محدودیت حیاتی وجود دارد که واقعیت فعلی این فناوری را محدود میکند:
- صداهای مصنوعی در برابر انسانی: در این تست از صداهای سنتتیک استفاده شد. زبانآموزان واقعی خطاهای «میانه» یا نیمهکاره میگیرند که باید در وسط مقیاس نمره بگیرند، نه لزوماً صفر یا ۱۰۰. حساسیت موتور وجود دارد، اما رفتارش در برابر گفتار نامنظم و «کثیف» انسانی هنوز یک آزمایش مجزا است.
- بازخورد کلی: اگرچه موتور نمره پایین را شناسایی میکند، اما در مورد اینکه کدام صدا دقیقاً چقدر اشتباه بوده، کلیگویی میکند. در برخی زبانها، اصلاً صداها را برچسبگذاری نمیکند. تبدیل عبارت «این کلمه نمره پایینی گرفت» به «مصوت ы شما بهطور مشخص به سمت и متمایل شد»، نیازمند بازسازی دادهها روی موتور اصلی است.
- پشتیبانی نامساوی: نمرهگذاری پروزودی فقط برای برخی لهجهها ارائه شده است. این در حالی است که ملودی، اصلیترین بخش لهجه است اما کمترین پشتیبانی یکسان را در میان زبانها دارد.
برای یک زبانآموز عادی، این یعنی بخش «علمی-تخیلی» هوش مصنوعی — یعنی تشخیص دقیق صدایی که جا انداختید — همین حالا به واقعیت تبدیل شده است. ما از عصر بازخوردهای مبهم به عصر دادههای صوتی کمّیشده میرویم.
اگر شما در حال ساخت اپلیکیشنهای گفتاری هستید، نقطه عطف بعدی که باید زیر نظر بگیرید، ادغام این نمرات در حلقههای بازخورتی بلادرنگ (Real-time) است که بتواند دستورات یک مربی انسانی را شبیهسازی کند.
گام بعدی شما
- اگر توسعهدهنده اپلیکیشنهای گفتاری هستید، روی ادغام این نمرات در حلقههای بازخورتی بلادرنگ (Real-time) تمرکز کنید تا شبیه به دستورات یک مربی انسانی عمل کند.
- برای ارزیابی دقیقتر، تفاوت بین نمرات Phoneme و Prosody را در APIهای Azure بررسی کنید تا متوجه شوید کاربر در کلمه مشکل دارد یا در آهنگ جمله.
- از ابزارهای ضبط با کیفیت بالا برای کاهش نویز استفاده کنید، زیرا حساسیت بالای موتور ممکن است نویزی را به عنوان خطای تلفظی شناسایی کند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.


گفتگو