تغییر تنها یک کلمه در پرامپت شما میتواند هزینههای استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — را در پلتفرم Bailian تا ۶۰۰٪ افزایش دهد. آزمایشهای کنترلشدهای که در ۴ سپتامبر ۲۰۲۶ انجام شد، فاش میکند که حافظه صریح (Explicit Cache) این پلتفرم برخلاف تصور رایج، یک حافظه پیشوندی (Prefix Cache) نیست، بلکه صرفاً آینهای برای درخواستهای کاملاً یکسان و کلمه به کلمه است.
بسیاری از توسعهدهندگان تصور میکنند وقتی یک پایگاه دانش را بهعنوان «کششده» علامتگذاری میکنند، مدل میتواند از آن بلوک برای هر سؤال بعدی استفاده کند؛ رفتاری که در سرویسهایی مثل Anthropic استاندارد است. اما دادهها نشان میدهد که در Bailian، کل آرایه پیامها باید بایتبهبایت یکسان باشد تا سیستم حافظه فعال شود و تطبیق (Hit) رخ دهد.
همانطور که در تحلیل قبلی ما دربارهی بهینهسازی توکنها اشاره کردیم، مدیریت حافظه کلید کاهش هزینههاست. در این ممیزی فنی، حافظه ضمنی (Implicit Caching) — جایی که سرور بهطور خودکار پیشوندهای مشترک را ذخیره میکند — در برابر حافظه صریح (Explicit Caching) قرار گرفت، جایی که توسعهدهنده بهصورت دستی یک بلوک را با استفاده از نشانگر cache_control برای ذخیرهسازی علامتگذاری میکند. در این تست از مدل qwen3.8-max با یک پیشوند ۷۹۲۹ توکنی در ۱۱ فراخوانی پولی استفاده شد که در مجموع ۰.۹۳ یوان هزینه داشت.
تلهٔ هزینههای «صریح»
روی کاغذ، قیمتگذاری qwen3.8-max نشان میدهد که حافظه صریح ارزانترین مسیر است. طبق جدول قیمتهایی که در لحظه استخراج شد:
- ورودی: ۱۲ یوان در هر میلیون توکن (۱۰۰٪)
- خروجی: ۳۶ یوان در هر میلیون توکن
- تطبیق ضمنی (Implicit hit): ۱.۵ یوان (۱۲.۵٪ ورودی)
- ایجاد صریح (Explicit creation): ۱۵ یوان (۱۲۵٪ ورودی)
- تطبیق صریح (Explicit hit): ۱ یوان (۸.۳۳٪ ورودی)
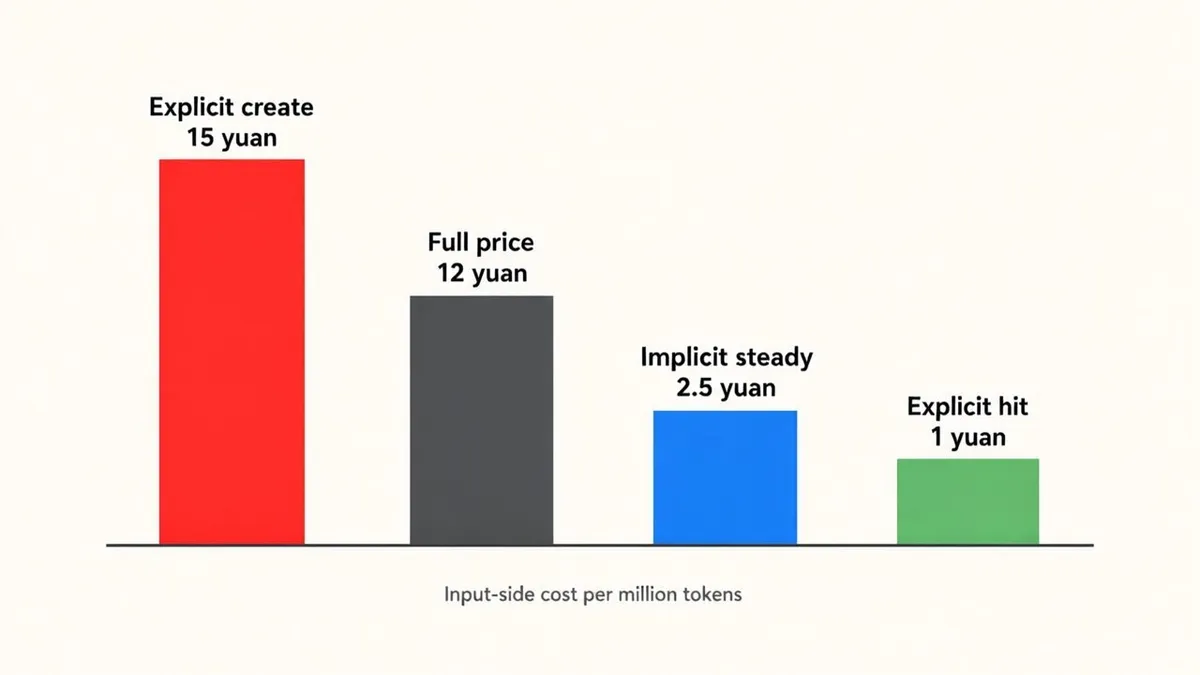
اما این اعداد هزینه «ایجاد» را نادیده میگیرند: ۱۵ یوان برای هر میلیون توکن جهت مقداردهی اولیه حافظه صریح. در یک سناریوی واقعی خدمات مشتری — که در آن یک پیشوند ثابت از پایگاه دانش وجود دارد و به دنبال آن ۵ سؤال متفاوت پرسیده میشود — نتایج تکاندهنده بود:
- حافظه ضمنی: هزینه کل ۰.۱۷۵۰ یوان.
- حافظه صریح: هزینه کل ۰.۵۹۴۶ یوان.
به دلیل تفاوت در سؤالات، حافظه صریح در هر بار درخواست شکست خورد (Miss). کاربر برای هر درخواست، ۱۲۵٪ هزینه ایجاد را پرداخت کرد و در نهایت هزینه ۳.۴ برابر بیشتر از حالتی شد که هیچ حافظهای فعال نبود. در حالت پایدار (Steady State)، هزینه هر سؤال ۵.۹۶ برابر بیشتر از حافظه ضمنی بود.
سازوکار واقعی تشخیص تطبیق
برای یافتن مرز خطا، یک آزمایش کنترلشده ۹ ثانیهای انجام شد. اولین فراخوانی (B0) حافظه را ایجاد کرد. فراخوانی دوم (B1) با سؤالی متفاوت که ۱۲ ثانیه بعد ارسال شد، منجر به عدم تطبیق کامل و پرداخت هزینه کامل ایجاد شد.
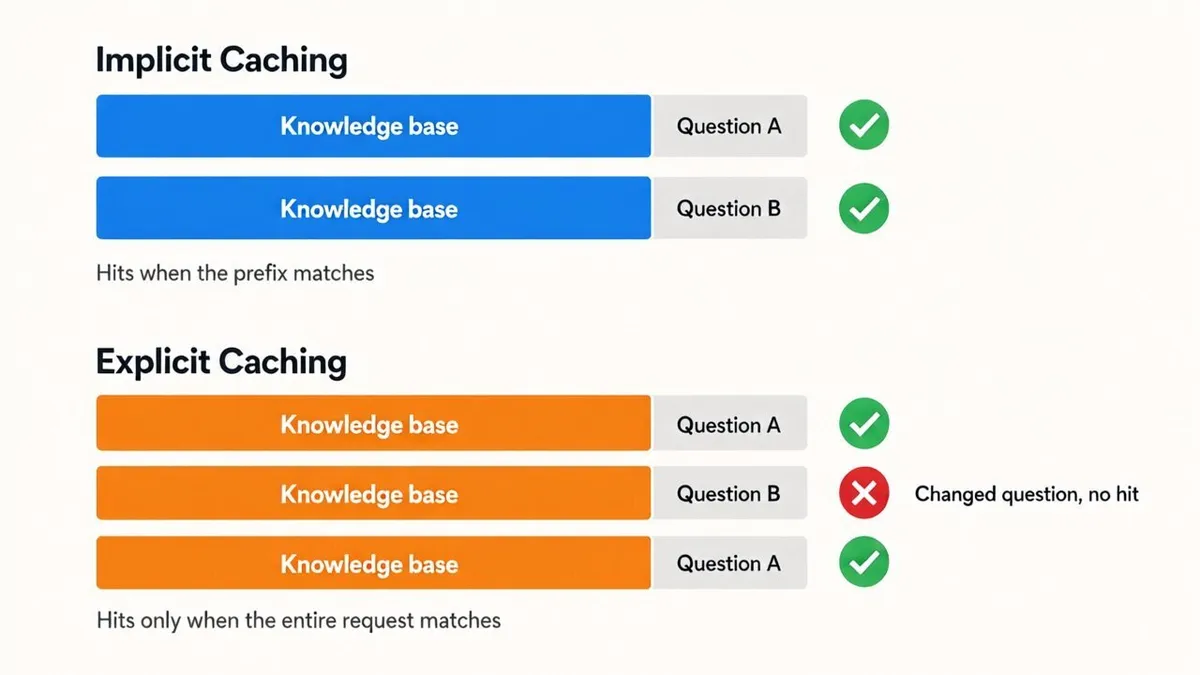
تنها زمانی که دقیقاً همان سؤال بهصورت کلمه به کلمه و عیناً ارسال شد، حافظه صریح فعال گشت. این ارزانترین فراخوانی در کل مطالعه بود (۰.۰۲۰۲ یوان) که ۲۹٪ کمتر از بهترین تطبیق ضمنی بود؛ اما این اتفاق فقط در صورت یکسانی مطلق درخواست رخ میدهد.
پنجره انقضای ۵ دقیقهای
یک محدودیت زمانی پنهان در نام فیلدهای صورتحساب وجود دارد. فیلد input_token_cache_creation_5m نشاندهنده زمان بقای (TTL) ۵ دقیقهای است. این جزئیات در لیست قیمتها بود، نه در مستندات فنی.
تستها این موضوع را تأیید کردند: یک درخواست کاملاً یکسان (B3) که ۸ دقیقه و ۱۳ ثانیه بعد از ایجاد ارسال شد، منجر به هزینه کامل ایجاد برای ۷۹۲۳ توکن شد. حافظه صریح زودگذر (Ephemeral) است؛ اگر در ۵ دقیقه از آن استفاده نکنید، سرمایهگذاری اولیه شما در هزینه ایجاد از بین میرود.
تضادهای حافظه ضمنی
حافظه ضمنی منعطفتر است اما دقت کمتری دارد. این سیستم بدون توجه به سؤال، روی پیشوندها تطبیق میدهد، اما دادهها را در بلوکهای ۱۰۲۴ توکنی ذخیره میکند.
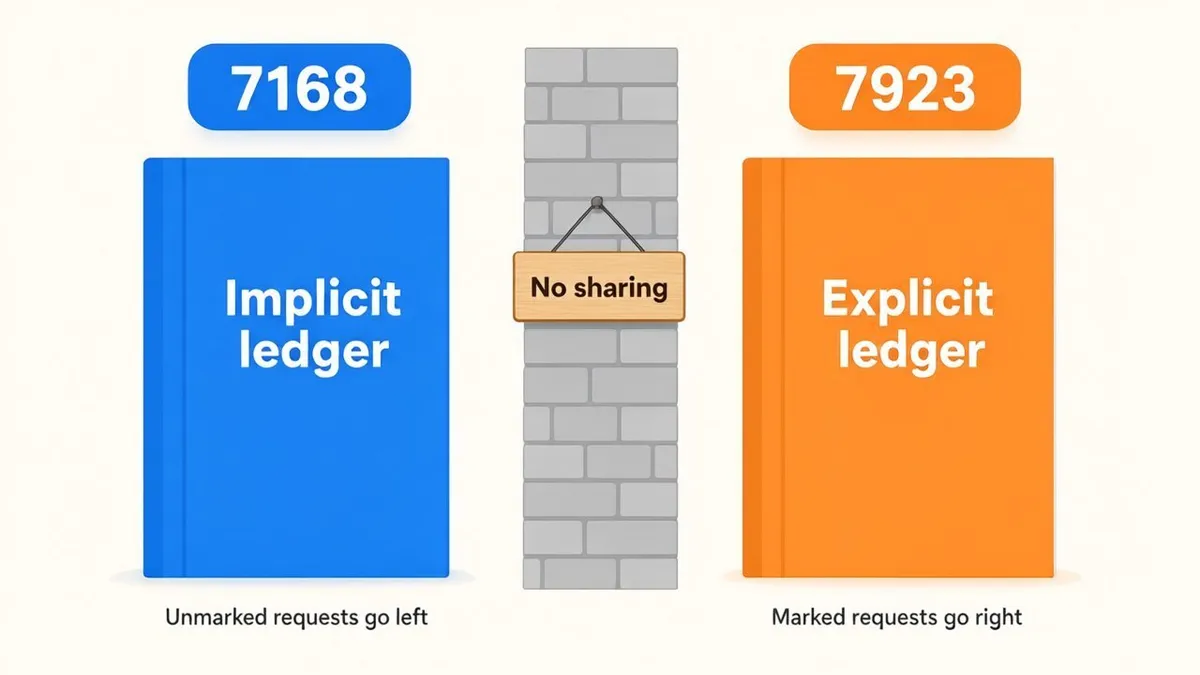
در تستها، پرامپتی با حدود ۷۹۰۰ توکن، بهطور مداوم برای دقیقاً ۷۱۶۸ توکن (۷ ضربدر ۱۰۲۴) تطبیق یافت. ۷۶۷ توکن باقیمانده هر بار با قیمت کامل محاسبه شدند. این یعنی تخفیف واقعی نه ۱۲.۵٪، بلکه نزدیک به ۲۱٪ قیمت لیست است (۲.۵۱۵ یوان در هر میلیون توکن).
دفاتر حساب جداگانه
نکته حیاتی این است که این دو سیستم با هم ارتباط ندارند. بررسی چهار جهت تعامل نشان داد:
- صریح، ضمنی را نمیبیند: درخواستی که علامتگذاری شده بود (B0)، صفر توکن کششده برگرداند، در حالی که لحظاتی قبل یک فراخوانی ضمنی (A4) با ۷۱۶۸ توکن موفق شده بود.
- ضمنی، صریح را نادیده میگیرد: یک درخواست ضمنی (D1) روی ۷۱۶۸ توکن تطبیق یافت و حافظه صریح ۷۹۲۳ توکنی را که ثانیهای پیش ایجاد شده بود، نادیده گرفت.
- ایجاد صریح، زنجیره ضمنی را نمیشکند: اجرای آزمایشهای صریح، دفتر حساب حافظه ضمنی را دستنخورده باقی میگذارد.
- دفاتر مجزا: این دو کانال کاملاً دفاتر مالی و توکنی جداگانهای دارند.
بررسی طول عمر حافظه ضمنی
برای تعیین زمان بقای حافظه ضمنی، آزمایشاتی با فواصل زمانی کنترلشده انجام شد:
- A1 (دو روز بعد): صفر توکن تطبیق. پرداخت قیمت کامل. حافظه کاملاً پاک شده بود.
- A2 (۲۰ ثانیه بعد): ۷۱۶۸ توکن تطبیق. هزینه: ۰.۰۳۴۵ یوان.
- A3 (۹ دقیقه و ۳۲ ثانیه بعد): ۷۱۶۸ توکن تطبیق. هزینه: ۰.۰۲۸۵ یوان.
- A4 (۱۳ دقیقه و ۵۹ ثانیه بعد): ۷۱۶۸ توکن تطبیق. هزینه: ۰.۰۴۱۹ یوان.
تا لحظه A4، حافظه ۲۳.۵ دقیقه پس از اولین تطبیق زنده مانده بود. حافظه ضمنی حداقل ۱۴ دقیقه زنده میماند و طی دو روز از بین میرود، هرچند مرز دقیق آن نامشخص است.
جزئیات پیادهسازی
به دلیل نبود کلمه «cache» یا «缓存» در مستندات bailian-cli (صفر نتیجه)، پژوهشگر از فلگ --messages-file برای ارسال ساختار API مورد نیاز استفاده کرد.
- ساختار ضمنی: محتوای کاربر یک رشته واحد (String) شامل آرتیفکت و سؤال است.
- ساختار صریح: محتوای کاربر یک آرایه (Array) است و بلوک پایگاه دانش با مقدار
"cache_control": {"type": "ephemeral"}علامتگذاری میشود.
تأیید ارسال صریح در فیلد prompt_tokens_details و عبارت ephemeral_5m_input_tokens یافت شد.
ماتریس کاربرد عملی
برای کسانی که هزینههای LLM در محیط عملیاتی را مدیریت میکنند، انتخاب بستگی به شکل حجم کاری دارد:
- پرسشوپاسخ خدمات مشتری: از حافظه ضمنی استفاده کنید. تفاوت در سؤالات باعث میشود حافظه صریح به یک بدهی مالی تبدیل شود.
- مجموعههای ارزیابی و تکرار دستهای (Batch Retries): از نشانگرهای صریح استفاده کنید. هنگام اجرای یک پرامپت یکسان روی نسخههای مختلف یا تکرار درخواستهای مشابه، حافظه صریح در تکرار سوم به نقطه سربهسر میرسد و تا تکرار دهم، ۳۰.۴٪ در هزینهها صرفهجویی میکند.
- پرسوجوهای با فرکانس پایین: هیچکدام از حافظهها کمک نمیکنند. اگر فاصله پرسوجوها چند ساعت باشد، سیستم همیشه با «شروع سرد» (Cold Start) و قیمت کامل مواجه میشود؛ در این حالت بازگشت به روش بازیابی (Retrieval) را بررسی کنید.
برای آرتیفکتهای کامپایلشده، حکم نهایی روشن است: هیچ تنظیماتی انجام ندهید و به حافظه ضمنی تکیه کنید. تنها بهینهسازی موجود، مدیریت زمانبندی است — یعنی نگه داشتن سؤالات متوالی در یک پنجره ۱۴ دقیقهای تا پیشوند ۷۱۶۸ توکنی در دفتر حساب ضمنی «گرم» بماند.
در گام بعدی، تمرکز بر دسترسیهای مبتنی بر مجوز خواهد بود. از آنجایی که آرتیفکتهای کامپایلشده کل کتابخانه را در یک بلوک ادغام میکنند، چالش بعدی تعیین این است که چگونه این آرتیفکتها را برای دفاع از دادههای حساس در نقشهای مختلف کاربری (مثلاً جداسازی سیاستهای مالی از دادههای عمومی مشتریان) تفکیک کنیم.



گفتگو