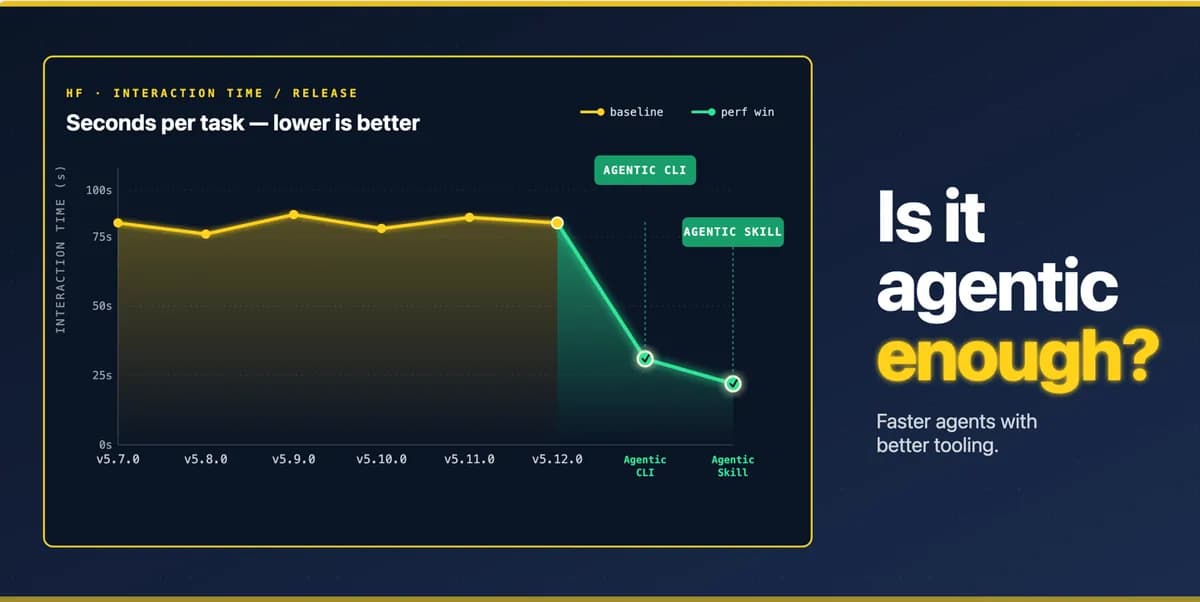
اگر امروز در حال توسعه یک کتابخانه نرمافزاری هستید، کاربر اصلی شما دیگر فقط یک برنامهنویس انسان نیست، بلکه یک عامل هوش مصنوعی است. در ۱۸ ژوئن ۲۰۲۶، شرکت Hugging Face ابزار ارزیابی جدیدی به نام agent-eval را منتشر کرد. این ابزار طراحی شده است تا نه تنها بررسی کند که آیا یک عامل به پاسخ درست میرسد یا خیر، بلکه اندازهگیری کند که رسیدن به آن پاسخ دقیقاً چقدر هزینه و تلاش دارد.
عاملهای کدنویسی بهطور فزایندهای بهجای ما با نرمافزارها تعامل میکنند. کاربر وظیفهای را توصیف میکند و عامل، کتابخانه مناسب را انتخاب میکند، فراخوانیها را مینویسد، آنها را اجرا میکند و خطاهای خود را عیبیابی میکند. طبق گزارش Hugging Face، اگر یک کتابخانه در مسیر عامل قرار بگیرد یا مانع شود، عامل با خوشحالی آن را دور میزند و منطق را از ابتدا بازنویسی میکند. این موضوع یک نیاز جدید را معرفی میکند: کدها نباید فقط درست و سریع باشند، بلکه باید طوری طراحی شوند که یک عامل بتواند بهطور مؤثر آنها را هدایت کند. یک API دشوار یا مستندات قدیمی برای برنامهنویسان انسان آزاردهنده است، اما برای یک عامل، اینها مسیری طولانیتر و گرانتر ایجاد میکنند.
سالهاست صنعت بر بنچمارکهای «پاسخ نهایی» تکیه کرده است. در این روش، اگر یک عامل یک قطعه متن را درست دستهبندی کند، موفقیتآمیز علامت میخورد. اما این رویکرد، هزینه سفر را نادیده میگیرد. یک عامل ممکن است با یک دستور ساده در خط فرمان (CLI) به جواب برسد، در حالی که عامل دیگر ۴۰ خط کد پایتون مینویسد، کتابخانه transformers را وارد میکند، با یک خطای ابعادی (shape error) میجنگد، دو بار کد را اجرا میکند و در نهایت پاسخ را چاپ میکند. هر دو به نتیجهای مانند POSITIVE (0.9999) میرسند، اما دومی بسیار گرانتر و شکنندهتر است.
با تکیه بر این فلسفه که کد باید قابل کشف باشد و برای استفاده عاملها تست شود، Hugging Face از کتابخانه transformers خود به عنوان یک مطالعه موردی استفاده کرد. آنها بر اساس دو اصل محوری عمل میکنند: «اگر تست نشده، پس کار نمیکند» و «اگر مستند نشده، پس وجود ندارد». در قلمرو ابزارهای بهینهشده برای عاملها، این دو اصل مستقیماً به هم گره میخورند. برای اینکه ابزاری برای یک عامل «وجود داشته باشد»، باید از طریق APIهای شفاف و مستندات گسترده و ساختاریافتهای که دسترسی سریع به مثالها را فراهم میکند، قابل کشف باشد.
هدف این بود که بررسی شود آیا افزودن یک رابط خط فرمان (CLI) اختصاصی و یک «مهارت» (Skill) — که شامل مستندات منتخب و مثالهای کاربردی است — بار ذهنی عاملها را کاهش میدهد یا خیر. این دستورالعمل پیشتر در hf CLI اعمال شده بود و در آنجا عاملها ۱.۳ تا ۱.۸ برابر (و در برخی موارد تا ۶ برابر) توکنهای کمتری مصرف کردند. Hugging Face میخواست بداند آیا این پیروزی قبل از افزودن چندین هزار خط کد به مخزن transformers، به صورت کلی قابل تعمیم است یا خیر.
چارچوب بنچمارک
ابزار agent-eval وظایف را در سه «سطح» (Tier) متمایز از کمک به عامل اجرا میکند که این سطوح تو در تو نیستند:
- Bare: یک نصب ساده با
pip install transformersبدون هیچ زمینه اضافی. - Clone: عامل به کل کد منبع transformers در دایرکتوری کاری دسترسی دارد.
- Skill: یک بسته مهارت شامل مستندات CLI و مثالهای وظایف که در پنجره متنی (Context) عامل بارگذاری شده است.
این سطوح انواع مختلفی از کمک را ارائه میدهند. برای مثال، مدل Skill بهجای کل درخت کد منبع، مستندات منتخب را ارسال میکند. نکته جالب این است که بسته به نوع وظیفه، برخی مدلها ممکن است در سطح Clone بهتر از سطح Skill عمل کنند.
برای تضمین مقایسهای عادلانه، هر اجرا به عنوان یک Hugging Face Job مجزا (یک مورد برای هر مدل × نسخه × وظیفه) روی سختافزارهای یکسان انجام شد. این کار تضمین میکند که کل بررسی بهصورت موازی و بدون تغییرات سختافزاری اجرا شود. نتایج و ردپاها (Traces) در یک Hugging Face Bucket ذخیره شدند تا همزمانی بالای نوشتن و دسترسی سریع بدون نیاز به نسخهبندی مدیریت شود. سیستم در حال حاضر بر وظایف قطعی (Deterministic) تمرکز دارد که تطابق دقیقی برای آزمایش فراهم میکنند، هرچند استفاده از «مدل بهعنوان داور» (Model-as-a-judge) برای وظایف غیرقطعی به عنوان گام بعدی ذکر شده است.
معیارهای ارزیابی و جزئیات
این ابزار هر اجرا را بر اساس چندین محور میسنجد تا مشخص شود چه چیزی برای کلاسهای مختلف مدلها اهمیت دارد:
- درصد تطابق (Match %): آیا پاسخ نهایی شامل نتیجه مورد انتظار است؟ (با استفاده از زیررشتههای حساس نبودن به حروف بزرگ و کوچک، regex یا تطابق دقیق که همگی در گزارش تصریح شدهاند).
- میانه زمان و توکنها: ردیابی توکنهای جدید، کششده و تولید شده برای اندازهگیری میزان تلاش.
- درصد اجراهای خطا (Runs with Error %): یک محافظ که اجراهای تولیدکننده صفر توکن خروجی یا بدون فراخوانی ابزار را علامتگذاری میکند تا شکستهای خاموش بهعنوان «صفر» شمرده نشوند.
- پذیرش نشانگر (Marker Adoption): استفاده از الگوهای نامگذاری شده برای ردیابی رفتارهای خاص.
پیروزی مدلهای بزرگ
برای بزرگترین مدلهای بازمتن — مانند Kimi-K2.6، GLM-5.1 و MiniMax-M2.7 — نتایج واضح بود. وقتی سطح «Skill» در اختیار آنها قرار گرفت، این مدلها رفتار خود را به سمت CLI جدید تغییر دادند. بهجای نوشتن اسکریپتهای پیچیده پایتون، از دستورات سادهای مانند transformers classify --model ... --text "..." استفاده کردند.
این تغییر منجر به کاهش قابل توجه در میانه زمان صرف شده برای وظایف شد. مدلهای بزرگ در واقع «زمان تفکر» و عیبیابی را با مقدار کمی مطالعه اولیه معاوضه کردند. در حالی که در حالت Clone، توکنهای ورودی افزایش یافت (از حدود ۴ هزار به ۶.۴ هزار) زیرا عاملها درخت /cli/ و مثالهای کاربردی cli/agentic/*.py را برای یادگیری رابط میخواندند، اما کارایی کلی بهبود یافت. کامیت (Commit) که CLI و Skill را معرفی کرد، بهطور مؤثر بار کاری عاملها را سبک کرد، همانطور که در نمودار میانه زمان به ازای هر نسخه مشاهده میشود و کامیت Skill (نقطه سبز) سریعترین است.
در استفاده واقعی، این هزینه کشف در طول بسیاری از وظایف سرشکن (Amortize) میشود. چون هر اجرا در این بنچمارک یک عامل تازه است، هر بار هزینه کشف را میپردازد که نشاندهنده بدترین سناریوی ممکن است. در جلسات واقعی، یک عامل یکبار رابط را یاد میگیرد و وظایف بعدی را بدون بازخوانی منبع حل میکند، که این امر CLI را به یک برد خالص و عظیم برای مدلهای با توانایی بالا تبدیل میکند.

سقوط مدلهای کوچک
بحرانیترین یافته هنگام تست مدلهای کوچکتر ظاهر شد. برای این عاملها، ویژگیهای «بهینه برای عامل» اغلب بهجای نقشه راه، مانند نویز عمل کردند. مدلهای کوچکتر معمولاً به الگوهای API حفظشده از دادههای آموزشی تکیه میکنند، مانند قطعهکد pipeline(...).
در یک مثال تکاندهنده، مدل Qwen3-14B در وظیفه classify-sentiment شاهد سقوط نرخ تطابق خود از ۱۰۰٪ (در سطح Clone) به ۰٪ بود، زمانی که مستندات Skill به آن داده شد. بررسی ردپاهای اجرا نشان داد که مدل به اشتباه تصور کرد Skill یک ابزار است که میتواند مستقیماً فراخوانی کند (مانند یک تابع جستجوی وب)، نه یک دستور shell که باید از طریق bash اجرا شود. در ۳۹ مورد از ۵۶ اجرای Skill، مدل یا یک فراخوانی ابزار transformers(command="classify", ...) صادر کرد — که هرگز ثبت نشده بود — یا نتیجه گرفت که نمیتواند مدلی را اجرا کند و تسلیم شد. بهجای بازگشت به همان کد تکخطی pipeline(...) که در حالت Clone موفقیت ۱۰۰٪ داشت، اعلام کرد که وظیفه غیرممکن است.
به همین ترتیب، Qwen3-4B جهش عظیمی در مصرف توکن داشت بدون اینکه هیچ بهبودی در دقت به دست آورد. در سطح Clone، عامل 4B کد منبع CLI جدید را بهصورت انبوه خواند و باعث شد میانه توکنهای جدید از حدود ۲.۴ هزار به ۲۳ هزار برسد. زمان و خروجی بهشدت افزایش یافت، اما نرخ تطابق ثابت ماند. کامیت CLI + Skill توزیع هزینه را برای این مدل بهشدت گسترده کرد؛ عامل منبع را بهصورت انبوه خواند (حدود ۱۰ برابر توکن جدید) بدون اینکه هیچ سودی در درصد تطابق به دست آورد.
تحلیل نشانگرها: ردیابی رفتار
برای دیدن چیزی فراتر از موفقیت یا شکست ساده، Hugging Face «نشانگرها» (Markers) را معرفی کرد — الگوهای نامگذاری شدهای که پلاگین پروفایل (پلاگین کوچک هر ابزار که به بنچمارک یاد میدهد چگونه یک کتابخانه را بسازد و هدایت کند) با دستورات shell، کدها یا فایلهای یک اجرا تطبیق میدهد. دو نشانگر کلیدی برای transformers عبارت بودند از:
- cli: عامل ابزار خط فرمان
transformersرا فراخوانی کرد. - pipeline: عامل از API سطح بالای پایتون
pipeline(...)استفاده کرد.
دادهها نشان داد که پذیرش CLI بهشدت به نسخه Skill وابسته است. سطح Skill به نرخ پذیرش ۵۵.۳٪ برای CLI رسید. نکته جالب این است که هرچه مدل بزرگتر بود، بیشتر از زمینه جدید (Skill) بهجای حافظه داخلی خود بهره برد، در حالی که مدلهای کوچکتر برای ادغام اطلاعات جدید در تکاپو بودند. این موضوع بهویژه از آن جهت مشهود است که CLI در یک کامیت واحد معرفی شده بود و در دادههای آموزشی هیچ مدلی وجود نداشت.
تضاد در ابهام
این دادهها نشاندهنده یک تنش بنیادی در طراحی عامل-محور است. مدلهای قدرتمند میتوانند مستندات جدید را ترکیب کنند تا راه سریعتری بیابند. اما مدلهای کوچک بهشدت به الگوهای حفظشده وابسته هستند. وقتی شما یک راه جدید و رقیب برای حل یک مسئله معرفی میکنید، ریسک این را میپذیرید که الگوهای قابلاعتماد را با ابهام جایگزین کنید.
اگر Hugging Face این CLI را صرفاً بر اساس عملکرد بزرگترین مدلها منتشر میکرد، بهطور ناخواسته تجربه کاربران مدلهای کوچک و محلی را تخریب میکرد. این موضوع برجسته میکند که چرا APIهای «رو به عامل» باید در طیفی از اندازههای مختلف مدل ارزیابی شوند.
تحلیل: چرخش به مهندسی «عامل-اول»
این تغییر، نشاندهنده گذاری از «تجربه توسعهدهنده» (DX) به «تجربه عامل» (AX) است. در عصر انسان، یک API دشوار فقط یک مزاحمت بود؛ در عصر عامل، این یک نشتی مالی و زمانی است.
برای حوزه گستردهتر یادگیری ماشین، این امر تعریف یک کتابخانه «خوب» را تغییر میدهد. یک کتابخانه دیگر فقط مجموعهای از توابع نیست؛ بلکه مجموعهای از سیگنالها است. اگر ابزاری برای یک عامل قابل کشف نباشد، در واقع وجود ندارد. اثر درجه دوم در اینجا، نیاز به «مهارتهای اعتبارسنجی شده» است. بهجای اینکه انسانها مستندات بنویسند و امیدوار باشند عاملها آن را بفهمند، میتوان از ابزارهایی مانند Upskill استفاده کرد تا راه حل یک مدل قدرتمند را تنها زمانی به یک Skill تبدیل کند که بهطور قابلسنجشی به موفقیت مدلهای کوچکتر کمک کند.
اگر شما یک نگهدارنده (Maintainer) هستید، درس روشن است: هرگز یک «سادهسازی» را بر اساس تست با GPT-4 یا Claude 3.5 ادغام نکنید. اگر این تغییر یک مدل ۷ میلیاردی را گیج کند، شما در حال ایجاد یک نقطه شکست برای بخش قابل توجهی از کاربران خود هستید.
گامهای بعدی
توسعهدهندگان اکنون میتوانند از CLI ابزار agent-eval برای تست کتابخانههای خود با تعریف وظایف و پاسخهای مورد انتظار استفاده کنند. این ابزار بر پایه پروفایل است و با هر ابزاری که از خط فرمان اداره شود سازگار است. شما میتوانید نمایشگر ردپاهای عامل (agent-traces) را در Hugging Face Hub بررسی کنید تا دقیقاً ببینید عاملهای شما در کجای کدتان، دستور به دستور، گم میشوند. گزارش زنده، بخشهای Overview، Coverage و Results را بهطور کامل در سمت کلاینت ارائه میدهد، از جمله یک دکمه «فقط وظایف مشترک» برای جلوگیری از میانگینهای گمراهکننده در زمان نامتوازن بودن پوشش.
نکته: این ابزار یک عامل کدنویسی را با دسترسیهای دورزده (Bypassed) اجرا میکند و کدها را از نسخه مشخص شده اجرا مینماید. کاربران باید قبل از اشاره به کدهای غیرقابل اعتماد، فایل SECURITY.md را مطالعه کنند. دستورالعملهای کامل راهاندازی و استفاده در README پروژه موجود است.
سخن پایانی
بررسی پاسخ نهایی به شما میگوید که آیا یک عامل میتواند از کتابخانه شما استفاده کند یا خیر. اما نمیگوید که این کار چقدر هزینه دارد: تعداد دورها، توکنها، خطاها و مسیری که برای رسیدن به آنجا طی کرده است. این ابزار، این موارد را در نسخهها و مدلهای انتخابی شما اندازهگیری میکند. در مورد transformers، این ابزار تغییری را شناسایی کرد که احتمالاً بر اساس باور محض منتشر میشد: یک CLI که به بزرگترین مدلهای بازمتن کمک میکرد اما به کوچکترینهای آنها آسیب میزد.
این پروژه بر پایه pi، رابط خط فرمان عامل کدنویسی ماریو زکنر (Mario Zechner) بنا شده است که هر اجرای مدل باز را هدایت میکند و پیمایشهای عملی مدلهای باز را تنها با یک HF_TOKEN امکانپذیر میسازد. در تمام سطوح، سازندگان مدلها و ارائهدهندگان استنتاج درگیر در این پروژه، عملکردی بسیار بالاتر از آنچه خط پایه Bare پیشنهاد میداد، داشتند.



گفتگو