اگر برای مدیریت عاملهای خود از فایلهای مرجع مجزا استفاده میکنید، احتمالاً بخشی از دستورات حیاتی شما در سکوت نادیده گرفته میشوند. یک گزارش فنی منتشر شده در ۴ اکتبر ۲۰۲۶ ثابت میکند که تجمیع تمام دستورالعملها در یک فایل واحد به نام SKILL.md، مانع از پرشهای تصادفی Claude Code از مراحل اجرایی میشود. این گزارش مستقیماً توصیههای رسمی مستندات را به چالش میکشد و ثابت میکند که ادغام تمام دستورالعملها در یک فایل واحد، از نادیده گرفته شدن مراحل حیاتی توسط مدل جلوگیری میکند. این موضوع یادآور چالشهای مشابهی است که در تداخل فایلهای تنظیمات Claude Code و نادیده گرفته شدن دستورات مشاهده شده بود.
این بهینهسازی در زمانی رخ میدهد که توسعهدهندگان برای ایجاد تعادل بین هزینه توکن (Token) — تکههای کوچکی از متن که مثل برشهای یک کیک طولانی هستند و مدل آنها را میخورد — و قابلیت اطمینان عاملها در تکاپو هستند. همانطور که در تحلیل قبلی ما دربارهی اتصال Claude به محیطهای ایزوله در Burrowbox اشاره کردیم، تمرکز اکنون از بحث اتصال به دقت منطق داخلی عاملها تغییر کرده است. برای اکثر کاربران، این تفاوت شبیه به این است که به یک کارمند یک چکلیست واحد بدهید یا یک دفترچه راهنما با چندین پیوست که احتمال فراموش کردن باز کردن آنها زیاد است.
زمینه و ساختار خط لوله
به نقل از گزارش وبسایت dev.to، این تیم یک خط لوله (Pipeline) عامل خودکار را مدیریت میکرد که وظیفه انتشار، پاسخدهی و اندازهگیری در فضای عمومی را بر عهده داشت. تقریباً تمام رویههای این سامانه در بخش مهارتهای پروژه و در مسیر .claude/skills/ قرار داشتند.
طبق این گزارش، تیم در ۱۸ اوت ۲۰۲۶ ابتدا از ساختار رسمی «افزودن فایلهای پشتیبان» پیروی کرد؛ یعنی یک فایل SKILL.md کوتاه برای مراحل جاری و یک فایل reference.md مجزا برای متن کامل و تاریخچه قوانین پشت هر قانون. در این حالت، ۷ مورد از ۹ مهارت دارای فایل مرجع بودند که حجم این فایلها بین ۳۹ تا ۲۸۸ خط متغیر بود.
اما تا ۱۸ سپتامبر ۲۰۲۶، آنها این استراتژی را تغییر دادند و ۷ مهارت از ۹ مهارت را دوباره در فایلهای تکفایلی ادغام کردند. تاریخچه قوانین به پوشه docs/ منتقل شد که خارج از پوشه مهارتها بود، در حالی که تمام مراحل جاری، آستانهها و ممنوعیتها مستقیماً به SKILL.md بازگشتند. این رویکرد برای مقابله با آشفتگی در مدیریت فایلهای برنامهریزی است، مشابه آنچه ابزار Pentimento برای تبدیل فایلهای پراکنده به سلسلهمراتب ساختاریافته ارائه میدهد.
جزئیات فنی و تبادلها
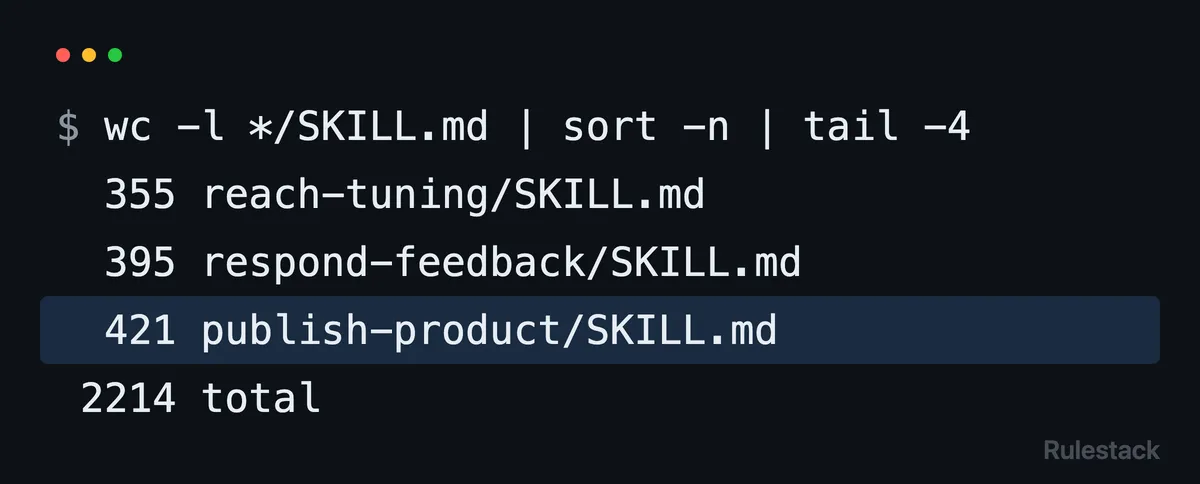
تیم برای تضمین این ساختار، یک تست سختگیرانه در زمان Commit اجرا کرد تا مطمئن شود هیچ فایل مارکداونی بهجز SKILL.md در پوشههای مهارت وجود ندارد؛ تنها زیرپوشههای مجاز scripts/ و assets/ هستند. اندازه مهارتهای فعلی بین ۱۰۷ تا ۴۲۱ خط است.
- بزرگترین مهارت: ۴۲۱ خط (که به زبان ژاپنی نوشته شده) با مجموع ۳۴,۲۷۹ کاراکتر.
- ریسک: توصیههای رسمی پیشنهاد میکنند SKILL.md زیر ۵۰۰ خط بماند تا از تورم توکنها و افزایش هزینهها جلوگیری شود.
- شکست: در یک اجرای اخیر در همین هفته، به دلیل فشردهسازی گفتگو، عامل نیمی از بخش پایینی مهارتها را قطع کرد.
قطعشدگی و فشردهسازی (Truncation and Compaction)
Claude Code محتوای SKILL.md را به صورت یک پیام واحد رندر میکند که در حافظه گفتگو میماند. پس از فشردهسازی (Compaction)، مدل آخرین فراخوانی هر مهارت را مجدداً متصل میکند و تنها ۵,۰۰۰ توکن اول هر مهارت را نگه میدارد، در حالی که سقف کلی ۲۵,۰۰۰ توکن برای تمام مهارتهای متصلشده وجود دارد.
در یک مورد که سه مهارت درگیر بودند، گفتگو در میانه راه فشرده شد و هر سه مهارت ناقص بازگشتند. مقایسه با فایلهای روی دیسک نشان داد که متنها در نقاط زیر قطع شدهاند:
- خط ۱۶۲ از ۳۲۵
- خط ۱۹۲ از ۳۵۵
- خط ۲۳۹ از ۳۹۵
از آنجا که تیم یک خلاصه «حیاتی» (Critical) را در خط ۱۰ قرار داده بود، مهمترین قوانین نجات یافتند. اما مراحل ضروری دیگر در پایین صفحه، مانند بخشهایی از رویه هفتگی، مگر در صورتی که عامل دوباره فایل را به صورت دستی باز میکرد، از دست میرفتند.
دادههای ادغام و اثرات آن
ادغام فایلها باعث افزایش چشمگیر حجم فایلهای اصلی شد. البته تیم اشاره کرد که ستون «بعد از ادغام» صرفاً جمع ساده دو فایل قبلی نیست، زیرا تاریخچهها حذف شدند و محتوا به صورت مراحل شمارهدار، قوانین، ورودیها، خروجیها و یک جدول خطا بازنویسی شد:
- weekly-ops: از ۱۸۰ (SKILL) و ۲۸۸ (ref) به ۳۲۰ خط رسید
- reach-tuning: از ۱۲۳ (SKILL) و ۱۵۹ (ref) به ۳۵۱ خط رسید
- respond-feedback: از ۱۵۸ (SKILL) و ۱۲۳ (ref) به ۳۶۱ خط رسید
- publish-product: از ۲۲۵ (SKILL) و ۱۱۴ (ref) به ۳۶۹ خط رسید
- incident-response: از ۹۰ (SKILL) و ۱۵۶ (ref) به ۲۲۵ خط رسید
سنجش تفکیک فایلها
برای سنجش دقیقتر، تیم ۲۰ تست روی یک مهارت کوچک اجرا کرد. در تمام ۱۶ مورد که SKILL.md صراحتاً به reference.md اشاره کرده بود، مدل فایل خارجی را خواند. اما در ۴ مورد که هیچ اشارهای وجود نداشت، مدل کاملاً فایل مرجع را نادیده گرفت. این تایید میکند که مدل هرگز بهطور «خودکار» فایلهای پشتیبان را چک نمیکند مگر اینکه صراحتاً به او گفته شود.
این وضعیت یک قمار خطرناک برای گردشکارهای پیچیده است. اشاره به یک فایل مرجع در خط ۳۰۰ یک رویه طولانی، ممکن است ساعتها بعد از شروع جلسه و بهخصوص پس از فشردهسازی متن، نادیده گرفته شود. هزینه ساختار تکفایلی، پرداخت هزینه توکنها در هر نوبت است، اما هزینه ساختار تفکیکشده، یک شکست خاموش است که در آن عامل بهسادگی مرحله ۱۴ را رد میکند. در واقع، هرگونه محدودیت در دسترسی مدل به دستورالعملها، حتی زمانی که توسط قلابهای PreToolUse برای ایجاد سد در برابر دستورات کاربر استفاده میشود، میتواند بر پیشبینیپذیری رفتار عامل اثر بگذارد.
برای توسعهدهندگان، این بدان معناست که توصیههای «صرفهجویی در توکن» در مستندات، ممکن است برای عاملهای خودکارِ حساس، یک تله باشد. اگر مرحلهای حیاتی است، باید در فایل اصلی باشد. تنها راه کاهش اثر قطعشدگی متن، قرار دادن مهمترین قوانین در ابتدای سند (Front-loading) است.
گام بعدی شما
- تمام دستورالعملهای حیاتی را از فایلهای مرجع خارج کرده و در ابتدای فایل SKILL.md قرار دهید.
- برای جلوگیری از نادیده گرفته شدن مراحل در جلسات طولانی، از ساختار «خلاصه حیاتی» در ۱۰ خط اول سند استفاده کنید.
- اگر مجبور به استفاده از فایلهای مجزا هستید، در هر مرحله حساس، صراحتاً از مدل بخواهید فایل مرجع را بازخوانی کند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو