تصور کنید با ۲۵۰ میلیارد رکورد سر و کار داشته باشید؛ در این مقیاس، صرفهجویی در تنها یک بایت برای هر ورودی، به معنای بازپسگیری ۲۵۰ گیگابایت حافظه است. کلودفلر (Cloudflare) با بازنگری در نحوهٔ ذخیرهسازی دادهها در سرویس ۱.۱.۱.۱، توانست بین ۱۸ مه تا ۶ ژوئیه ۲۰۲۶، حدود ۱۰۰ ترابایت رم را در کل شبکهٔ خود آزاد کند.
مدیریت DNS در این ابعاد نیازمند بهرهوری حداکثری است. سامانهای که با نام بیگ پایناپل (Big Pineapple) شناخته میشود، حجم عظیمی از پرسوجوها را پردازش میکند و حتی یک سربار کوچک در ساختارهای داده، منجر به هزینههای سختافزاری هنگفت میشود. این سامانه نهتنها هستهٔ ۱.۱.۱.۱، بلکه سرویسهای Gateway DNS و DNS Firewall و همچنین AS112 را تغذیه میکند. طبق اعلام کلودفلر، این بهینهسازی معادل کل حافظهٔ رم ۱۳۰ سرور نسل ۱۳ این شرکت است.
بسیاری از سرویسهای DNS با یک موازنهٔ دشوار میان فضای حافظه و سرعت جستوجو دستوپنجه نرم میکنند. اما رویکرد کلودفلر ثابت کرد که کاهش ردپای حافظه میتواند سیستم را سریعتر کند. به گزارش وبلاگ رسمی cloudflare.com، این تیم توانست همزمان با کاهش مصرف رم، تأخیر جستوجو را ۱۹٪ کاهش دهد. این رویکرد بهینهسازی لایههای حافظه برای کاهش تأخیر، مشابه راهکارهایی است که در پیادهسازی حافظهٔ دو لایه برای کاهش تأخیر عاملهای هوش مصنوعی مشاهده شده است.
زمینه: حافظهٔ پنهان بیگ پایناپل
در حالت راهاندازی سرد (Cold Start) — شبیه به روشن کردن کامپیوتری که هیچ برنامهای در حافظهٔ موقتش نیست — بیگ پایناپل با یک حافظهٔ پنهان خالی شروع به کار میکند. با رسیدن پرسوجوها، حافظه پر میشود تا زمانی که به سقف مجاز تعداد ورودیها برسد. در این نقطه، سیستم برای باز کردن فضا، قدیمیترین یا کمطرفدارترین دادهها را حذف (Evict) میکند تا جای دادههای جدید باز شود.
اندازهٔ این حافظه در هر مرکز داده متفاوت است. در مناطقی که از EDNS Client Subnet (ECS) به شدت استفاده میشود، سرورهای Authoritative پاسخهای متفاوتی را بر اساس شبکهٔ کاربر بازمیگردانند. این یعنی بیگ پایناپل باید نسخههای متعددی از یک پرسوجوی واحد را ذخیره کند که هم تعداد کل ورودیها و هم حافظهٔ مصرفی هر یک را افزایش میدهد.
هر آیتم در این حافظه یک جفت «کلید-مقدار» است. کلید توسط یک ساختار CacheKey تعریف میشود که شامل qname (نام)، qtype (نوع رکورد)، یک مقدار بولی برای authenticated و یک تگ (Vec<u8>) است. مقدار نیز یک ساختار CacheEntry است که پاسخ DNS — شامل بخشهای Answer، Authority و Additional — را به همراه متادادههایی مانند برچسب زمانی یونیکس (Unix timestamp)، زمان شروع (Inception time)، مقدار TTL و یک شمارندهٔ بازدید (Hit counter) ذخیره میکند.
بنچمارک ردپای حافظه
کلودفلر برای اندازهگیری اثر تغییرات، از یک تخصیصکنندهٔ سفارشی (Custom Allocator) استفاده کرد که تخصیصکنندهٔ سیستم در زبان رستم (Rust) را در بر میگرفت تا تعداد و اندازهٔ تخصیصها را به ازای هر ورودی ردیابی کند. آنها حافظه را با ورودیهای تولید شده به صورت تصادفی که با توزیع ترافیک واقعی تولید تطابق داشت، پر کردند:
- ۵۶٪ رکوردهای A
- ۲۵٪ رکوردهای AAAA
- ۱۹٪ رکوردهای TXT (که به عنوان جایگزینی برای تمام انواع غیر A/AAAA استفاده شد)
هر ورودی بین یک تا چهار رکورد داشت. اندازهٔ رکوردهای TXT برای شبیهسازی میانگین پاسخها برای انواع با طول متغیر، بین ۶۴ تا ۲۲۴ بایت به صورت تصادفی انتخاب شد. اگرچه این بنچمارکها تقریبی بودند، اما تیم مهندسی برای در نظر گرفتن ترکیب ترافیک، وضعیت تخصیصکننده و حافظهٔ مصرفی خارج از کش، میزان حافظهٔ مقیم (Resident Memory) را در نمونههای عملیاتی حین استقرار نیز اندازهگیری کرد.
حذف سربار ظرفیت
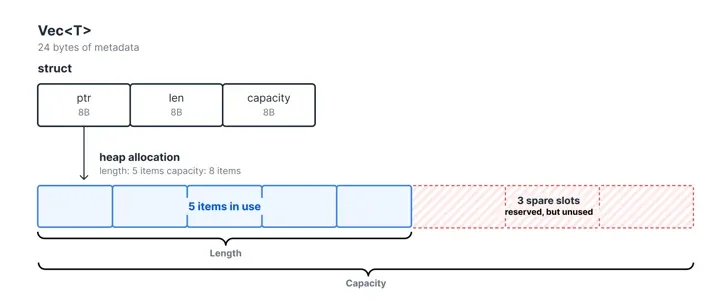
اولین پیروزی بزرگ، جایگزینی Vec<T> و String با Box<[T]> و Box<str> بود. در زبان رستم، یک Vec سه فیلد را ذخیره میکند: یک اشارهگر به دادههای تخصیصیافته در Heap، طول فعلی و ظرفیت کل.
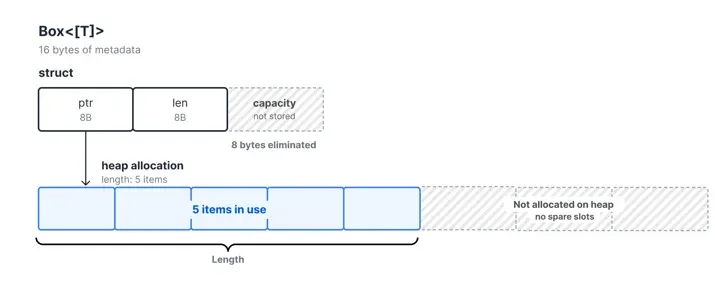
وقتی دادهای به Vec اضافه میشود، سیستم بررسی میکند که آیا طول از ظرفیت بیشتر شده یا خیر و در صورت نیاز، حافظه را مجدداً تخصیص میدهد. اما پاسخهای DNS پس از ذخیره در حافظه، هرگز تغییر نمیکنند؛ بنابراین فیلد ۸ بایتی «ظرفیت» کاملاً بیاستفاده است. علاوه بر این، فضای Heap که بیش از حد تخصیص یافته (Over-allocated) هدر میرود؛ برای مثال، یک Vec با ظرفیت ۸ آیتم که تنها ۵ آیتم در آن ذخیره شده، سه جای خالی بلااستفاده در Heap باقی میگذارد.
با تغییر به Boxed Slices، فیلد ظرفیت و فضای رزرو شده حذف شدند. با وجود هشت مورد از این فیلدها در هر ورودی، کلودفلر ۶۴ بایت در هر رکورد صرفهجویی کرد که در مقیاس ۲۵۰ میلیارد ورودی، به بیش از ۱۵ ترابایت رم رسید.
تخت کردن ساختارهای داده
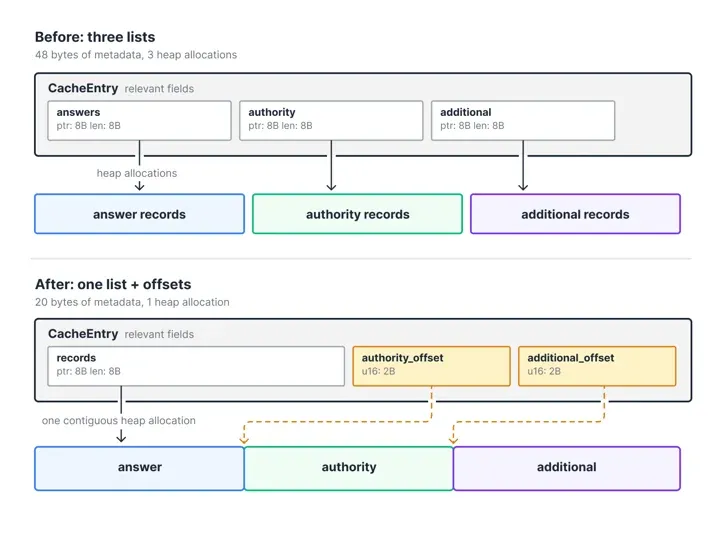
کلودفلر پیش از این، بخشهای پاسخ (Answer)، اعتبار (Authority) و رکوردهای اضافی (Additional) را در لیستهای مجزا ذخیره میکرد که هر کدام به اشارهگر و متادادههای طول ۸ بایتی نیاز داشتند.
تیم مهندسی اینها را در یک لیست واحد با استفاده از آفستهای ۲ بایتی (u16) بهجای اشارهگرهای ۸ بایتی و طولهای ۸ بایتی ادغام کرد. از آنجا که تعداد رکوردهای DNS در هر بخش در یک u16 جای میگیرد، این تغییر ۲۸ بایت در هر ورودی ذخیره کرد. این تلاش برای بهینهسازی ساختار دادهها جهت افزایش بازدهی، یادآور مقایسهای است که در بررسی DuckDB در برابر SQLite برای افزایش ظرفیت خواندن دادهها صورت گرفت.
آنها همچنین مشکل تراز کردن (Alignment) و Padding را حل کردند. رستم برای برآورده کردن الزامات تراز، Padding اضافه میکند و اندازهٔ ساختارها را به مضرب تراز آنها گرد میکند. با بستهبندی چندین فیلد بولی در یک بیتفلگ (Bitflag) واحد، تیم مهندسی Padding اطراف را کاهش داد و باعث شد ساختار حتی بیشتر از اندازهٔ خودِ مقادیر بولی کوچک شود.
بهینهسازی مالکیت رکوردها
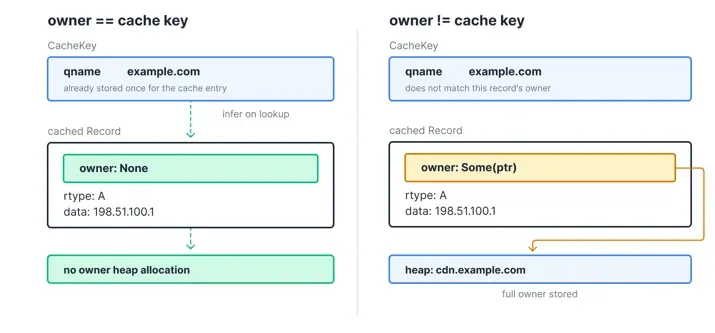
اکثر رکوردهای DNS مالک یکسانی با دامنهٔ مورد پرسوجو دارند. برای مثال، یک پرسوجو برای example.com A معمولاً رکوردهایی را برمیگرداند که مالک آنها example.com است. پیش از این، سیستم نام کامل مالک را برای تکتک رکوردها ذخیره میکرد.
اگرچه فرمت Wire در DNS (طبق RFC 1035) از فشردهسازی نام برای جلوگیری از تکرار دامنهها استفاده میکند، اما دنبال کردن این اشارهگرها در حین جستوجوی کش برای مسیرهای حساس (Hot Path) بسیار هزینهبر است. کلودفلر در ابتدا برای به دست آوردن سرعت، حافظه را فدا کرده و نامهای کامل را ذخیره میکرد.
برای بهینهسازی این مورد، تیم ساختار Record را تغییر داد تا از Option<Box<Name>> برای مالک استفاده کند:
- وقتی مالک
Noneاست: سیستم در زمان خواندن، مالک را از کلید کش استنباط میکند و از تخصیص حافظه در Heap اجتناب میکند. - وقتی مالک
Someاست (مثلاً رکوردهای A پشت یک CNAME): سیستم یک اشارهگر به نام کامل در Heap ذخیره میکند.
از آنجا که اکثریت رکوردها مالکی یکسان با دامنهٔ مورد پرسوجو دارند، این تغییر تخصیصهای Heap را برای اکثر رکوردها حذف کرد.
حل مشکل اندازهٔ Enum
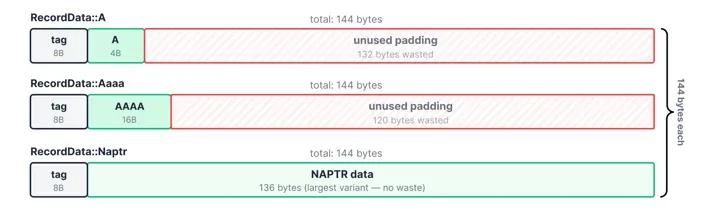
در رستم، Enumها از نوع Sum Types هستند، به این معنی که هر Variant به اندازهٔ بزرگترین Variant است. برای دادههای رکورد، کلودفلر از یک Enum به نام RecordData استفاده میکرد. بزرگترین Variant، رکورد NAPTR با ۱۳۶ بایت بود. با احتساب تگ Variant و Padding، اندازهٔ کل Enum به ۱۴۴ بایت میرسید.
این موضوع باعث اتلاف عظیمی میشد: یک رکورد A تنها به ۴ بایت و یک رکورد AAAA به ۱۶ بایت نیاز دارد. چون رکوردهای A و AAAA بیش از ۸۰٪ ترافیک را تشکیل میدهند، اکثر رکوردها بیش از ۱۲۰ بایت فضای خالی (Padding) هدر میدادند.
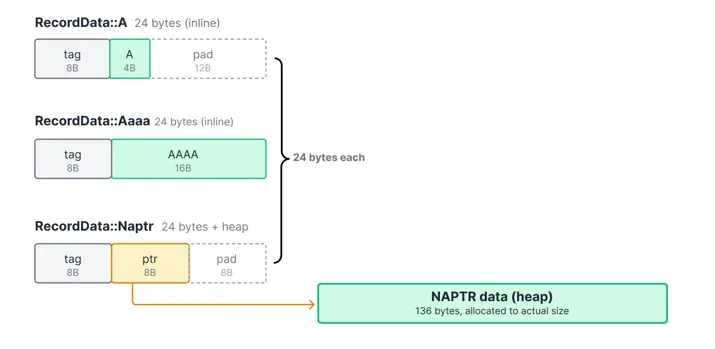
برای رفع این مشکل، کلودفلر Variantهای بزرگتر و نادرتر را «باکس» کرد. Enum جدید RecordData Variantهای کوچک و رایج (A, AAAA) را بهصورت Inline ذخیره میکند، در حالی که Variantهای بزرگ (TXT, NAPTR, SVCB) بهصورت یک اشارهگر ۸ بایتی به Heap ذخیره میشوند. این کار ۱۲۰ بایت در هر رکورد برای رایجترین ترافیکها ذخیره کرد. اگرچه رکوردهای NAPTR اکنون به دلیل سربار تخصیص، جریمهٔ کوچکی میپردازند، اما نادرت بودن آنها این موازنه را ارزشمند میکند.
هزینههای باکس کردن
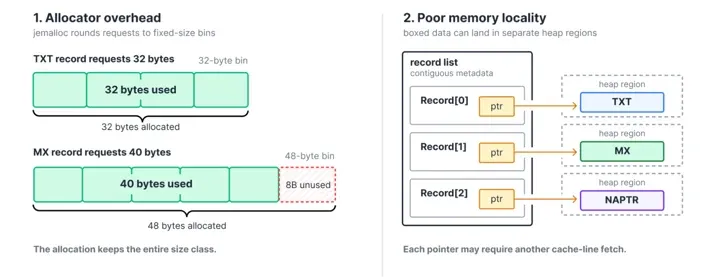
باکس کردن دو مشکل جدید ایجاد کرد. اول، سربار تخصیصکننده بود. بیگ پایناپل از jemalloc استفاده میکند که تخصیصها را در Binهایی با اندازهٔ ثابت گروهبندی میکند. اگر یک رکورد TXT درخواست ۳۲ بایت کند، دقیقاً جای میگیرد؛ اما یک رکورد MX که ۴۰ بایت درخواست میکند، به ۴۸ بایت گرد میشود و ۸ بایت هدر میرود.
دوم، کاهش موضعیّت حافظه (Memory Locality) بود. بدون باکسینگ، مقادیر Enum رکورد در یک تخصیص پیوسته قرار دارند. با باکسینگ، دادهها در سراسر Heap پخش میشوند. خواندن یک Variant باکسشده نیازمند دنبال کردن یک اشارهگر است که اغلب CPU را مجبور میکند یک Cache Line جدید را فراخوانی کند و این امر تأخیر را افزایش میدهد.
انتقال به فرمت Wire
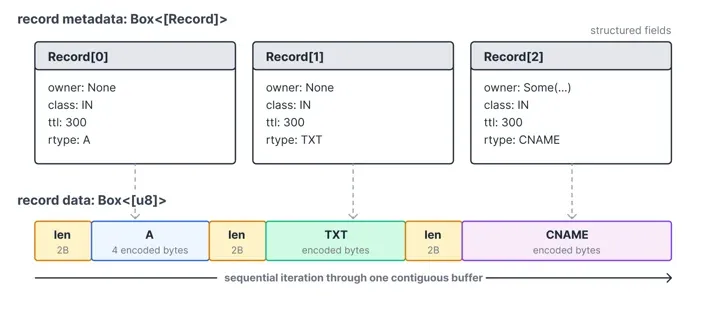
برای حذف سربار باکسینگ، کلودفلر به ذخیرهسازی دادههای رکورد بهصورت بایتهای خام در یک Box<[u8]> واحد با پیشوندهای طول ۲ بایتی منتقل شد.
این چیدمان چندین مزیت دارد:
- دادههای پیوسته: بهبود موضعیت کش CPU با متراکم کردن رکوردها در کنار هم.
- کپی مستقیم: برای رکوردهای A، AAAA، TXT و DNSSEC، سیستم اکنون بایتهای کدگذاریشده را مستقیماً در پیام خروجی کپی میکند و فرآیند سریالسازی فیلد-به-فیلد را حذف میکند.
- کاهش تجزیه (Parsing): تنها رکوردهایی که حاوی نام دامنه هستند (CNAME, NS, MX, SOA) همچنان برای اعمال فشردهسازی نام DNS نیاز به تجزیه دارند.
برای بهینهسازی بیشتر، تیم یک بافر فضای پیشنویس (Scratchspace) قابل استفاده مجدد برای درجها پیادهسازی کرد. این بافر در طول درجها باقی میماند و بهندرت نیاز به تخصیص مجدد دارد. پس از اینکه رکوردها در Scratchspace سریالسازی شدند، از طریق memcpy در یک Box<[u8]> کپی میشوند. این کار چندین تخصیص رکورد باکسشده را با یک تخصیص واحد جایگزین کرده و از اتلاف ناشی از کوچک کردن Vec<u8> جلوگیری میکند. این تغییر بهتنهایی توان عملیاتی درج در کش را ۱۳٪ افزایش داد.
نتایج عملیاتی
استقرار این تغییرات در مراحل مختلف بین ۱۸ مه تا ۶ ژوئیه ۲۰۲۶ انجام شد. اندازهگیریهای عملیاتی نشان داد که مصرف حافظه در سطح p99 از ۹.۳ گیگابایت به ۵.۳ گیگابایت در هر نمونه کاهش یافت — یک کاهش ۴۳ درصدی.
در سطح p90، مصرف حافظه از ۶.۵ گیگابایت به ۳.۸ گیگابایت رسید (۴۲٪ کاهش). قابلتوجهترین صرفهجوییها در نمونههایی با کشهای پرتر و در مراکز دادهای با ترافیک بالای EDNS Client Subnet (ECS) مشاهده شد.
نتایج نهایی بنچمارک نشان میدهد ردپای خالص هر ورودی از ۹۵۳ بایت به ۴۲۰ بایت کاهش یافت. این کاهش ۵۶ درصدی در اندازه، مستقیماً به ۱۰۰ ترابایت حافظهٔ آزاد شده در کل شبکه تبدیل شد.
| معیار | قبل | بعد | تغییر |
|---|---|---|---|
| ردپای خالص هر ورودی | ۹۵۳ بایت | ۴۲۰ بایت | ۵۶٪- |
| تخصیصها در هر ورودی | ۱.۱ کیلوبایت | ۴۶۱ بایت | ۵۸٪- |
| توان عملیاتی درج | ۶۲۵,۰۰۰ ورودی/ثانیه | ۸۹۳,۰۰۰ ورودی/ثانیه | ۴۳٪+ |
| تأخیر جستوجو | ۸۲۸ نانوثانیه | ۶۷۰ نانوثانیه | ۱۹٪- |
این تغییر، فرض بنیادین مبنی بر اینکه بهرهوری حافظه مستلزم فدا کردن سرعت است را تغییر میدهد. با تمرکز بر موضعیت حافظه و کاهش فشار بر تخصیصکننده، کلودفلر هم توان عملیاتی و هم تأخیر را بهبود بخشید.
برای توسعهدهندگانی که در مقیاس بزرگ با رستم کار میکنند، این مورد یک کلاس درس در تراز کردن ساختارهای داده و هزینههای پنهان کانتینرهای عمومی است. ثابت شد در مقیاس میلیاردها ورودی، انتخاب بین Vec و Box یک تصمیم در سطح سختافزار است.
کلودفلر اکنون قصد دارد از این حافظهٔ آزاد شده برای افزایش ظرفیت کل حافظهٔ پنهان استفاده کند. این اقدام احتمالاً نرخ Hit کش را بهبود بخشیده و حجم پرسوجوهای ارسالی به سرورهای Authoritative بالادستی را کاهش میدهد.



گفتگو