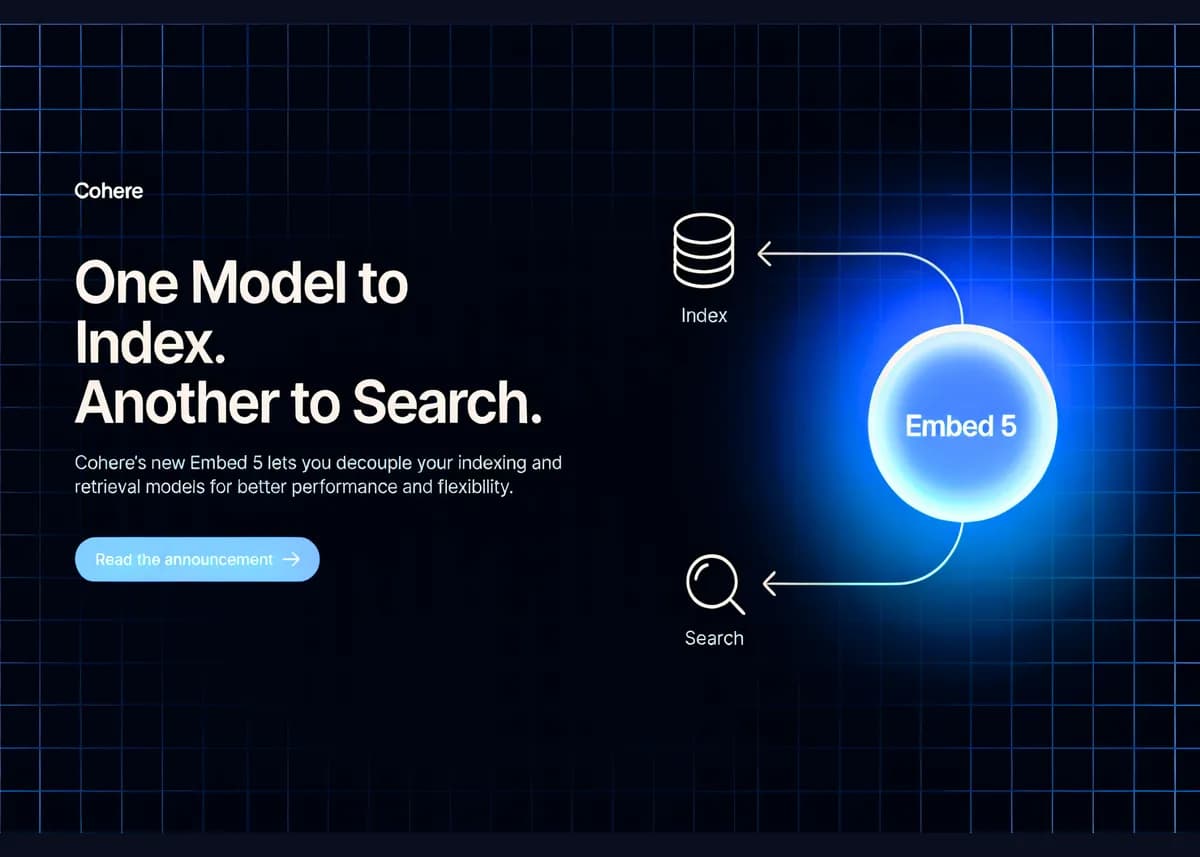
دقت بازیابی دادهها در هوش مصنوعی سازمانی با معرفی کوهیر امبد ۵ (Cohere Embed 5) در ۳۰ سپتامبر ۲۰۲۶ وارد مرحلهای جدید شد. این خانواده جدید از مدلها به توسعهدهندگان اجازه میدهد تا مجموعهدادههای عظیم را با بردارهای بسیار دقیق فهرستبندی کنند و سپس برای پرسوجو از مدلهایی با تأخیر کم استفاده کنند، بدون آنکه نیاز باشد کل بدنه دادههای خود را دوباره فهرستبندی (Re-index) کنند.
این بهروزرسانی در حالی رخ میدهد که سازمانها از سیستمهای سادهی تولید بازیابیافزا (RAG) به سمت گردشکارهای پیچیدهتر و عاملمحور (Agentic) حرکت میکنند. همانطور که در تحلیل قبلی ما دربارهی اتوماسیون تحلیل احساسات با مدلهای جمینای از طریق ابزارهایی مانند n8n اشاره کردیم، گلوگاه اصلی این عاملها معمولاً تأخیر انباشتهشده از دهها جستوجوی متوالی است. این چالش با تلاشهای گستردهتر در صنعت برای کاهش هزینهها و زمان استنتاج در عاملهای هوش مصنوعی همسو است. کوهیر با جداسازی فرآیند فهرستبندی از مسیر پرسوجو، مستقیماً به این چالش پاسخ داده است.
دو سطح، یک فضای برداری
خانواده Embed 5 در دو نسخهی متمایز Embed 5 Pro و Embed 5 Fast عرضه شده است. دستاورد معماری کلیدی و حیاتی این است که هر دو سطح از یک فضای بردار معنایی (Embedding Space) مشترک استفاده میکنند. این به معنای آن است که شما میتوانید برای ایجاد فهرست (Index) خود از مدل Pro برای دستیابی به حداکثر کیفیت استفاده کنید و سپس برای پاسخ به پرسوجوهای زنده کاربران، مدل Fast را به کار بگیرید تا هزینه و تأخیر به حداقل برسد.
طبق مستندات فنی کوهیر، فهرستی که با مدل Pro ساخته شده و توسط مدل Fast پرسوجو میشود، ۹۸.۴٪ از کیفیت یک ساختار تمام-Pro (یعنی Pro-on-Pro) را حفظ میکند. این قابلیت بهطور خاص برای بارهای کاری عاملمحور طراحی شده است، جایی که سرعت پرسوجو محدودیت اصلی است. در مقابل، یک ساختار تمام-Fast نمره ۹۶.۶ را (زمانی که نسبت به معیار ۱۰۰ برای Pro-on-Pro نرمالسازی شد) کسب کرد. کوهیر برای تأیید این نتایج، تمامی جفتهای بدنه و پرسوجو را در ۴۰ مجموعه داده توسعه آزمایش کرده است تا از صحت این اعداد اطمینان حاصل کند.
جزئیات استقرار و API
هر دو سطح مدل هماکنون بهصورت عمومی در دسترس هستند. توسعهدهندگان میتوانند از طریق Cohere API، Model Vault، Microsoft Foundry و Amazon SageMaker به آنها دسترسی داشته باشند. برای سازمانهایی که به زیرساخت خصوصی نیاز دارند، امکان سرویسدهی از طریق vLLM در محیطهای VPC خصوصی یا محیطهای درونسازمانی (On-premise) فراهم است.
جزئیات فنی پیادهسازی عبارت است از:
- شناسه مدلها: API از شناسههای
embed-v5.0-proوembed-v5.0-fastاز طریق اندپوینت v2 Embed استفاده میکند. - ابعاد خروجی: هر دو مدل از ابعاد ۲۰۴۸، ۱۵۳۶، ۱۰۲۴، ۷۶۸، ۵۱۲ یا ۲۵۶ پشتیبانی میکنند. مقدار پیشفرض ۲۰۴۸ است.
- فرمتهای خروجی: بردارها به صورت float، int8 یا binary بازگردانده میشوند.
- دستهبندی: API برای مدیریت جذب دادهها در مقیاس بزرگ، از عملیات Batch Embed پشتیبانی میکند.
عملکرد و محکها
بر اساس گزارشهای منتشر شده، Embed 5 Pro در محک ViDoRe V3 به میانگین ۸۵.۸ رسید که نشاندهنده ۸.۸ امتیاز رشد نسبت به Embed 4 است. این عدد مدل کوهیر را در جایگاه برتر نسبت به چندین پیشرو در صنعت قرار میدهد:
- Embed 5 Pro: ۸۵.۸
- Embed 5 Fast: ۸۴.۵
- Voyage 4 Large: ۸۳.۷
- Gemini Embedding 2: ۸۳.۲
- OpenAI text-embedding-3-large: ۷۵.۵
کوهیر تسلط ویژهای در بخش مالی نشان داده است. مدل Pro در محکهای FinanceBench (۸۰.۱)، FinQA (۹۰.۰) و ViDoRe V3 Finance (۸۵.۰) رتبه اول را دارد و مدل Fast در هر سه مورد از این محکهای مالی رتبه دوم را کسب کرده است.
با این حال، شرکت اشاره کرد که نتایج در عملکرد چندزبانه متغیر است. در حالی که Pro در میانگین زبانهای اروپایی با نمره ۷۷ پیشتاز است، Gemini Embedding 2 در ۹ زبان از ۱۰ زبان دیگر، از جمله ژاپنی، عربی، هندی و تلوگو، عملکرد بهتری داشت. با این وجود، هر دو سطح Embed 5 در مجموع بیش از ۱۰۰ زبان را پوشش میدهند.
قابلیتهای چندوجهی و زمینه
برخلاف بسیاری از مدلهای برداری که فقط متنی هستند، هر دو سطح Embed 5 ورودیهای متنی، تصویری و ترکیبی (متن + تصویر) را میپذیرند. این یعنی مدل میتواند تصویر یک صفحه را مستقیماً بردارسازی کند یا یک تصویر را با متادیتای آن در یک بردار واحد ادغام (Fuse) کند.
این قابلیت برای اسنادی که نویسهخوانی نوری (OCR) سنتی در آنها شکست میخورد — مانند نمودارهای پیچیده، اسلایدهای ارائه و چارتها — حیاتی است. با ادغام تصاویر و متادیتا، مدل اطلاعاتی را حفظ میکند که معمولاً در طول فرآیند استخراج متن از دست میروند.
مقایسه پنجره زمینه
این مدلها از یک پنجره زمینه (Context Window) عظیم ۱۲۸ هزار توکنی (دقیقاً ۱۳۱,۰۷۲ توکن) پشتیبانی میکنند. این ویژگی باعث میشود هنگام پردازش دفترچههای راهنمای طولانی یا گزارشهای مالی، نیاز به تکهبندی (Chunking) کمتری باشد. شکاف با رقبا در این بخش بسیار چشمگیر است:
- Cohere Embed 5 (Pro/Fast): ۱۲۸,۰۰۰ توکن
- Voyage 4 Large: ۳۲,۰۰۰ توکن
- Gemini Embedding 2: ۸,۱۹۲ توکن
- OpenAI text-embedding-3-large: ۸,۱۹۱ توکن
بهینهسازی ذخیرهسازی با یادگیری ماتروشکا
برای حل مشکل هزینههای ذخیرهسازی در مقیاس بالا، کوهیر از یادگیری نمایش ماتروشکا (Matryoshka representation learning) استفاده کرده است. این تکنیک به کاربران اجازه میدهد ابعاد بردار را بدون سقوط کامل کیفیت، کوتاه (Truncate) کنند.
برای یک بدنه ۱۰۰ میلیون تکهای، نیاز به فضای ذخیرهسازی بر اساس دقت و ابعاد انتخابی به شدت کاهش مییابد:
- Float32 (۲۰۴۸ بُعد): ۸ کیلوبایت برای هر بردار (۸۱۹ گیگابایت کل)
- Int8 (۱۰۲۴ بُعد): ۱ کیلوبایت برای هر بردار (۱۰۰ گیگابایت کل)
- Binary (۲۵۶ بُعد): ۳۲ بایت برای هر بردار (۳.۲ گیگابایت کل)
کوهیر پیکربندی int8 با ۱۰۲۴ بُعد را به عنوان «نقطه بهینه» (Sweet Spot) برای حفظ کیفیتی نزدیک به دقت کامل در عین کاهش هزینهها توصیه میکند. بردارهای باینری نیز برای جستوجوی اولیه (First-pass) پیش از مرحله نهایی بازرتبهبندی (Reranking) پیشنهاد میشوند.
قیمتگذاری و توان عملیاتی
قیمتها بر اساس سرعت مدل تنظیم شدهاند تا با مراحل مختلف خط لوله RAG سازگار باشند:
- Embed 5 Pro: ۰.۱۲ دلار به ازای هر ۱ میلیون توکن متنی.
- Embed 5 Fast: ۰.۰۸ دلار به ازای هر ۱ میلیون توکن متنی.
- ورودیهای تصویری: ۰.۴۰ دلار به ازای هر ۱ میلیون توکن برای هر دو سطح.
این کاهش هزینه با جهشی در سرعت همراه است. طبق اعلام کوهیر، مدل Fast در هر ثانیه ۳۷۷.۳ سند را پردازش میکند، در حالی که این عدد برای مدل Pro برابر با ۱۵۹.۷ سند است؛ این یعنی توان عملیاتی مدل Fast تقریباً ۲.۴ برابر بیشتر از سطح Pro است.
تحلیل فنی
برای جامعه یادگیری ماشین، مهمترین تغییر در اینجا حرکت به سمت «بازیابی نامتقارن» (Asymmetric Retrieval) است. کوهیر با اثبات اینکه یک مدل کوچکتر و سریعتر میتواند با کمترین افت کیفیت از یک فهرست با دقت بالا پرسوجو کند، این فرض را به چالش میکشد که باید از یک مدل واحد برای هر دو طرف خط لوله RAG استفاده کرد. تنها شرط سخت برای این الگو این است که هر دو مدل فهرستبندی و پرسوجو باید از ابعاد خروجی یکسانی استفاده کنند.
البته یک نکته درباره بنچمارکها وجود دارد. کوهیر از معیار جدیدی به نام RCP-nDCG@10 استفاده کرده که مجموعهای ثابت از کاندیدها را بازرتبهبندی میکند. این یعنی این عدد بیشتر کیفیت بازرتبهبندی را میسنجد تا نرخ بازیابی (Recall) در مرحله اول. تا زمانی که بازتولید مستقل این اعداد صورت نگیرد — هرچند کوهیر کد ارزیابی را منتشر کرده است — صنعت باید اینها را به عنوان اعداد گزارششده توسط سازنده ببیند.
توسعهدهندگان باید اکنون ارزیابی کنند که آیا هزینههای فعلی آنها توسط فهرستبندی یا پرسوجو هدایت میشود. اگر دومی اولویت دارد، الگوی «فهرست Pro / پرسوجوی Fast» مسیری روشن برای کاهش تأخیر بدون قربانی کردن کیفیت مبنیسازی (Grounding) پایگاه دانش است.
منتظر بازتولید مستقل معیار RCP-nDCG@10 توسط جامعه باشیم تا ببینیم آیا برتری نسبت به Gemini و Voyage در محیطهای واقعی و غیرسازندهای نیز حفظ میشود یا خیر.
گام بعدی شما
- اگر از مدلهای OpenAI یا Gemini برای RAG استفاده میکنید، هزینه و تأخیر مدل Fast کوهیر را با ابعاد ۱۰۲۴-int8 تست کنید.
- برای اسنادی که دارای نمودار و جدول هستند، قابلیت ادغام تصویر و متن Embed 5 را جایگزین OCRهای سنتی کنید.
- در صورت استفاده از vLLM، مدلهای جدید را در محیط VPC خود مستقر کنید تا حریم خصوصی دادههای سازمانی حفظ شود.
اما تأثیر این مدلها بر کاهش هزینههای زیرساختی در مقیاس پتابایت حتی شگفتانگیزتر است — به تحلیل ما درباره بهینهسازیهای حافظه در مدلهای زبانی مراجعه کنید.



گفتگو