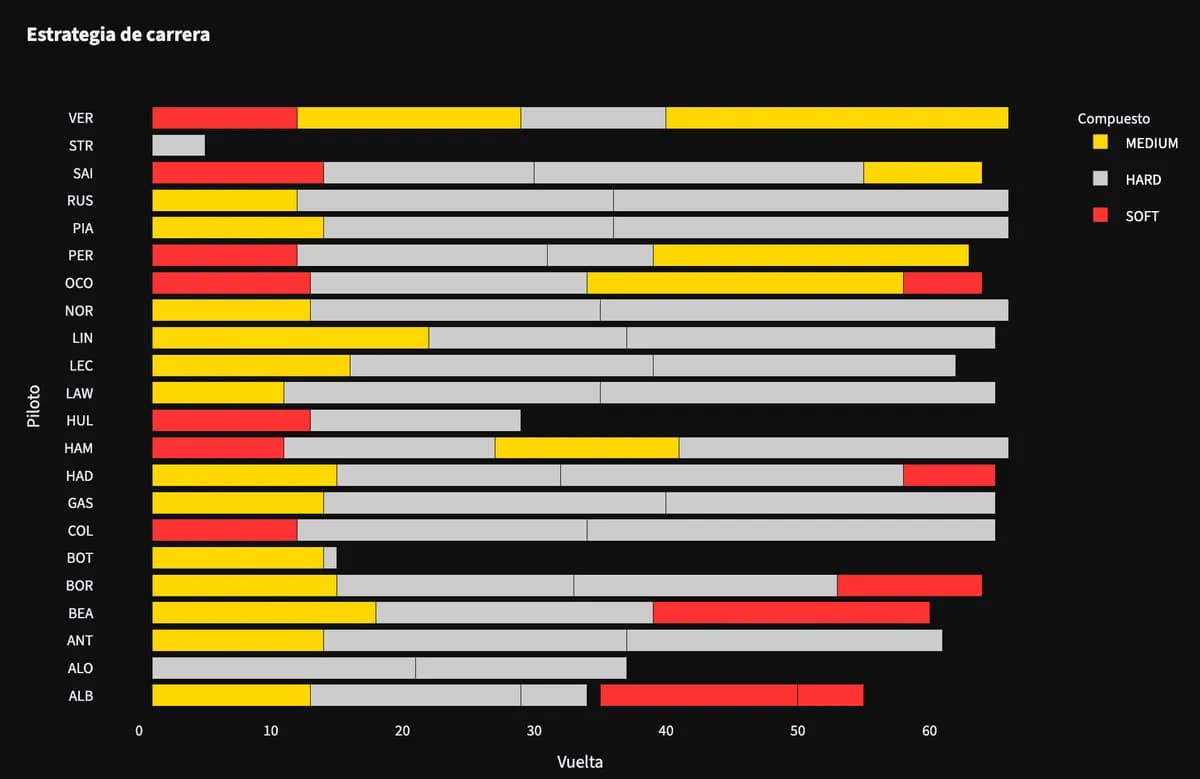
تصور کنید برای هر سؤال ساده درباره یک مسابقه، مجبور باشید کل دفترچه یادداشتهای فنی یک آخر هفته را به مدل بدهید؛ این یعنی پرداخت هزینهای گزاف برای اطلاعاتی که مدل شاید هرگز به آنها نگاه نکند. این دقیقاً همان نقطهای است که F1 Analyst Pro، یک تحلیلگر تخصصی تلهمتری، با تغییر بازی در لایه بازیابی، موفق شده است مصرف توکنهای ورودی را برای پرسوجوهای خاص تا ۱۵ برابر کاهش دهد. این موفقیت از طریق جایگزینی «دامپهای انبوه زمینه» (Bulk Context Dumps) با «بازیابی مبتنی بر قصد» (Intent-based Retrieval) به دست آمده است.
طبق تحلیلهای فنی منتشرشده، این سامانه بهجای استفاده از «رویکرد سادهلوحانه» — یعنی ریختن تمام دادههای موجود از مسابقه در پنجره زمینه (Context Window) — از یک سیستم هوشمند برای فیلتر کردن دادهها استفاده میکند. در حالت سنتی و ساده، هر پرسوجو با مدل Claude Sonnet (با نرخ ۳ دلار به ازای هر یک میلیون توکن ورودی)، حدود ۰.۰۲۴ تا ۰.۰۳۶ دلار هزینه داشت، زیرا حجم عظیمی از دادههای تکراری و غیرضروری ارسال میشد. این رویکرد در راستای تلاشهای گستردهتر برای بهینهسازی هزینههاست، مشابه آنچه در ۸ استراتژی فنی برای کاهش هزینههای API مدلهای زبانی بزرگ بررسی کردیم.
همانطور که در تحلیل قبلی ما دربارهی ابزارهایی مثل Modal Auto Endpoints که کنترل استنتاج را بهینه میکنند اشاره کردیم، این تغییر رویکرد بهجای تمرکز بر لایه زیرساخت (Infra Layer)، بر لایه بازیابی (Retrieval Layer) تمرکز دارد. اکثر توسعهدهندگان با تولید بازیابیافزا (RAG) برخورد میکنند که صرفاً یک خط لوله (Pipeline) ساده است: دادهها را بگیر، در پرامپت بریز و اجازه بده مدل زبانی (LLM) خودش آنها را مرتب کند. اما در محیطی با تراکم دادهای بالا مثل فرمول یک — جایی که یک آخر هفته شامل دادههای لپبهلپ برای ۲۲ راننده در چندین جلسه مختلف (FP1، FP2، FP3، تعیین خط یا Qualifying و مسابقه اصلی) است — این روش منجر به «تورم زمینه» یا Context Bloat میشود.
مشکل: تورم زمینه
هر جلسه مسابقاتی حاوی حجم عظیمی از دادههای ساختاریافته است؛ از جمله ترکیب تایرها، زمانهای لپ، جایگاهها، استینتها (Stints)، زمانهای بخشهای مختلف پیست (Sectors) and عمر تایرها. علاوه بر این، سیستم باید نتایج تعیین خط، نتایج مسابقه، خلاصههای استینت، تحلیل توقفهای پیتاستوپ، لحظات کلیدی، حوادث مسابقه و حتی یادداشتهای خبرنگاران را مدیریت کند.
اگر در هر پرسوجو یک دامپ کامل از زمینه ارسال شود، پنجره زمینه بهراحتی به ۸,۰۰۰ تا ۱۲,۰۰۰ توکن در هر سؤال میرسد. این وضعیت دو مشکل جدی و بنیادین ایجاد میکند:
- تصاعد مالی: وقتی هر پرسوجو در حداکثریترین طول خود باشد، هزینهها برای یک پایگاه کاربر بزرگ، به شدت دردناک و غیرقابلتحمل میشود.
- افت کیفیت پاسخ: مدلهای زبانی وقتی زمینه حاوی اطلاعات نامرتبط باشد، عملکرد ضعیفتری دارند. برای مثال، گنجاندن خلاصهی استینتهای مسابقه اصلی در سؤالی که درباره «تعیین خط» است، نویزی ایجاد میکند که مدل را از دادهی هدف منحرف کرده و دقت پاسخ را کاهش میدهد.
الگوی اول: زمینه مشروط از طریق تشخیص قصد
مکانیزم اول شامل یک لایهی تشخیص قصد (Intent Detection Layer) است که قبل از ارسال کوئری به پایگاهداده، پرامپت کاربر را رهگیری میکند. بهجای یک بازیابی کلی، سیستم از یک فرآیند نرمالسازی با استفاده از کتابخانه unicodedata استفاده میکند تا اکسنتها و علائم خاص را حذف کند (مثلاً تبدیل "clasificación" به "clasificacion")؛ این کار تضمین میکند که کلمات کلیدی صرفنظر از علائم دیاکریتیک زبان، شناسایی شوند.
تطبیق قصد (Intent Matching): سیستم خوشههای کلمات کلیدی خاص را برای دستهبندی درخواست بررسی میکند:
- تعیین خط (Qualifying): کلماتی مثل "clasificacion", "qualifying", "q1", "q2", "q3", "pole", "sector".
- مسابقه (Race): کلماتی مثل "carrera", "race", "resultado", "vuelta rapida", "stint", "degradacion".
- تلهمتری (Telemetry): کلماتی مثل "telemetria", "aceleracion", "frenada", "velocidad", "throttle", "brake".
- استراتژی/اندکات (Undercut/Strategy): کلماتی مثل "undercut", "overcut", "parada", "pit stop", "estrategia de pit".
- تمرینات (Practice): کلماتی مثل "entrenamiento", "practica", "fp1", "fp2", "fp3", "long run", "evolucion".
- شبیهساز مسابقه (Race Sim): کلماتی مثل "race simulation", "simulacion de carrera", "ritmo de fp2".
کوئریهای SQL هدفمند: هر قصد شناسایی شده، فراخوانیهای خاصی را در Supabase فعال میکند. برای مثال، اگر قصد
wants_qualyشناسایی شود، تابعget_qualifying_resultsاجرا میشود و اگرwants_raceشناسایی شود، خلاصههای استینت فراخوانی میگردند. بهطور خاص، تحلیلهای گرانقیمت مثل «حوادث مسابقه» و «لحظات کلیدی» تنها زمانی بازیابی میشوند که واقعاً مرتبط باشند.منطق جایگزین (Fallback Logic): تریگر "load_all" تنها در صورتی فعال میشود که هیچ قصد خاصی شناسایی نشود. این کار از صرف هزینهی توکنهای اضافی برای سؤالاتی که میتوانند هدفمند باشند، جلوگیری میکند.
بهعنوان مثال، یک سؤال درباره «پول پوزیشن» حالا بهجای یک دامپ ۶,۰۰۰ توکنی از کل آخر هفته، تنها حدود ۴۰۰ توکن دادهی مربوط به تعیین خط را فراخوانی میکند. این رویکرد جراحیگونه تضمین میکند که مدل فقط دادههای مورد نیاز برای پاسخ به آن سؤال خاص را ببیند.
الگوی دوم: پیشتولید برای بصریسازی
الگوی دوم به ناکارآمدی مدلهای زبانی در تولید کد برای بصریسازی دادهها میپردازد. بهطور سنتی، یک LLM یک قطعه کد Matplotlib یا Plotly مینویسد و سپس کلاینت آن را اجرا میکند. این روند ۵۰ تا ۱۵۰ خط کد به پنجره خروجی اضافه میکند که هم هزینهها را افزایش میدهد و هم ریسک توهم (Hallucination) — یعنی تولید اطلاعات نادرست یا کد اشتباه — و همچنین ریسک فراخوانیهای API قدیمی یا شکستهای خاموش (Silent Failures) را بالا میبرد.
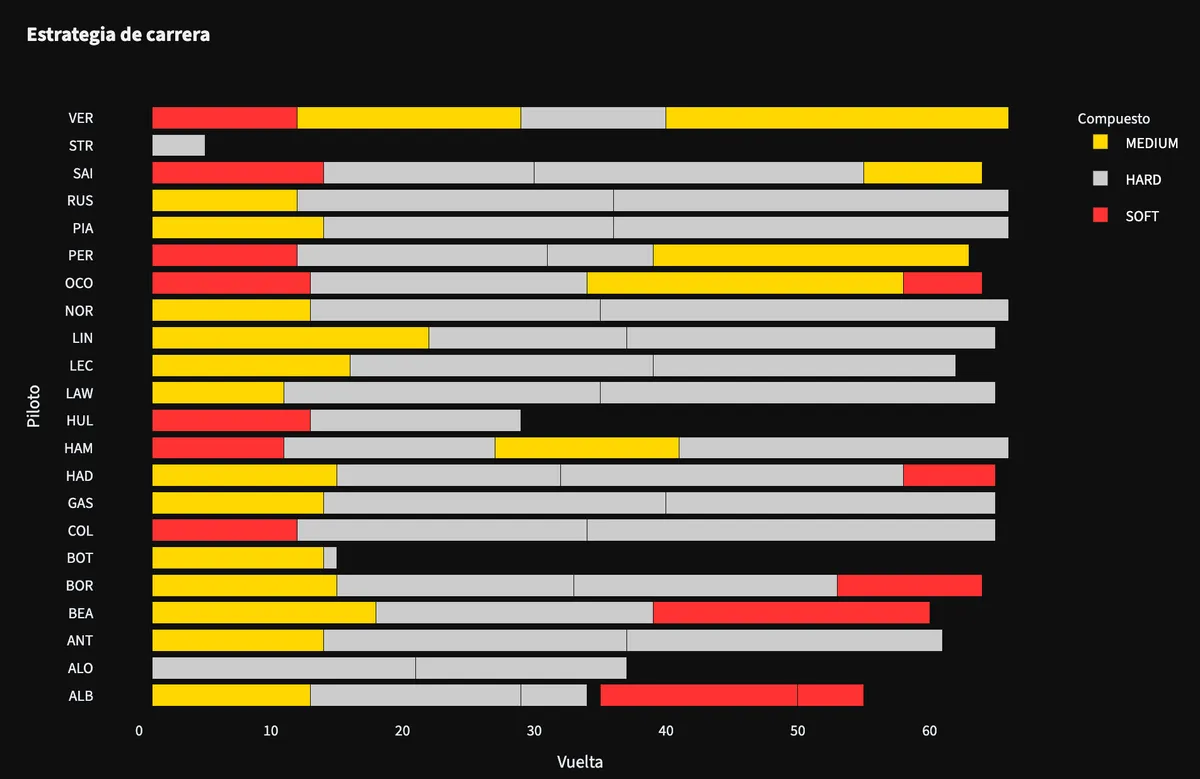
F1 Analyst Pro این منطق را کاملاً وارونه کرده است؛ به گونهای که نمودار را مستقیماً از پایگاهداده FastF1 پیش از اینکه اصلاً مدل زبانی فراخوانی شود، تولید میکند. این رویکرد پیشپردازشی یادآور تکنیکهای بهینهسازی در لایههای پایینتر است، مانند آنچه در پروژه SIFT برای افزایش سرعت پیشتولید RAG مشاهده شد. سیستم در متد send_message یک توالی سختگیرانه را دنبال میکند:
۱. تریگر نمودار: تشخیصدهنده قصد، درخواست wants_telemetry را شناسایی میکند.
۲. رسم مستقیم: بکاند از تابع plot_telemetry_trace استفاده میکند تا با دادههای واقعی، نمودار را رسم کند. در این مرحله، رانندگان، نوع جلسه و بخش تعیین خط (Q1-Q3) پیش از هرگونه تعامل با LLM شناسایی میشوند.
۳. اعلان سیستم: یک تگ مخفی به پرامپت تزریق میشود که به مدل میگوید: «[SYSTEM: یک نمودار تلهمتری برای مقایسه {drivers} در {session_type} تولید شده است. در تحلیل خود به آن ارجاع دهید و هیچ کدی تولید نکنید].»
این روش نیاز به نوشتن کد پایتون توسط مدل را حذف کرده و توکنهای خروجی برای پاسخهای نمودار-محور را ۷۵٪ کاهش داده است؛ یعنی از حدود ۸۰۰ توکن به ۲۰۰ توکن تحلیل خالص.
مدیریت دادههای قطعهبندیشده
پیادهسازی این سیستم بهویژه در مورد بخشهای تعیین خط (Q1، Q2 و Q3) بسیار دقیق است. از آنجایی که رانندگان در هر مرحله حذف میشوند، مقایسه رانندهای که در Q1 حذف شده با رانندهای که به Q3 رسیده است، از نظر منطقی بیمعناست. منطق پیشتولید این مسئله را با استفاده از یک جستوجوی regex ((q[123])) برای شناسایی بخش مورد نظر از روی متن کاربر حل میکند.
در داخل تابع plot_telemetry_trace سیستم از یک نقشهی استینت (Stint Map) استفاده میکند:
- Q1: متصل میشود به Stint 1
- Q2: متصل میشود به Stint 2
- Q3: متصل میشود به Stint 3
با فیلتر کردن دیتافریم drv_laps بر اساس استینت شناسایی شده، سیستم تضمین میکند که سریعترین لپ از همان بخش خاص استفاده شود. این کار مانع از آن میشود که مدل دچار خطای رایج «مقایسه لپهای اشتباه» شود و خروجی را بر اساس فیزیک واقعی مسابقه مستند میکند.
ترکیب الگوها
وقتی این دو الگو با هم ترکیب میشوند، یک پرسوجوی گرانقیمت به یک عملیاتی بسیار سبک تبدیل میشود. پرسوجوی «تلهمتری COL در برابر GAS در Q2 را نشان بده» را در نظر بگیرید:
- تشخیص قصد: مقادیر
wants_telemetry=Trueوwants_qualy=Trueرا تنظیم میکند. - ساخت زمینه: تنها نتایج تعیین خط را بازیابی میکند (حدود ۴۰۰ توکن).
- پیشتولید: یک نمودار تلهمتری فیلتر شده برای Q2 از FastF1 برای COL و GAS تولید میکند.
- فراخوانی API: زمینه تعیین خط + اعلان تولید نمودار را ارسال میکند (در مجموع حدود ۶۰۰ توکن ورودی).
- پاسخ: مدل به نمودار ارجاع داده و دادهها را تحلیل میکند (حدود ۲۰۰ توکن خروجی).
مجموع مصرف: حدود ۸۰۰ توکن. بدون این الگوها، همین پرسوجو به دلیل ارسال کامل زمینه و تولید کد نمودار، حدود ۷,۰۰۰ توکن هزینه داشت.
این متدولوژی بار انتخاب دادهها را از دوش قابلیتهای استدلالی LLM به منطق برنامه (Application Logic) منتقل میکند. در حالی که جستوجوی برداری (Vector Search) همچنان استاندارد طلایی برای PDFهای بدون ساختار است، این رویکرد مبتنی بر کلمات کلیدی و قصد، برای دادههای ساختاریافته و جدولی به مراتب کارآمدتر است. با انتقال منطق به مرحله پیشپردازش، توسعهدهندگان میتوانند برنامههای RAG خود را برای کاربران بیشتری مقیاسبندی کنند، بدون اینکه هزینه API بهصورت خطی با حجم دادهها افزایش یابد.
شما میتوانید پیادهسازی کامل این الگوها را در هستهی متنباز این پروژه — بهویژه در فایلهای core/consultant_agent.py و core/chart_builder.py — در گیتهاب به آدرس github.com/luc45hn/f1-analyst-pro بررسی کنید.
گام بعدی شما
- اگر از RAG برای دادههای ساختاریافته (جدولی) استفاده میکنید، بهجای تکیه صرف بر جستوجوی برداری، لایهی تشخیص قصد (Intent Layer) را پیادهسازی کنید.
- برای کاهش توکنهای خروجی، کارهای تکراری مثل تولید نمودار یا فرمتبندی دادهها را به لایه Backend منتقل کنید و فقط نتیجه را به مدل خبر دهید.
- سورسکد این پروژه را در مسیرهای
core/consultant_agent.pyوcore/chart_builder.pyدر گیتهاب بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو