اگر امروز بودجهای را برای استقرار عاملهای هوش مصنوعی در سازمان خود در نظر گرفتهاید، احتمال شکست این پروژه بیش از ۴۰٪ است. طبق گزارش گارتنر (Gartner) که در ۲۵ ژوئن ۲۰۲۵ منتشر شد، ترکیبی مرگبار از هزینههای عملیاتی در حال افزایش، ابهام در ارزش تجاری و مدیریت ریسک ناکارآمد، باعث توقف گسترده این پروژهها تا پایان سال ۲۰۲۷ خواهد شد. گارتنر خاطرنشان میکند که هیچیک از این سه عامل بهسادگی با استفاده از یک مدل «باهوشتر» حل نمیشوند؛ بلکه اینها شکستهای سازمانی و روششناختی هستند.
بسیاری از شرکتها اکنون قربانی «عاملشویی» (Agent Washing) شدهاند؛ یعنی تغییر نام چتباتهای ساده، اسکریپتهای RPA و دستیارهای دیجیتال به «عاملهای خودمختار» برای جذب سرمایه و جلب توجه. این روند بخشی از تغییر استراتژیک سازمانهاست که بسیاری از آنها اکنون مسیر خود را از چتباتهای ساده به سمت عاملهای عملیاتی تغییر دادهاند تا اثرگذاری واقعیتری داشته باشند. گارتنر برآورد میکند که از میان هزاران فروشندهای که ادعای ارائه قابلیتهای عاملمحور دارند، تنها حدود ۱۳۰ مورد واقعاً اصیل و معتبر هستند. این شکاف عمیق بین هایپهای بازاریابی و واقعیتهای فنی منجر به بحرانی شده است که در آن ۹۵٪ از طرحهای آزمایشی (Pilots) هوش مصنوعی زاینده در سازمانها، با وجود سرمایهگذاری ۳۰ تا ۴۰ میلیارد دلاری، اثرگذاری ملموسی بر سودآوری نداشتهاند (طبق دادههای MIT NANDA در اوت ۲۰۲۵). در حال حاضر تنها حدود ۵٪ از این طرحهای یکپارچه شده هستند که ارزش واقعی ایجاد کردهاند.
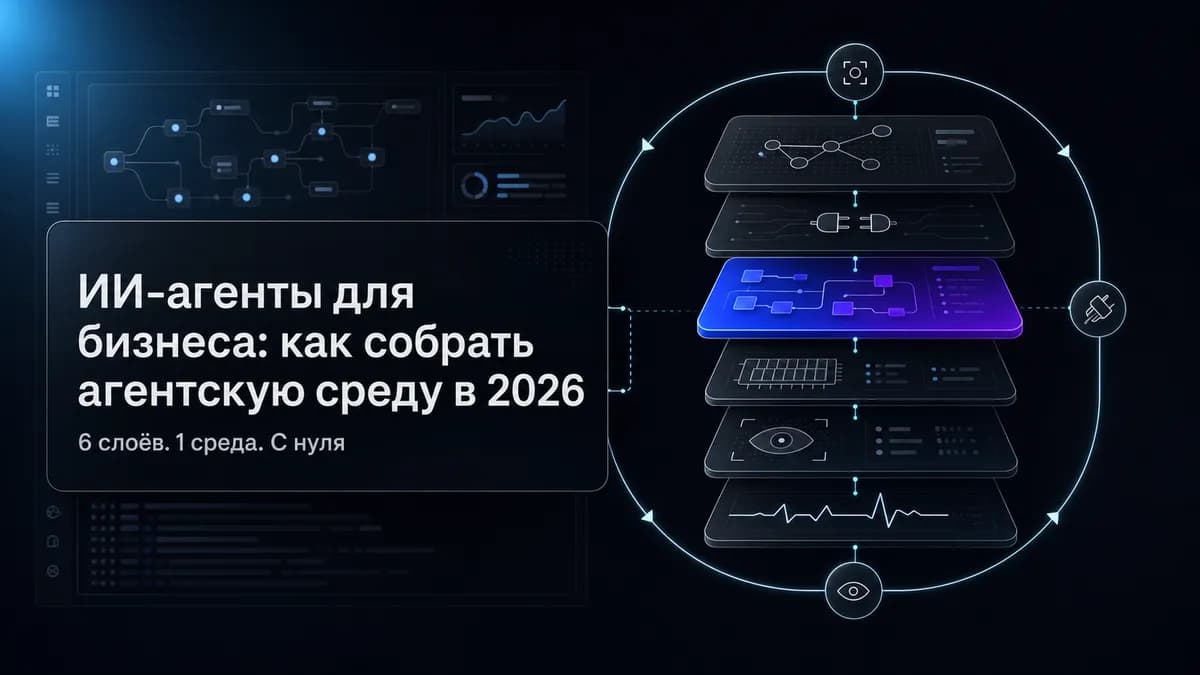
برای اینکه یک کسبوکار بتواند از یک دمو (Demo) شکننده به یک سیستم آماده تولید (Production-ready) حرکت کند، باید یک پشته فنی ششلایه را پیادهسازی کند. یک عامل هوش مصنوعی در واقع همان مدل زبانی بزرگ (LLM) است که در یک حلقه (Loop) قرار گرفته است: وظیفه را دریافت میکند، یک برنامه میریزد، ابزاری را فراخوانی میکند، نتیجه را مشاهده میکند و برنامه را تا زمان تکمیل وظیفه اصلاح میکند. این روند اساساً با یک چتبات متفاوت است؛ چرا که چتبات صرفاً یک پاسخ واحد به یک درخواست واحد میدهد.
تصور کنید مشتری میپرسد: «سفارش من کجاست؟» یک چتبات ساده تنها یک متن آماده درباره زمانهای ارسال ارائه میدهد. اما یک عامل ابتدا شماره سفارش را میخواند، ابزار پایگاهداده را برای یافتن وضعیت سفارش صدا میزند، سیاست مرجوعی را بررسی میکند، یک پاسخ مستند و واقعی میسازد و اگر درخواست خارج از محدودههای مجاز بود، آن را به یک اپراتور انسانی ارجاع میدهد. این یعنی پنج مرحله بهجای یک پاسخ ساده. همانطور که آنتروپیک (Anthropic) در راهنمای «ساخت عاملهای مؤثر» توصیه میکند، پیچیدگی سیستمها را فقط در صورت نیاز افزایش دهید؛ در برخی موارد، بهترین استراتژی این است که «اصلاً سیستم عاملمحور نسازید».
معماری پشته عاملمحور

در پایه این ساختار، ارکستراسیون (Orchestration) قرار دارد که چرخه، وضعیت (State) و شاخههای تصمیمگیری عامل را مدیریت میکند. انتخاب ارکستراتور حیاتیترین و سختترین تصمیم در این پشته است، زیرا تغییر آن در مراحل بعدی بسیار دشوار است. بازار فعلی به سه دسته اصلی تقسیم شده است:
- کد-محور (Code-First): ابزارهایی مانند LangGraph (با حدود ۳۷ هزار ستاره در گیتهب تا ۱۰ ژوئیه ۲۰۲۶، نسخه v1.2.9)، Google ADK (نسخه Go 2.0 GA با بیش از ۷ میلیون دانلود) و SDK عاملهای OpenAI (نسخه v0.18.1 با حدود ۲۷.۸ هزار ستاره). این ابزارها کنترل کامل و «وضعیت پایدار» (Durable State) را برای محیطهای عملیاتی فراهم میکنند.
- کم-کد (Low-Code): پلتفرمهایی چون n8n (با حدود ۱۹۶ هزار ستاره) و CrewAI (با ۵۵.۳ هزار ستاره، نسخه v1.15.2). اینها برای ساخت سریع نمونههای اولیه و اتوماسیون کسبوکار بدون نیاز به مهندسی سنگین ایدهآل هستند.
- مدیریتی (Managed): سرویسهای Bedrock AgentCore, Vertex AI و Azure Foundry. این گزینهها برای تیمهایی که پیشتر در یک اکوسیستم ابری خاص (Cloud Lock-in) قرار گرفتهاند، بهترین انتخاب هستند.
بازیگران قابل توجه دیگر شامل Mastra (با ۲۶ هزار ستاره و Full-stack تایپاسکریپت) و Pydantic AI (با ۱۸.۳ هزار ستاره) است که بر خروجیهای ساختاریافته و Type-safe تمرکز دارد. همچنین ابزار Strands از AWS گزارش ۱۶.۷ میلیون دانلود ماهانه را ارائه داده است.
باید توجه داشت که این چشمانداز بهسرعت تغییر میکند. مایکروسافت ابزارهای AutoGen و Semantic Kernel را در یک Agent Framework واحد ادغام کرد (نسخه 1.0 GA حدود ۲ آپریل ۲۰۲۶) و نسخههای پیشین را فقط برای رفع باگ و وصلههای امنیتی در حالت نگهداری قرار داد. در همین حال، OpenAI پروژه آزمایشی Swarm را به نفع Agents SDK آرشیو کرد.
درخت تصمیم برای انتخاب ارکستراتور
انتخاب فریمورک به نیازمندیهای خاص کسبوکار بستگی دارد:
- اتوماسیون بدون توسعهدهنده (مانند مدیریت ایمیل یا مسیریابی تیکتها): استفاده از n8n یا Make با گره AI Agent برای دسترسی به بوم بصری و یکپارچگیهای آماده.
- عاملهای مشتری در محیط عملیاتی با نیاز به حسابرسی/تأیید (مانند امور مالی یا انطباق قانونی): استفاده از LangGraph کد-محور یا پلتفرمهای مدیریتی برای مدیریت وضعیت پایدار و قابلیتهای نظارت انسانی (HITL).
- نمونه اولیه سریع چندعاملی (PoC) (برای تست فرضیات): استفاده از CrewAI برای ساخت یک پروتوتایپ نقش-محور در عرض چند ساعت و سپس انتقال منطقهای حیاتی به LangGraph.
- وابستگی به ابر موجود: استفاده از ابزارهای بومی—Strands برای AWS، Agent Framework برای Azure، یا ADK برای GCP.
اجماع کلی در سال ۲۰۲۶ این است که فریمورک در اولویت دوم قرار دارد و اولویت اصلی باید خط لوله ارزیابی (Eval Pipeline)، مشاهدهپذیری و منطق بازیابی از شکست باشد. یکی از شکایات رایج درباره CrewAI و LangChain این است که لایههای انتزاعی (Abstractions) آنها میتوانند دقیقاً آنچه به مدل ارسال میشود را پنهان کنند و دیباگ کردن در محیط عملیاتی را پیچیده سازند.
دسترسی به مدل و لایه درگاه
لایه دوم، دسترسی به مدل است. از آنج که عاملها بهطور مداوم APIها را فراخوانی میکنند، یک درگاه (Gateway) یکپارچه برای جایگزینی در صورت شکست (Failover) و مسیریابی حیاتی است. LangChain گزارش میدهد که ۷۸٪ تیمها از دو یا چند خانواده مدل برای ایجاد تعادل بین هزینه و عملکرد استفاده میکنند. نگهداری یک «باغچه از SDKهای مختلف» برای هر مدل، گران و شکننده است.
مدلهای مدرن به سمت استفاده بهینه از ابزارها در حال تکامل هستند. GPT-5.6 (منتشر شده در ۹ ژوئیه ۲۰۲۶) قابلیت «فراخوانی برنامهریزیشده ابزار» (Programmatic Tool Calling) را معرفی کرد که در آن مدل کد مینویسد و آن را برای ارکستراسیون فراخوانی ابزارها اجرا میکند. در این راستا، رقابت بر سر کاهش هزینههاست و برای مثال مدل Grok 4.5 توانسته است هزینه اجرای عاملهای کدنویسی را تا ۵۰٪ کاهش دهد که این امر استقرار عملیاتی را تسهیل میکند. بدون فراخوانی ساختاریافته و قابل اتکا، یک عامل نمیتواند عمل کند.
یک درگاه یکپارچه سازگار با OpenAI که اجازه مسیریابی بین Claude، GPT، Gemini، DeepSeek و Qwen را بدهد، تضمین میکند که در صورت خرابی یک تامینکننده، کل چرخه عامل متوقف نشود. این لایه قابلیتهای مسیریابی، Failover، کشینگ (Caching) و صورتحساب یکپارچه را فراهم میکند و به توسعهدهندگان اجازه میدهد مدل را تنها با بهروزرسانی یک فیلد در درخواست تغییر دهند.
حافظه: کوتاهمدت در برابر بلندمدت
حافظه به دو نوع تقسیم میشود: پنجرههای زمینه کوتاهمدت و ذخیرهسازی بلندمدت. اگرچه مدلهای پرچمداران اکنون پنجرههایی تا ۱ میلیون توکن دارند، اما این حافظه واقعی نیست. دقت مدلها اغلب با پر شدن پنجره کاهش مییابد؛ پدیدهای که در آن اطلاعات «در وسط گم میشوند» (Lost in the Middle).
- کوتاهمدت: پنجره زمینه فوری. آنتروپیک استراتژی «مهندسی زمینه» (Context Engineering) را پیشنهاد میدهد که به معنای بارگذاری دادهها دقیقاً در لحظه نیاز است، بهجای غرق کردن پنجره در حجم زیاد داده.
- بلندمدت: ذخیرهسازهای خارجی مانند mem0 یا Zep. ابزار mem0 در بنچمارک LoCoMo دقت ۹۲.۵ درصدی را ثبت کرد در حالی که مصرف توکن را تا ۹۰٪ کاهش داد (ECAI 2025). ابزار Zep با استفاده از گراف دانش زمانی (Temporal Knowledge Graph)، افزایش دقت ۱۸.۵ درصدی نسبت به زمینه کامل در LongMemEval با تأخیری ۹۰٪ کمتر نشان داده است (arXiv 2501.13956).
در لایههای زیرین، حافظه بلندمدت معمولاً بر پایگاهدادههای برداری (Vector Database) مانند pgvector (پستگرس)، Pinecone، Qdrant، Weaviate یا Chroma برای نمونههای اولیه محلی تکیه دارد. در حالی که RAG برای دانش ایستا و مشترک مفید است، حافظه بلندمدت زمانی ضروری است که کاربران مجوزهای مختلفی داشته باشند یا عاملها مجبور باشند دادههای تازه را از اطلاعات قدیمی تشخیص دهند.

ابزارها و استاندارد MCP
ابزارها در واقع «دستهای» عامل هستند: APIها، جستجو، اجرای کد و پایگاههای داده. صنعت اکنون حول پروتکل زمینه مدل (MCP) متمرکز شده است که آنتروپیک در ۹ دسامبر ۲۰۲۵ آن را به بنیاد لینوکس منتقل کرد. این پروتکل مانند «USB-C برای ابزارهای هوش مصنوعی» عمل میکند و اجازه میدهد بهجای ایجاد NxM اتصال سفارشی، از یک استاندارد واحد استفاده شود.
تا اواخر ۲۰۲۵، این اکوسیستم شامل بیش از ۱۰ هزار سرور عمومی و ۹۷ میلیون دانلود ماهانه SDK بود. بنیاد Agentic AI که توسط آنتروپیک، Block و OpenAI بنیانگذاری شده، اکنون این استاندارد را با حمایت گوگل، مایکروسافت، AWS، کلودفلر و بلومبرگ مدیریت میکند. علاوه بر این، پروتکل A2A (Agent2Agent) نسخه ۱.۰ در آپریل ۲۰۲۶ منتشر شد و اکنون به بیش از ۱۵۰ سازمان اجازه میدهد چندین عامل تخصصی را به یکدیگر متصل کنند.
مشاهدهپذیری و شکاف کیفی
زیرساختها وظیفه مقیاسبندی، ایزولاسیون و مدیریت محیطهای زمان اجرا را بر عهده دارند. لایه نهایی — مشاهدهپذیری (Observability) — ردگیری (Tracing) و لاگهای لازم برای دیباگ یک فرآیند چندمرحلهای را فراهم میکند. در اینجا شکاف بزرگی وجود دارد: دادههای LangChain نشان میدهد در حالی که ۸۹٪ تیمها از ردگیری (از طریق ابزارهایی مثل LangSmith، Langfuse یا Arize Phoenix) استفاده میکنند، تنها ۵۲٪ ارزیابیهای کیفی (Evals) رسمی را پیاده کردهاند.
ردگیری، یک اجرا را به «بازه ها» (Spans) تقسیم میکند، بهطوری که برای هر رفتوبرگشت مدل و هر فراخوانی ابزار یک بازه مجزا وجود دارد. شایان ذکر است که «کنونسیونهای معنایی OpenTelemetry GenAI» تا ژوئیه ۲۰۲۶ هنوز در وضعیت «توسعه» هستند، به این معنی که یکپارچهسازی معیارها هنوز سیال است. نبود ارزیابیها (Evals) اولین مانع ورود به محیط عملیاتی است که توسط ۳۲٪ تیمها ذکر شده؛ بدون آنها، تیمها نمیدانند آیا تغییر در یک پرامپت واقعاً عملکرد عامل را بهبود داده است یا خیر.
هزینه استقلال
عاملها بهطور نمایی گرانتر از چتباتها هستند زیرا یک حلقه چندمرحلهای را اجرا میکنند و در هر چرخه، زمینهای (Context) را که در حال رشد است، مجدداً ارسال میکنند. آنتروپیک در ژوئن ۲۰۲۶ اندازهگیری کرد که یک عامل حدود ۴ برابر بیشتر از یک چت ساده توکن مصرف میکند، در حالی که سیستمهای چندعاملی این رقم را تا ۱۵ برابر افزایش میدهند. نکته حیاتی این است که هزینه توکن حدود ۸۰٪ از تغییرات کیفیت را توضیح میدهد: عاملهای قدرتمندتر بهطور خطی گرانتر هستند.
نشتیهای بودجه اغلب از طریق «حلقههای تکرار» (Retry Loops) رخ میدهد؛ جایی که عامل در یک مرحله شکست میخورد و بهطور بیصدا دوباره تلاش میکند. یک مطالعه موردی در Habr (۲۳ آپریل ۲۰۲۶) نشان داد که یک اجرای چندعاملی برای ۱۲۷ فراخوانی ۴.۳۰ دلار هزینه داشت، در حالی که یک گراف تعیینشده (Deterministic Graph) همان وظیفه را با تنها ۱۴ فراخوانی و هزینه ۰.۴۲ دلار حل کرد.
برای مقابله با این موضوع، مهندسان از سه اهرم اصلی استفاده میکنند:
- حافظه پنهان پرامپت (Prompt Caching): هزینه خواندن زمینه کششده تقریباً ۰.۱ برابر قیمت پایه است، که تخفیفی حدود ۹۰ درصدی برای پرامپتهای سیستمی تکراری فراهم میکند (پیاده شده توسط آنتروپیک، OpenAI و گوگل).
- Batch API: تخفیف ۵۰ درصدی برای کارهایی که نیاز به پاسخ آنی ندارند.
- مسیریابی مدل (Model Routing): ارسال مراحل روتین به مدلهای «کوچک» و رزرو مدلهای پرچمدار برای استدلالهای پیچیده. اختلاف قیمت بین یک مدل جونیور و پرچمدار معمولاً حدود ۵ برابر است.
اجتناب از «سهگانه مرگبار»
امنیت آخرین مانع است. سایمون ویلیسون «سهگانه مرگبار» را ترکیبی از این سه مورد تعریف میکند: (۱) دسترسی به دادههای خصوصی، (۲) تماس با محتوای غیرقابل اعتماد و (۳) توانایی ارتباط خارجی. وقتی عاملی هر سه را داشته باشد، یک «تزریق پرامپت» (که در آن دستورالعمل مخرب در یک ایمیل یا صفحه وب پنهان شده) میتواند بهراحتی عامل را فریب دهد تا دادههای خصوصی را برای یک مهاجم خارجی ارسال کند.

تهدیدات جدیدی مانند «عاملربایی» (Agentjacking) در ژوئن ۲۰۲۶ ظهور کردند، جایی که دادههای مخرب تزریق شده از طریق ورودیهای باز، به عاملهای کدنویسی اجازه میدهد دستورات غیرمجاز را با دسترسیهای توسعهدهنده اجرا کنند. لیست «۱۰ مورد اول OWASP برای برنامههای عاملمحور» (دسامبر ۲۰۲۵) ریسکهایی مانند LLM06 (عاملیت بیش از حد) و LLM10 (مصرف نامحدود منابع) را برجسته میکند.
تنها دفاع قابل اطمینان، اصل «حداقل دسترسی» (Least Privilege) است؛ یعنی دادن محدودترین مجوزهای ممکن، استفاده از اعتبارنامههای کوتاهمدت و اجبار به تأیید انسانی برای تمام اقدامات غیرقابل بازگشت. جداسازی معماری — یعنی حذف یکی از سه ضلع این سهگانه — مؤثرترین راه برای مسدود کردن خروج دادههاست.
مسیر رسیدن به استقرار عملیاتی
قابلیت اطمینان یک چالش ریاضی است. طبق قانون لوسیر (Lussier Law)، قابلیت اطمینان در یک فرآیند چندمرحلهای، حاصلضرب احتمال موفقیت هر مرحله است. اگر یک عامل در هر مرحله نرخ موفقیت ۹۵٪ داشته باشد، یک فرآیند ۲۰ مرحلهای تنها ۳۶٪ احتمال موفقیت کلی دارد (0.95^20). به همین دلیل است که عاملها در وظایف گسترده همچنان ۳۰ تا ۵۰ درصد شکست میخورند.
بنچمارکهای ۹ ژوئیه ۲۰۲۶ شکاف بین وظایف محدود و گسترده را نشان میدهند:
- وظایف محدود (τ-bench): نرخ موفقیت ۸۵ تا ۹۹ درصدی، هرچند ثبات (pass^k) در اجراهای متعدد پایین است.
- وظایف گسترده: GAIA (حدود ۵۲٪)، Agents' Last Exam (حدود ۵۴٪ برای GPT-5.6 Sol)، SWE-bench Pro (۶۴.۶٪ برای GPT-5.6 Sol) و WebArena (حدود ۶۸٪).
راهکار پیشنهادی، استراتژی «سینه خیز-پیادهروی-دویدن» است:
۱. شناسایی یک فرآیند محدود: یک وظیفه تکراری با معیار موفقیت شفاف انتخاب کنید (مثلاً مسیریابی تیکت). از ساخت «دستیارهای جهانی» اجتناب کنید.
۲. ساخت PoC: یک مدار مینیمال شامل ارکستراتور + مدل + ۲ ابزار بسازید. نرخ زمان پاسخدهی و بستهشدن خودکار را اندازه بگیرید.
۳. ادغام انسان: از «انسان در حلقه» (Human-in-the-loop) برای اقدامات پرریسک و «انسان روی حلقه» (Human-on-the-loop/مانیتورینگ) برای ریسکهای متوسط استفاده کنید.
۴. استقرار ارزیابیها: معیارهای کیفی را روی ترافیک زنده پیاده کنید و آنها را در CI/CD ادغام نمایید.
۵. راهاندازی با حسابرسی: ردپاهای دقیق حسابرسی (Audit Trails) و محدودیتهای سختگیرانه برای تعداد مراحل و هزینه تعریف کنید تا از نشتی بودجه در حلقههای تکرار جلوگیری شود.
۶. مقیاسدهی: تنها پس از پایدار شدن اولین فرآیند، به سراغ فرآیندهای مجاور بروید.
وضعیت بازار روسیه
در روسیه، بزرگترین گلوگاه «لایه دسترسی» است. پرداخت برای مدلهای برتر مانند GPT-5.6 یا Claude Opus 4.8 بهدلیل احرازهویتهای سختگیرانه (Persona از آپریل ۲۰۲۶)، مسدودسازی IP/BIN و نبود اسناد رسمی برای اشخاص حقوقی دشوار است. این موضوع برای عاملهایی که نیاز به آپتایم ۱۰۰٪ دارند حیاتی است، زیرا یک قطعی API کل سیستم عملیاتی را از کار میاندازد. در این بازارهای پیچیده، استفاده از تجمیعکنندگان API توانسته است هزینههای دسترسی به مدلهایی مانند ChatGPT را تا ۷۰٪ کاهش دهد و مسیرهای پرداخت را تسهیل کند.
طبق نظرسنجی Sber (می ۲۰۲۶ از ۳۰۸ شرکت)، ۵۶٪ شرکتهای بزرگ خواهان عاملها برای کارهای روتین اداری هستند. AFT (۵ ژوئیه ۲۰۲۶) گزارش میدهد که ۷۵٪ شرکتها قصد دارند طی سه سال آینده استقرار گسترده عاملها را اجرا کنند، اگرچه فرهنگ سازمانی و ترس از تعدیل نیرو همچنان موانع اصلی هستند.
راهکارهایی مانند provod.ai این مشکل را با ارائه یک API یکپارچه سازگار با OpenAI برای تمام مدلهای پرچمدار (از جمله Claude Opus 4.8، GPT-5.5، Gemini 3.1 Pro، DeepSeek v4، Qwen، Kimi و Grok) با پرداخت به روبل و اسناد قانونی کامل حل میکنند. این امر نیاز به VPNهای ناپایدار و تأییدهای پیچیده حسابهای شخصی را از بین میبرد.
این تحولات نشان میدهد سودآورترین عاملهای سال ۲۰۲۶، نه آن نابغههای خودمختاری که در اسلایدهای تبلیغاتی میبینیم، بلکه ابزارهای محدود، خستهکننده و بهشدت کنترلشدهای هستند. مزیت رقابتی از «داشتن بهترین مدل» به «داشتن بهترین خط لوله ارزیابی و منطق بازیابی از شکست» تغییر یافته است.
گام بعدی شما
- سریعترین مسیر: اگر قصد آزمایش دارید، با CrewAI شروع کنید اما برای استقرار عملیاتی حتماً به سراغ LangGraph بروید.
- کاهش هزینه: لایه Prompt Caching را در تمام پرامپتهای سیستمی فعال کنید تا هزینه توکنها تا ۹۰٪ کاهش یابد.
- مدیریت ریسک: دسترسیهای عامل خود را بررسی کنید و مطمئن شوید هیچ عاملی بهطور همزمان به دادههای خصوصی و اینترنت دسترسی بدون نظارت ندارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو