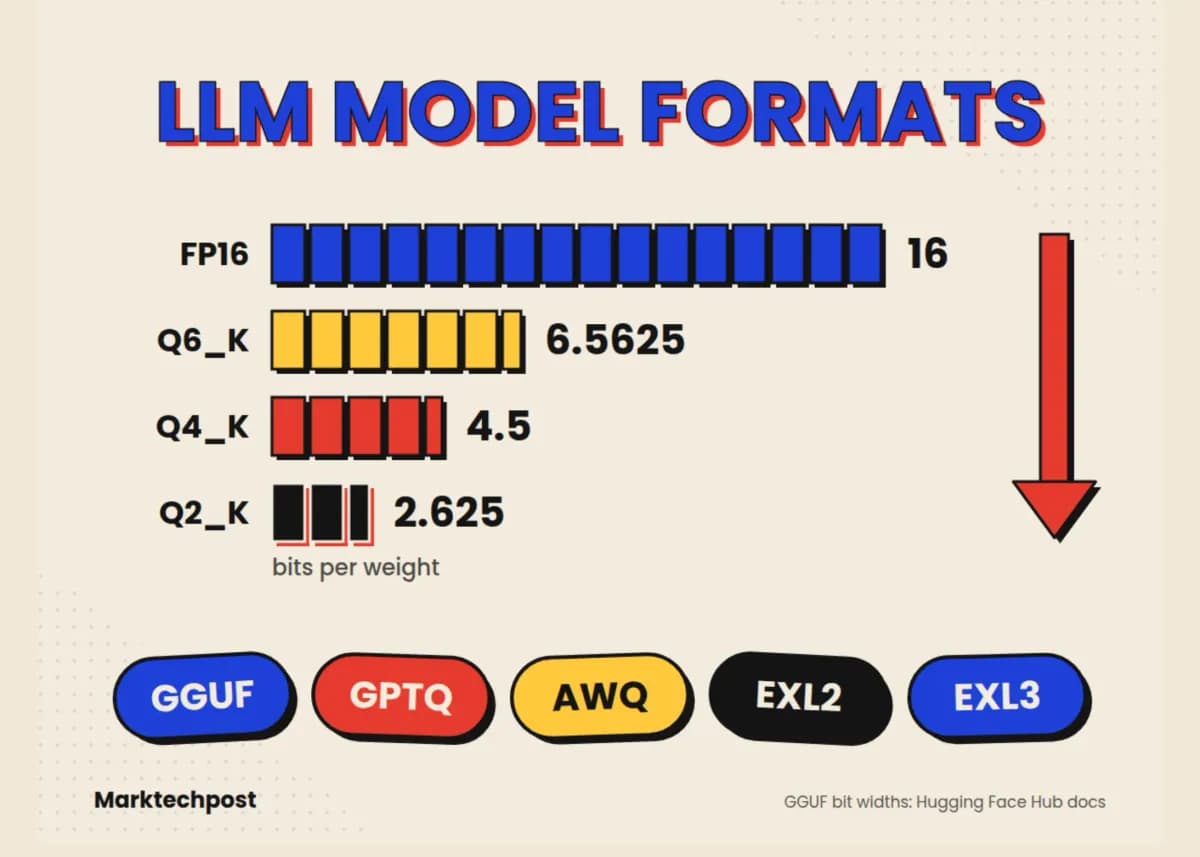
اگر قصد دارید یک مدل زبانی بزرگ را بهصورت محلی اجرا کنید، احتمالاً با انبوهی از پسوندهای گیجکننده مثل GGUF، GPTQ، AWQ، EXL2 یا Safetensors مواجه شدهاید که انتخاب اشتباه هر کدام میتواند منجر به کرش کردن سیستم یا افت شدید سرعت شود. برای عبور از این سردرگمی، ابتدا باید دو مفهوم متمایز را از هم جدا کنید: «کانتینر» و «روش کوانتش».
یک کانتینر تعریف میکند که تنسورها چگونه روی دیسک ذخیره شوند؛ فرمتهایی مانند Safetensors، GGUF و فایلهای pickle پایتون (.bin / .pt) نمونههایی از کانتینرها هستند. در مقابل، روش کوانتش تعریف میکند که وزنها چگونه از نظر ریاضی فشرده شوند تا بیتهای کمتری اشغال کرده و مصرف حافظه کاهش یابد. نمونههایی از روشهای کوانتش عبارتند از GPTQ، AWQ، bitsandbytes NF4 و K-quants در llama.cpp. برخی فرمتها مانند EXL2 هر دو مفهوم را ترکیب کرده و هم روش کوانتش و هم ساختار ذخیرهسازی را به یک کتابخانه استنتاج خاص گره میزنند.
کوانتش (Quantization) — شبیه به تبدیل یک عکس باکیفیت به فرمت JPEG است تا فضای کمتری بگیرد اما ظاهرش تقریباً همان بماند — فرآیندی است که در آن وزنها (Weights) از دقت ۱۶ بیت به مقادیر کمتری (مثلاً ۴ بیت) کاهش مییابند تا مدل در حافظه جای بگیرد. طبق یک قاعده کلی برای محاسبه نیازهای حافظه، فرمول به این صورت است: حافظه وزنها ≈ تعداد پارامترها × تعداد بیتها به ازای هر وزن ÷ ۸.
برای مثال، یک مدل ۸ میلیارد پارامتری با دقت ۱۶ بیت به تقریباً ۱۶ گیگابایت VRAM (حافظه ویدیویی) نیاز دارد. اگر همین مدل به ۴.۵ بیت کوانتش شود، این نیاز به حدود ۴.۵ گیگابایت کاهش مییابد. برای یک مدل ۷۰ میلیارد پارامتری، این جهش بسیار چشمگیرتر است: از ۱۴۰ گیگابایت در دقت ۱۶ بیت به حدود ۳۹ گیگابایت در دقت ۴.۵ بیت. بسیار حیاتی است که به یاد داشته باشید این محاسبات فقط مربوط به وزنهاست؛ حافظه KV cache و سربارهای زمان اجرا (runtime overhead) در هنگام استنتاج واقعی، حافظه بیشتری را میطلبند. در همین راستا، برخی راهکارهای سختافزاری مانند پلتفرم FX100 با بهینهسازی حافظه KV cache توانستهاند نرخ عملیاتی استنتاج را بهطور قابلتوجهی افزایش دهند.
مدلهای با دقت کامل معمولاً با وزنهای ۱۶ بیتی در قالب فایلهای pytorch_model.bin یا model.safetensors عرضه میشوند. فایلهای قدیمی .bin و .pt از Python pickle استفاده میکنند که یک ریسک امنیتی جدی است، زیرا بارگذاری یک فایل pickle میتواند کدهای دلخواه و مخربی را روی سیستم شما اجرا کند.
به گزارش Hugging Face، فرمت Safetensors برای حذف این ریسک توسعه یافته است. این فرمت از یک هدر JSON کوچک و سپس بافرهای خام تنسور استفاده میکند. این ساختار اجازه میدهد تنسورها بهصورت memory-mapped بارگذاری شوند و بدون نیاز به خواندن کل فایل در RAM، هر بخش بهطور مجزا فراخوانی شود. نکته قابل توجه این است که بسیاری از مدلهای GPTQ، AWQ و EXL2 نیز در فایلهای .safetensors ذخیره میشوند؛ در این موارد، کوانتش در محتوای تنسورها و یک فایل پیکربندی تعبیه شده است، نه اینکه خودِ Safetensors یک فرمت کوانتش باشد.
GGUF (GPT-Generated Unified Format) استاندارد طلایی برای استنتاج روی CPU و سیستمهای ترکیبی (CPU/GPU) است. این فرمت که توسط Georgi Gerganov برای اکوسیستم llama.cpp ساخته شده، جایگزین فرمت قدیمی GGML شد تا یک مشکل بحرانی در متادادهها را حل کند. فایلهای GGML فاقد مشخصات معماری بودند و هر تغییر در هایپرپارامترها باعث خراب شدن فایلهای موجود میشد. GGUF متادادههای کلید-مقدار تایپشده را معرفی کرد که به فایل اجازه میدهد معماری مدل و هایپرپارامترها را بهصورت داخلی توصیف کند. این ویژگی GGUF را بسیار قابل حمل و آیندهنگر میکند.
مزیت اصلی GGUF قابلیت «آفلودینگ» (Offloading) است. کاربران میتوانند بخشی از مدل را روی GPU (VRAM) بارگذاری کنند و بقیه را در RAM سیستم باقی بگذارند. این امر اجازه میدهد مدلهای عظیم روی سختافزارهای مصرفکننده اجرا شوند، هرچند با سرعت کمتر. GGUF از سطوح کوانتش متنوعی مانند K-quants و I-quants استفاده میکند تا تعادلی بهینه میان perplexity (معیاری برای سنجش دقت و خطای مدل) و اندازه فایل ایجاد کند.
در مقابل، GPTQ (Generalized Post-Training Quantization) اساساً برای استنتاج متمرکز بر GPU طراحی شده است. این روش از یک فرآیند کالیبراسیون تکمرحلهای (one-shot) برای به حداقل رساندن خطای ناشی از کوانتش استفاده میکند. GPTQ برای استقرارهای استاتیک که در آن مدل بهطور کامل در VRAM جای میگیرد، بسیار کارآمد است. در حالی که سرعت فوقالعادهای ارائه میدهد، فرآیند کالیبراسیون در هنگام ساخت مدل کوانتش شده میتواند زمانبر باشد. GPTQ بهطور گسترده توسط لودرهای مختلف پشتیبانی میشود و اغلب انتخاب پیشفرض کاربرانی است که VRAM کافی برای جای دادن کل مدل را دارند اما میخواهند نرخ تولید توکن (throughput) را به حداکثر برسانند.
AWQ (Activation-aware Weight Quantization) رویکردی پیچیدهتر از GPTQ دارد. AWQ بهجای اینکه با تمام وزنها یکسان برخورد کند، وزنهای مهمتر را بر اساس الگوهای فعالسازی در یک فاز کالیبراسیون شناسایی میکند. با محافظت از این وزنهای «حیاتی» در برابر کوانتش تهاجمی، AWQ معمولاً دقت بالاتر (perplexity کمتر) را نسبت به GPTQ حفظ میکند، بهویژه در نرخهای بیت پایین مانند ۴ بیت. AWQ بهطور فزایندهای در حال تبدیل شدن به انتخاب برتر برای استقرار روی GPU است زیرا تعادل بهتری بین عملکرد و هوشمندی ارائه میدهد، هرچند فضای VRAM مورد نیاز آن مشابه GPTQ است.
برای کسانی که به دنبال سرعت مطلق روی کارتهای گرافیک انویدیا هستند، EXL2 (ExLlamaV2) برنده است. برخلاف کوانتش با بیت ثابت در GPTQ یا AWQ، فرمت EXL2 اجازه میدهد نرخ بیت بهصورت «سَر-محور» (head-wise) یا متغیر تنظیم شود. این یعنی کاربر میتواند یک مدل را دقیقاً روی ۴.۶۵ بیت یا ۵.۲ بیت کوانتش کند تا مدل بهطور کامل و دقیق در ظرفیت VRAM خاص او جای بگیرد. EXL2 برای لودر ExLlamaV2 بهینه شده است که در حال حاضر یکی از سریعترین موتورهای استنتاج برای مدلهای محلی است. نقطه ضعف این فرمت، قابلیت حمل پایینتر آن است؛ EXL2 بهشدت با اکوسیستم ExLlamaV2 گره خورده و مانند GGUF یا Safetensors سازگاری جهانی ندارد. در این زمینه، نوآوریهایی مانند استفاده از DSpark برای افزایش سرعت پاسخدهی نشان میدهد که بهینهسازیهای نرمافزاری میتوانند محدودیتهای سختافزاری محلی را تا حد زیادی تعدیل کنند.
انتخاب فرمت مناسب کاملاً به سختافزار و اهداف شما بستگی دارد. اگر از مک (Apple Silicon) یا کامپیوتری با VRAM محدود استفاده میکنید، GGUF به دلیل قابلیتهای انعطافپذیر آفلودینگ، تنها گزینه عملی است. اگر یک GPU ردهبالای انویدیا دارید و بهدنبال بیشترین تعداد توکن در ثانیه هستید، EXL2 برنده است. برای تعادلی بین دقت بالا و بهرهوری GPU، مسیر توصیه شده AWQ است. برای سازگاری عمومی با GPU در پشتههای نرمافزاری مختلف، GPTQ همچنان یک استاندارد استوار است.
بر اساس بررسی منابع متعدد، در سال ۲۰۲۶ روند صنعت به سمت کوانتش «دینامیک» در حال حرکت است؛ یعنی ظهور فرمتهایی که میتوانند دقت خود را در لحظه و بر اساس پیچیدگی پرامپت تغییر دهند. با این حال، تمایز اصلی بین GGUF (دوستدار CPU) و خانواده GPTQ/AWQ/EXL2 (بهینه برای GPU) همچنان خط dividing اصلی برای اکثر کاربران است. درک این نکته که Safetensors اغلب فقط «پاکت» است و AWQ یا GPTQ «نامهای» است که درون آن قرار دارد، به رمزگشایی از پسوندهای فایل در پلتفرمهایی مانند Hugging Face کمک میکند. هنگام دانلود مدل، همیشه تگ Quantization را چک کنید؛ یک مدل ۴ بیتی AWQ تقریباً همیشه در وظایف استدلالی بهتر از یک مدل ۴ بیتی GPTQ عمل میکند، در حالی که اگر برای یک مدل ۳۰ میلیارد پارامتری فقط ۱۲ گیگابایت VRAM داشته باشید، GGUF تنها مدلی خواهد بود که بارگذاری میشود.
علاوه بر این، تکامل I-quants در اکوسیستم GGUF شکاف بین عملکرد CPU و GPU را کاهش داده است. GGUF اکنون با استفاده از ماتریسهای اهمیت (importance matrices)، میتواند به امتیازات perplexity دست یابد که با مدلهای دقت کامل رقابت میکنند، در حالی که همچنان بهاندازه کافی کوچک هستند تا در یک لپتاپ جای بگیرند. این دموکراتیزه کردن LLMها به این معناست که انتخاب فرمت دیگر فقط درباره این نیست که «آیا مدل جا میشود یا نه»، بلکه درباره این است که «با چه سرعتی اجرا میشود» و «چقدر هوشمند میماند». برای توسعهدهندگانی که در حال ساخت اپلیکیشن هستند، انتخاب اغلب به سرور استنتاج برمیگردد. vLLM و TGI (Text Generation Inference) به دلیل هستههای بهینه CUDA، بهشدت AWQ و GPTQ را ترجیح میدهند، در حالی که علاقهمندان محلی که از LM Studio یا Ollama استفاده میکنند، تقریباً بهطور انحصاری به GGUF متکی هستند.
در مجموع، سلسلهمراتب انتخاب ساده است: از GGUF برای تطبیقپذیری و حافظه CPU/Hybrid استفاده کنید؛ از AWQ برای استنتاج GPU با وفاداری بالا (High-fidelity)؛ از EXL2 برای حداکثر سرعت و برازش دقیق در VRAM؛ و از GPTQ برای سازگاری گسترده با GPU. با تطبیق فرمت با سختافزار، کاربران میتوانند پتانسیل کامل مدلهای بازمتن را بدون محدود شدن توسط گلوگاههای حافظه یا موتورهای استنتاج غیربهینه آزاد کنند. انتقال از فایلهای ریسکی .bin به فرمتهای امن Safetensors و GGUF همچنین جامعه را ایمنتر کرده و تضمین میکند که تجربه مدلهای جدید با ریسک اجرای کدهای مخرب روی سیستم محلی همراه نباشد.
گام بعدی شما
- اگر مک یا سیستم با VRAM محدود دارید، فقط از مدلهای GGUF استفاده کنید.
- برای بیشترین سرعت در کارتهای NVIDIA، مدلهای EXL2 را امتحان کنید.
- اگر تعادل بین دقت و سرعت روی GPU میخواهید، اولویت را به AWQ بدهید.
- برای سازگاری حداکثری با ابزارهای مختلف GPU، از GPTQ استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو