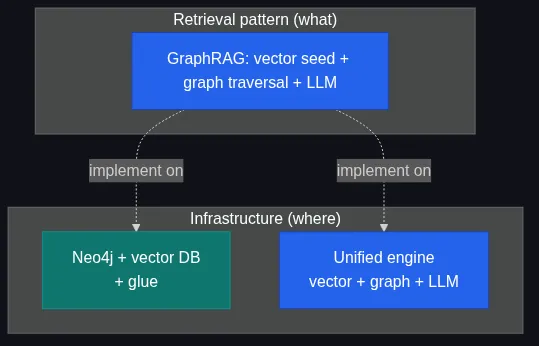
اگر امروز در حال توسعه یک عامل هوش مصنوعی هستید، گرانترین اشتباهی که میتوانید مرتکب شوید این است که GraphRAG را یک محصول نرمافزاری ببینید، نه یک الگوی بازیابی. باید بدانید که انتخاب بین Neo4j و یک موتور یکپارچه، نبرد میان دو نرمافزار نیست، بلکه انتخاب یک معماری عملیاتی است. قاببندی این بحث اغلب اشتباه است: GraphRAG در واقع روشی برای ترکیب شباهت برداری با پیمایش گرافی است تا بستر متنی (Context) بهتری به یک مدل زبانی بزرگ (LLM) تزریق شود، در حالی که Neo4j یک زیرساخت است که در آن گرافها را ذخیره و پرسوجو میکنید. شما میتوانید GraphRAG را روی Neo4j پیاده کنید، اما همین کار را روی SynapCores، Postgres+Apache AGE، TigerGraph یا یک موتور سفارشی نیز میتوانید انجام دهید.
تولید بازیابیافزا گرافی (GraphRAG) — شبیه به کارآگاهی است که ابتدا با جستوجوی سریع کلمات کلیدی (بردارها) سرنخهای اولیه را پیدا میکند و سپس با دنبال کردن روابط بین افراد (گراف)، نقشه کامل جرم را میکشد — ترکیبی از شباهت برداری و پیمایش گرافی است تا بستر متنی دقیقتری به مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — ارائه دهد. برای سالها، استاندارد صنعت جفت کردن یک پایگاهداده گرافی با یک ذخیرهساز برداری مجزا بود. این رویکرد یک «مالیات همگامسازی» ایجاد میکند؛ یعنی یک بار عملیاتی دائمی برای اطمینان از اینکه دادهها در دو سیستم متفاوت یکسان باقی میمانند.
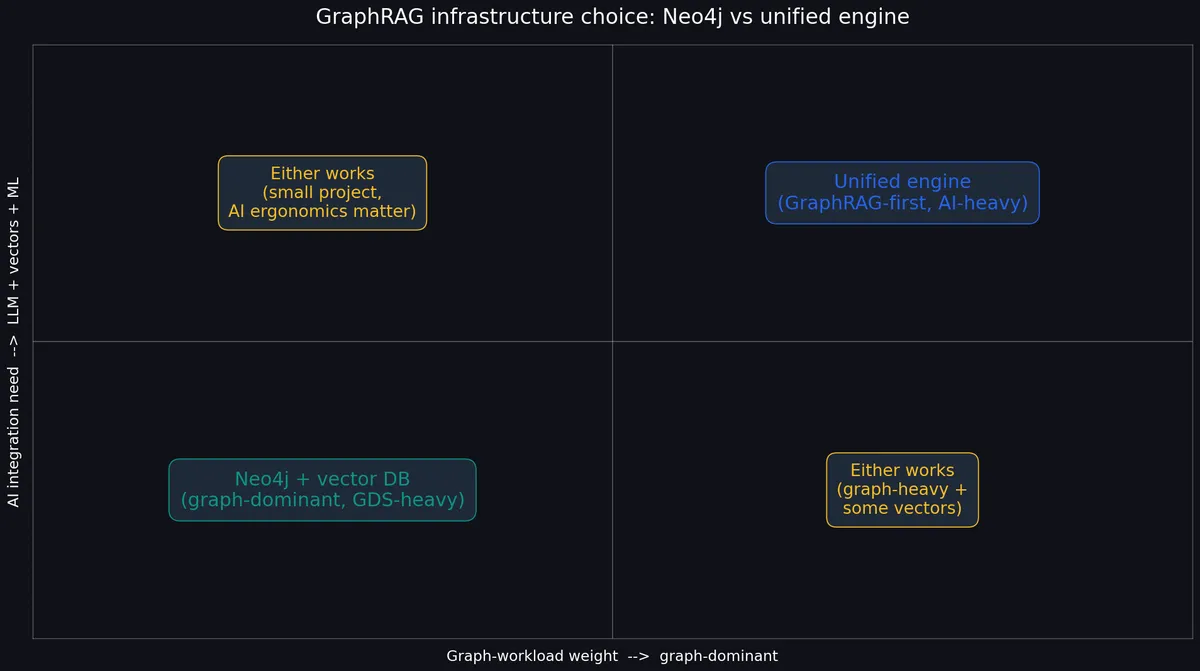
به نقل از راهنمای فنی SynapCores که در ۱۱ اکتبر ۲۰۲۶ منتشر شد، تصمیم نهایی به این بستگی دارد که حجم کاری شما «گراف خالص» است یا «هوش مصنوعیمحور». برای کسانی که بر مورد دوم تمرکز دارند، اصطکاک معماری ناشی از ذخیرهسازهای دوگانه اغلب بر بلوغ ابزارهای قدیمی گرافی غلبه میکند. همانطور که در تحلیلهای قبلی ما دربارهی زیرساختهای حافظه برای عاملها اشاره کردیم، سؤال درست این نیست که «کدام یک برنده است»، بلکه این است که «برای حجم کاری من، چه معماریای مناسب است؟»
قدرت بدنی Neo4j
Neo4j با بیش از ۱۵ سال سابقه در محیطهای عملیاتی، همچنان غول دنیای گراف است. این سیستم اولین پایگاهداده گرافی بومی بود که به موفقیت تجاری رسید و مسئول ابداع یا ترویج زبان Cypher است؛ زبان پرسوجوی گرافی که اکنون اکثر موتورهای دیگر از آن استفاده میکنند. Neo4j برای گرافهای ویژگی (Property Graphs) — یعنی گرهها و یالهای تایپشده با ویژگیهای خاص — ساخته شده و یکی از ارگونومیکترین زبانهای پرسوجو را ارائه میدهد. یک پرسوجوی ساده مانند MATCH (a)-[r:KNOWS]->(b) WHERE a.name = 'Alice' RETURN b به خوبی نشان میدهد که این زبان چه سطح مناسبی از انتزاع را برای دادههای گرافی فراهم میکند.
Neo4j در حوزههای خاص با پیچیدگی بالا برتری دارد:
- ذخیرهسازی بومی گراف ویژگی: این سیستم بهطور خاص برای گرافها طراحی شده است، نه اینکه از ردیفهای جدولی بازسازی شده باشد. ایندکسها روی برچسبها (Labels)، ویژگیها و روابط به طور بومی پیاده شدهاند.
- عملکرد پیمایش بالغ: توانایی انجام پیمایشهای چندگامی (Multi-hop walks) با تأخیر میلیثانیهای در گرافهایی با صدها میلیون گره.
- اکوسیستم قدرتمند: دسترسی به کتابخانه Graph Data Science (GDS) برای اجرای الگوریتمهایی مثل PageRank، تشخیص جوامع (Community Detection)، پیشبینی لینک و جاسازیهای گرهی مانند Node2Vec و GraphSAGE.
- ابزارهای صنعتی: حل مسائل «کسلکننده» اما حیاتی مانند خوشهبندی (Clustering)، پشتیبانگیری، چندمستاجری (Multi-tenancy) و نظارت.
- بصریسازی: ابزارهای پیشرفتهای مثل Bloom و Neo4j Browser برای مشاهده روابط پیچیده.
اما Neo4j یک پایگاهداده برداری نیست. اگرچه در نسخه ۵.۱۱ (حدود سال ۲۰۲۳) ایندکسهای برداری را اضافه کرد، اما این قابلیتها در مقایسه با ذخیرهسازهای تخصصی برداری، شهروند درجه دو هستند و برای حجمهای کاری با بازخوانی بالا (High-recall) در مقیاس بزرگ، همتراز نیستند. اگر الگوهای دسترسی اصلی شما برداری است، این ایندکس تنها یک افزونه برای موتور است. همچنین Neo4j فاقد توابع بومی LLM مانند GENERATE() در دل Cypher است و توسعهدهنده را مجبور میکند به لایههای خارجی مثل Python یا LangChain تکیه کند. علاوه بر این، این سیستم برای Joinهای رابطهای در مقیاس بزرگ (مثلاً Join سه جدول روی کلیدهای ایندکسشده بزرگ) بهینه نشده و از AutoML یا آموزش مدل در داخل دیتابیس (In-DB training) پشتیبانی نمیکند. این یک نقد نیست؛ بلکه ماهیت Neo4j به عنوان یک دیتابیس گرافی است. هزینه این تخصص این است که هر چیزی غیر از گراف باید جای دیگری زندگی کند و شما مسئول همگامسازی آنها هستید.
کالبدشکافی الگوی GraphRAG
مکانیسم GraphRAG در هر دیتابیسی یکسان است و یک الگوی بازیابی است، نه یک نرمافزار خاص: ابتدا سؤال کاربر به بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگانش را مشخص میکند — تبدیل میشود؛ سپس بر اساس شباهت برداری، k-تعداد از تکهها یا گرههای برتر پیدا میشوند؛ در گام سوم، از این گرههای بذر (Seed nodes) به اندازه N گام در طول یالهای تایپشده پیمایش میشود؛ و در نهایت، زیرگراف حاصل (شامل تکهها + گرهها + یالها) به عنوان بستر متنی به LLM ارسال میشود.
از آنجایی که GraphRAG به هر دو قابلیت ایندکس برداری و موتور گرافی نیاز دارد، تصمیم معماری صرفاً بر سر نحوه تأمین این دو قابلیت است. شما میتوانید یا مسیر «چند-ذخیرهساز» (دیتابیسهای مجزا) را انتخاب کنید یا مسیر «تک-ذخیرهساز» (موتور یکپارچه).
معماری دوگانه (Dual-Store)
پیادهسازی GraphRAG روی Neo4j معمولاً از مسیر چند-ذخیرهساز پیروی میکند. توسعهدهنده از یک دیتابیس برداری مثل Pinecone، Chroma، Weaviate یا pgvector برای یافتن گرههای بذر استفاده میکند و سپس برای گسترش زیرگراف به Neo4j رجوع میکند.
جریان کار معمول به این صورت است: سؤال کاربر $
ightarrow$ تبدیل به بردار توسط OpenAI یا sentence-transformers $
ightarrow$ جستوجوی برداری top-k در Pinecone $
ightarrow$ بازیابی ID گرهها $
ightarrow$ اجرای پرسوجوی Cypher در Neo4j (مثلاً MATCH (n) WHERE n.id IN [...] -[*1..2]- ()) $
ightarrow$ تجمیع تکهها و زیرگراف $
ightarrow$ ارسال به بستر LLM.
در کد شبه-پایتون با LangChain، این روند چنین است:
# Step 1: vector search
seeds = pinecone.query(vector=embed(question), top_k=5)
seed_ids = [s['id'] for s in seeds]

# Step 2: graph traversal in Neo4j
cypher = """ MATCH (n:Chunk) WHERE n.id IN $ids MATCH (n)-[r*1..2]-(m) RETURN n, r, m """
subgraph = neo4j.run(cypher, ids=seed_ids)

# Step 3: feed to LLM
context = format_subgraph(subgraph)
response = openai.chat.completions.create(messages=[{"role": "user", "content": question + "\n\nContext:\n" + context}])
این الگو در مقیاس بالا چهار هزینه بحرانی ایجاد میکند:
- انحراف دادهها (Data Drift): هر گره در Neo4j باید یک بردار متناظر در دیتابیس برداری داشته باشد. اگر محتوای یک گره تغییر کند، هر دو ذخیرهساز باید بهروز شوند. مسیر نوشتن به یک فرآیند دو مرحلهای تبدیل میشود: ابتدا
pinecone.upsertو سپسneo4j.runبرای بهروزرسانی محتوا. چون تراکنشی بین دو دیتابیس مجزا وجود ندارد، اگر یکی موفق و دیگری شکست بخورد، انحراف داده رخ میدهد. تیمها اغلب به کارهای زمانبندی شده (Cron jobs) شبانه برای تطبیق دادهها متوسل میشوند که یک «مالیات» عملیاتی است. - سربار عملیاتی: چرخه پشتیبانی (On-call) شما باید دو توپولوژی خوشه متفاوت، دو استراتژی پشتیبانگیری، دو چرخه بهروزرسانی نسخه و دو مدل مدیریت دسترسی (IAM) را پوشش دهد. برنامه بازیابی از فاجعه (DR) شما باید هر دو خوشه را شامل شود و ارتقای نسخهها باید هماهنگ باشد.
- تأخیر شبکه: هر پرسوجو نیاز به چندین رفتوبرگشت دارد (اپلیکیشن $
ightarrow$ دیتابیس برداری $
ightarrow$ اپلیکیشن $
ightarrow$ Neo4j $
ightarrow$ اپلیکیشن). با فرض ۱۰ میلیثانیه برای هر گام، ۲۰ میلیثانیه تأخیر خالص پیش از فراخوانی LLM ایجاد میشود. این مورد با دستهبندی (Batching) قابل بهبود است، اما هزینهای است که در موتورهای یکپارچه حذف میشود. - تضاد طرحواره (Schema Divergence): منطق فیلتر کردن در یک دیتابیس برداری (مثل Pinecone) با فیلتر ویژگیها در Neo4j متفاوت است. هنگام اجرای پرسوجوهای ترکیبی (مثلاً «بردارهایی نزدیک به X و گرههایی متصل به Y»)، فیلترها در دو جای مختلف اتفاق میافتند و معناشناسی آنها همیشه یکسان نیست. در نتیجه، اپلیکیشن تبدیل به لایه ادغام میشود و اینجاست که باگها متولد میشوند.
جایگزین: موتورهای یکپارچه
موتورهای یکپارچه مثل SynapCores، جستوجوی برداری، پیمایش گرافی و SQL را در یک فایل اجرایی (Binary) واحد ادغام کردهاند. این کار جریان بازیابی را به یک پرسوجو و یک تراکنش واحد تبدیل میکند. در این معماری، برنامهریز (Planner) ترتیب عملیات را تعیین میکند — معمولاً ابتدا بذر برداری و سپس گسترش گرافی — و این عملیاتها را با هم ادغام میکند.
در یک سیستم یکپارچه، یک پرسوجوی GraphRAG میتواند بذرها را پیدا کرده و گراف را در یک مرحله با استفاده از SQLv2 گسترش دهد. برای مثال:
WITH seeds AS (
  SELECT id FROM chunks
  WHERE COSINE_SIMILARITY(embedding, EMBED(:question)) > 0.6
  ORDER BY similarity DESC LIMIT 5
)
SELECT c.body, n.label, e.type, m.label, m.props
FROM seeds s
GRAPH MATCH (n:Chunk {id: s.id})-[e*1..2]-(m:Entity)
ORDER BY n.recency DESC LIMIT 20;
این ساختار نیاز به کارهای تطبیق دادهها را حذف میکند چون تنها یک منبع حقیقت وجود دارد. علاوه بر این، این موتورها اغلب توابع داخلی مانند EMBED() و GENERATE() را دارند که تعداد رفتوبرگشتهای شبکه بین دیتابیس و LLM را کاهش میدهد و اجازه میدهد سه رفتوبرگشت به یک مورد تبدیل شود. همچنین از آموزش مدل در داخل دیتابیس از طریق توابع CREATE MODEL و PREDICT() پشتیبانی میکنند.
ماتریس تصمیمگیری برای تیمها
انتخاب مسیر درست به سرمایهگذاری فعلی و نیازهای خاص شما بستگی دارد:
| سیگنال | انتخاب Neo4j + دیتابیس برداری | انتخاب موتور یکپارچه |
|---|---|---|
| سرمایهگذاری فعلی | وابستگی عمیق به Neo4j (هزینه جابجایی زیاد است) | پروژه جدید (Greenfield) با قطعات متحرک کمتر |
| حجم کاری اصلی | گرافها غالب هستند؛ بردارها ویژگیهای جانبیاند | بردارها غالباند؛ گراف برای پرسوجوهای گاهبهگاه است |
| اولویت | نیاز به GDS بالغ (PageRank و غیره) | نیاز به GENERATE() و EMBED() در پرسوجوها |
| مهارت تیم | تیم دارای تجربه عملیاتی در دیتابیسهای گرافی است | تیم کوچک بدون تجربه عملیاتی در دیتابیسهای گرافی |
| الزام | هر دو بخش برداری و گرافی باید درجهیک باشند | هزینه همگامسازی بسیار بالاست؛ یک موتور واحد میخواهیم |
| بودجه عملیاتی | بودجه بالا برای مدیریت چندین خوشه | |
| بودجه عملیاتی | بودجه کم؛ ترجیح استقرار تک-فایلی |
منطق مهاجرت
برای تیمهایی که در حال حاضر از Neo4j استفاده میکنند، راهنما یک قانون مهاجرت عملگرایانه را پیشنهاد میکند: تنها زمانی به یک موتور یکپارچه مهاجرت کنید که هزینه نگهداری «مالیات همگامسازی» از هزینه مهاجرت بیشتر شود. هرگز برای ایدئولوژی مهاجرت نکنید.
- زمان مهاجرت: اگر گراف شما زیر ۱۰۰ میلیون گره است و حجم دادههای برداری کم است، یک موتور یکپارچه معمولاً ظرف یک فصل هزینهاش را جبران میکند. مقدار کدهایی که میتوانید از بخش همگامسازی حذف کنید، اغلب بیشتر از هزینه مهاجرت است.
- زمان ماندن: اگر گراف شما بسیار بزرگ و بومی است (به پیمایشهای عمیق، الگوریتمهای پیچیده یا وابستگی شدید به GDS نیاز دارد)، در Neo4j بمانید و یک دیتابیس برداری به آن اضافه کنید. در این حالت، مهاجرت به موتور یکپارچه ارزشش را ندارد.
- برای پروژههای جدید: با موتور یکپارچه شروع کنید. تنها در صورتی به Neo4j بروید که حجم کاری گراف شما از قابلیتهای موتور یکپارچه فراتر رود.
تحلیل عمیق: هر معماری کجا برنده است؟
Neo4j واقعاً زمانی برنده است که «گراف» همان حجم کاری اصلی باشد. این شامل گرافهای دانش در علوم زیستی، تحلیل شبکههای اجتماعی و نقشهبرداری زنجیره تأمین است، جایی که بُعد برداری اتفاقی و فرعی است. اگر متخصصان Cypher در تیم دارید، تکیه بر Neo4j باعث بهرهوری از آن تخصص میشود. توانایی کتابخانه GDS در اجرای تشخیص جوامع و الگوریتمهای مرکزیت در مقیاس بزرگ، توسط موتورهای یکپارچه جوانتر قابل رقابت نیست.
یک موتور یکپارچه واقعاً زمانی برنده است که «بارهای کاری هوش مصنوعی» (ترکیب بردارها + گرافها + LLMها) هدف اصلی باشند. این برای حافظه عاملها (Agent Memory) یا زمانی که GraphRAG ویژگی اصلی محصول است، ایدهآل است. وقتی میخواهید فراخوانیهای LLM در داخل پرسوجو باشد، تابع GENERATE() در SQL کل خط لوله را فشرده میکند. این انتخاب درستی برای تیمهای کوچک بدون بودجه عملیاتی اختصاصی برای دیتابیس گرافی است، زیرا اجرای یک موتور به طور معناداری ارزانتر از اجرای دو موتور است.
مقایسه پیادهسازی عملی
برای ملموستر شدن، الگوی GraphRAG قابل انتقال است. در یک استک دوگانه Neo4j، شما باید به صورت دستی مدیریت کنید: seeds = vector_db.search(embed(q), k=5) $
ightarrow$ subgraph = neo4j.run("MATCH (n) WHERE n.id IN $ids MATCH (n)-[*1..2]-(m) RETURN ...") $
ightarrow$ answer = llm.complete(format(subgraph)).
در یک موتور یکپارچه، این یک عملیات واحد است:
WITH seeds AS (
  SELECT id FROM chunks WHERE COSINE_SIMILARITY(embedding, EMBED(:q)) > 0.6 LIMIT 5
)
SELECT GENERATE('Answer using: ' || STRING_AGG(...))
FROM seeds s
GRAPH MATCH (Chunk {id: s.id})-[*1..2]-(m);
این تغییر نشاندهنده یک روند گستردهتر در زیرساختهای AI است. ما از سیلوهای «بهترین در نوع خود» (Best-of-breed) به سمت سیستمهای ادغامشدهای حرکت میکنیم که بردارها، گرافها و LLMها را به عنوان شهروندان درجهیک یک موتور واحد میبینند.
برای مشاهده این الگوها در عمل، توسعهدهندگان میتوانند با نسخه Community SynapCores آزمایش کنند. این نسخه اجازه پیادهسازی دستورالعملهای مختلف GraphRAG را میدهد، از جمله:
- تشخیص پولشویی چندگامی: استفاده از پیمایش گرافی برای تشخیص لایهبندی در AML.
- گرافهای دانش از صورتجلسات: ساخت مستقیم گراف از متن خام.
- تحلیل شعاع تخریب زنجیره تأمین: تحلیل اثرات روی روابط برای دیدن اینکه اگر یک تأمینکننده شکست بخورد، چه بخشهایی آسیب میبینند.
- گرافهای مشتری ۳۶۰ درجه: ترکیب بستر حساب کاربری با پروندههای مشابه حلشده برای پیشنهاد اقدام بعدی.
- توصیههای محصول: ترکیب دادههای خرید مشترک و معناشناسی برای فروش متقاطع در حالت Cold-start.
این موارد نشان میدهد که چگونه یک گام معنایی [:SIMILAR_TO] در ترکیب با رتبهبندی داخلی llm_score میتواند جایگزین یک استک پیچیده از چهار سیستم و یک شغل همگامسازی شود. تمام این الگوها در نسخه Community Edition v1.14.0-ce تأیید شدهاند.
گام بعدی شما
- اگر از معماری دوگانه استفاده میکنید، میزان زمان صرف شده برای رفع ناهماهنگی دادهها (Data Drift) را اندازهگیری کنید.
- در پروژههای جدید، ابتدا با یک موتور یکپارچه شروع کنید تا از پیچیدگیهای عملیاتی در ابتدای راه دور بمانید.
- قابلیتهای
GENERATE()داخلی را برای کاهش تأخیر شبکه در زنجیره بازیابی آزمایش کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو