تصور کنید یک سیستم هوش مصنوعی که تا دیروز تنها ۹ گزارش را پردازش کرده بود، ناگهان با ۱۷۸ گزارش همزمان روبرو شود و به جای مدیریت ترافیک، دادهها را فاسد کند. این حجم عظیم از دادهها که از یک دفترچه خاطرات در اپلیکیشن Polarsteps (مربوط به سفری از کانادا به شیلی) وارد شده بود، سیستم را به شدت تحت فشار قرار داد. این اتفاق دقیقاً همان چیزی است که در خط لولهی پردازش دادههای یک اپلیکیشن رخ داد و یک نقص معماری خطرناک را افشا کرد: سیستم، عدم پاسخگویی مدل را به عنوان یک حکم نهایی برای بررسی انسانی ثبت میکرد.
این مورد نشان میدهد که بخشهای «کسلکننده» زیرساخت هوش مصنوعی — یعنی صفها، اجارههای زمانی (Leases) و منطق تلاش مجدد — اغلب حیاتیتر از خودِ پرامپتها هستند. همانطور که در تحلیل قبلی ما دربارهی ارکستراتورهایی مثل LocalAI و vLLM اشاره کردیم، فراخوانی مستقیم مدلها در لحظهی درخواست، در مواجهه با حجم بالای داده منجر به محدودیت نرخ (Rate-limiting) و تخریب دائمی دادهها میشود. برای اکثر توسعهدهندگان، وسوسه این است که مدل LLM را مستقیماً در طول یک درخواست فراخوانی کنند، اما همانطور که این حادثه نشان داد، این کار در زمان انفجار دادهها منجر به مسدود شدن دسترسی و فساد دائمی دادهها میگردد. برای درک بهتر، مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اگر همزمان با هزاران درخواست بمباران شود، یا پاسخ نمیدهد یا پاسخهای ناقص میفرستد.
مکانیسم صف (The Mechanics of the Queue)
طبق مستندات فنی این پروژه، هر گزارش منتشرشده سه شغل پسزمینه متمایز را فعال میکند: نظارت بر متن (Text Moderation)، استخراج مکان (Place Extraction) و برای هر عکس، یک شغل نظارت بر تصویر (Image Moderation). هیچکدام از اینها در درخواست اولیه اجرا نمیشوند. در عوض، نویسنده دکمه انتشار را میزند، وضعیتی در ذخیرهساز تغییر میکند و یک تریگر (Trigger)، شناسههای شغل را در یک صف قرار میدهد. درخواست در عرض چند میلیثانیه به پایان میرسد زیرا فقط شناسهها را منتقل میکند — مثلاً «گزارش X را نظارت کن» یا «عکس Y را نظارت کن» — و نه متن کامل یا تصاویر سنگین را.
منطق کارگر و اجارهها (Worker Logic and Leases)
سیستم از یک کارگر (Worker) پسزمینه استفاده میکند که هر دقیقه بیدار شده و ۱۰ مورد از قدیمیترین شغلهای موجود در صف را پردازش میکند. این سرعت پردازش تصادفی نیست؛ بلکه نرخ مورد نیاز است تا سه نوع مختلف از شغلها بتوانند در محدوده بودجهی هر-دقیقه (Per-minute budget) مدل در سطح سرویس فعلی باقی بمانند. از آنجایی که هر نوع شغل از یک بودجه مشترک استفاده میکند، کارگر به سادگی قدیمیترین شغلها را، ده تا ده تا، پردازش میکند.
برای جلوگیری از گم شدن شغلها در صورت کرش کردن کارگر، سیستم از یک «اجاره ۵ دقیقهای» (Five-minute lease) استفاده میکند. وقتی یک کارگر شغلی را بر عهده میگیرد، این اجاره را تنظیم میکند. اگر کارگر در میانه پردازش بمیرد، اجاره منقضی شده و شغل دوباره برای سایر کارگرها قابل دریافت میشود. این ستون واحد در دیتابیس، هم به عنوان مکانیسم عقبنشینی برای تلاش مجدد (Retry backoff) و هم به عنوان سیستم بازیابی پس از کرش عمل میکند. پس از سه تلاش ناموفق، شغل به عنوان «شکستخورده» علامتگذاری و به یک مدیر انسانی ارجاع داده میشود.
هزینه انفجار دادهها (The Cost of the Burst)
به گزارش توسعهدهنده، وقتی ۱۷۸ گزارش وارد سیستم شد، صف دقیقاً طبق طراحی عمل کرد اما حجم زیاد دادهها یک گلوگاه (Bottleneck) ایجاد کرد. شش دقیقه پس از انتشار، یک کوئری وضعیت صف را به این صورت نشان داد:
- استخراج مکان (extract-places): ۲۸ مورد انجام شده، ۱۵۱ مورد در انتظار
- نظارت بر محتوا (moderate-content): ۲۷ مورد انجام شده، ۱۵۲ مورد در انتظار
- نظارت بر تصویر (moderate-image): ۰ مورد انجام شده، ۱۸ مورد در انتظار
با نرخ پردازش ۱۰ شغل در دقیقه، پاکسازی این حجم از داده بیش از نیم ساعت زمان برد. در این بازه، هر کاربر دیگری که مطلبی منتشر میکرد، مجبور بود پشت این صف طولانی منتظر بماند. اگرچه این تأخیر برای یک وارد کردن دادهی یکباره قابل قبول است، اما برای یک سایت زنده در یک روز شلوغ، مشکلساز میشد. راه حل شناخته شده — یعنی افزودن کارگر دوم یا رزرو بخشی از هر تیک زمانی برای هر نوع شغل — تنها زمانی پیادهسازی خواهد شد که صف دوباره نیاز به آن را ثابت کند. این چالشهای مربوط به زمانبندی و توالی پردازش، یادآور تلههای توالی در عاملهای هوش مصنوعی است که میتواند سرعت استنتاج کلی سیستم را به شدت کاهش دهد.
عیبیابی لاگها (Debugging the Logs)
در طول این انفجار دادهها، دو مورد در لاگها اشتباه به نظر میرسیدند اما در واقع بخشی از طراحی بودند. اول اینکه چهار شغل با وجود یک بار تلاش، همچنان «در انتظار» بودند؛ اینها صرفاً دستهای بودند که در آن لحظه تحت یک اجاره فعال در حال پردازش بودند. دوم اینکه لاگهای HTTP هر دقیقه یک خطای Timeout ۵ ثانیهای نشان میدادند. این اتفاق به دلیل اجرای Cron بود که کارگر را فراخوانی میکرد و پس از ۵ ثانیه از منتظر ماندن منصرف میشد، در حالی که خودِ کارگر تا ۶۰ ثانیه در حال پردازش بود. چون لاگ اجرای خودِ Cron هر دقیقه موفقیت را نشان میداد، توسعهدهنده متوجه شد که سیستم سالم است. این موضوع اهمیت بررسی تمام لاگها را پیش از ریاستارت کردن سرویسها برجسته میکند.
تلهی «نیاز به بررسی» (The 'Needs Review' Trap)
در حالی که صف برای گزارشهای جدید به درستی کار میکرد، یک مشکل عمیقتر در مورد تصاویر ظاهر شد. صبح روز بعد، دیوار عکسهای مدیر (Admin) حدود ۱۰۰ عکس را با وضعیت «نیاز به بررسی» (Needs Review) نشان میداد. در حالت عادی، این وضعیت یعنی مدل در مورد محتوا تردید داشته است؛ مثلاً یک کودک سوژه اصلی عکس باشد یا یک فضای خصوصی نامشخص در تصویر دیده شود.
اما بررسیها نشان داد ۹۸ مورد از این عکسها یک دلیل پنهان داشتند: «سرویس نظارت بر تصویر در دسترس نیست» (Image moderation service unavailable). این رشته متنی تنها زمانی توسط تابع نظارت بر تصویر تولید میشود که فراخوانی مدل در آخرین تلاش از سه تلاش مجدد شکست بخورد. چون سیستم، شکست خط لوله را در همان فیلد دیتابیسی ذخیره کرده بود که احکام مدل قرار میگرفت، این شکست به یک وضعیت دائمی تبدیل شد.
این شکستها در واقع هفتهها قبل و در زمان وارد کردن اولیه دادهها رخ داده بود، یعنی زمانی که هنوز سیستم صف وجود نداشت. در آن زمان، هر درج عکس مستقیماً یک فراخوانی به مدل ارسال میکرد. وارد کردن صدها عکس در چند دقیقه باعث شد مدل دسترسی را محدود (Rate-limit) کند. پس از سه بار رد شدن، هر عکس در وضعیت «نیاز به بررسی» پارک شد. وقتی تریگر انتشار هفتهها بعد فعال شد، سیستم فقط عکسهایی را در صف قرار داد که هنوز در وضعیت «در انتظار» بودند. این عکسهای شکستخورده قبلاً علامتگذاری شده بودند، بنابراین هرگز دوباره تلاش نشدند.
اصلاح و صورتحساب (The Fix and the Bill)
برای حل این بحران، توسعهدهنده یک مهاجرت (Migration) دیتابیس را پیادهسازی کرد تا «وضعیتهای شکست» از «احکام مدل» جدا شوند. اکنون در لحظه انتشار، هر عکسی که به دلیل شکست خط لوله متوقف شده و هنوز توسط انسان بررسی نشده است، به وضعیت «در انتظار» بازگشته و دوباره به صف فرستاده میشود. عکسی که مدل واقعاً درباره آن قضاوت کرده، دستنخورده باقی میماند. رشته متنی دلیل خطا، تنها راهی بود که این تفاوت را قابل تشخیص میکرد.
پس از بازگرداندن دستی ۹۸ عکس و ردیابی ۴۶۵ تصویر در صف، نتایج به این صورت بود:
- تأیید شده: ۴۳۲ مورد
- رد شده: ۹ مورد
- نیاز به بررسی: ۲۴ مورد
نکته مهم این است که هر یک از ۲۴ عکس «نیاز به بررسی»، اکنون دارای احکام واقعی مدل بودند: حضور کودکان به عنوان سوژه اصلی، افرادی که نمیدانستند از آنها عکس گرفته میشود، یک نمودار، یا خانهای تزیین شده برای تعطیلاتی که مدل نتوانست آن را به عنوان یک عکس سفر شناسایی کند. دیگر هیچ عکسی عبارت «سرویس در دسترس نیست» را نداشت.
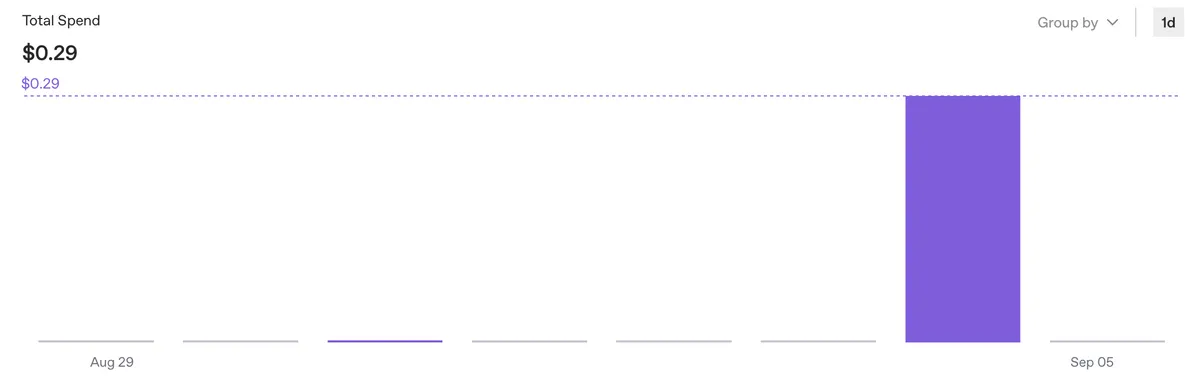
به طور شگفتانگیزی، هزینه مالی این انفجار عظیم دادهها ناچیز بود. کل صورتحساب مدل برای آن روز — شامل ۱۷۸ گزارش برای نظارت متنی و استخراج مکان، و ۴۶۵ عکس برای نظارت تصویری (با احتساب تمام تلاشهای مجدد) — تنها ۰.۲۹ دلار بود. در روز قبل از آن، هزینه کسری از یک سنت بود. این بهرهوری به دلیل استفاده از یک مدل «مینی» (Mini model) و پرهیز از پرامپتهای استدلالی پیچیده حاصل شد. این رویکرد بهینهسازی در لایهی مدل، مشابه استراتژیهایی است که در معماری MyVitals برای جابهجایی سریع میان مدلها به کار گرفته شده تا وابستگی به یک مدل خاص کاهش یابد.
نظارت بر خط لوله (Monitoring the Pipeline)
برای جلوگیری از نقاط کور در آینده، توسعهدهنده یک پنل خط لوله (Pipeline panel) به رابط مدیریت اضافه کرد. این داشبورد شغلها را بر اساس نوع ردیابی میکند و نشان میدهد چه تعداد در انتظار هستند، در حال اجرا هستند، در ساعت گذشته به پایان رسیدهاند یا در روز گذشته شکست خوردهاند. این پنل یک بهروزرسانی تکخطی ارائه میدهد، مثلاً: «در حال اجرا · ۱۳۱ مورد منتظر، قدیمیترین ۱۲ دقیقه، آخرین فعالیت ۲۰ ثانیه پیش»، یا اگر کاری در انتظار باشد اما برای سه دقیقه هیچ شغلی دریافت نشده باشد، عبارت «در حال اجرا نیست؟» را نمایش میدهد. همچنین ۱۰ شکست آخر را به همراه متن خطا لیست میکند.
این شفافیت، یک قطعی احتمالی را به یک تجربه یادگیری تبدیل کرد. با اطمینان از اینکه هر شکست ردی از قابل خواندن در جایی که توسعهدهنده به طور منظم بررسی میکند بر جای میگذارد، این انفجار دادهها به یک درس تبدیل شد. سایت Back From My Trip همچنان گزارشهایی را میزبانی میکند که با یک سوال ساده به پایان میرسند: «آیا دوباره به آنجا برمیگردم؟»
گام بعدی شما
- اگر از فراخوانی مستقیم API مدلها در اپلیکیشن خود استفاده میکنید، فوراً یک سیستم صف (Queue) و تلاش مجدد (Retry) پیادهسازی کنید.
- وضعیتهای «خطای سیستمی» (مانند Timeout) را هرگز با «پاسخ مدل» (مانند Needs Review) در یک ستون دیتابیس ذخیره نکنید.
- برای کاهش هزینهها و افزایش سرعت در کارهای ساده مثل نظارت بر محتوا، به جای مدلهای بزرگ از مدلهای Mini یا SLM استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو