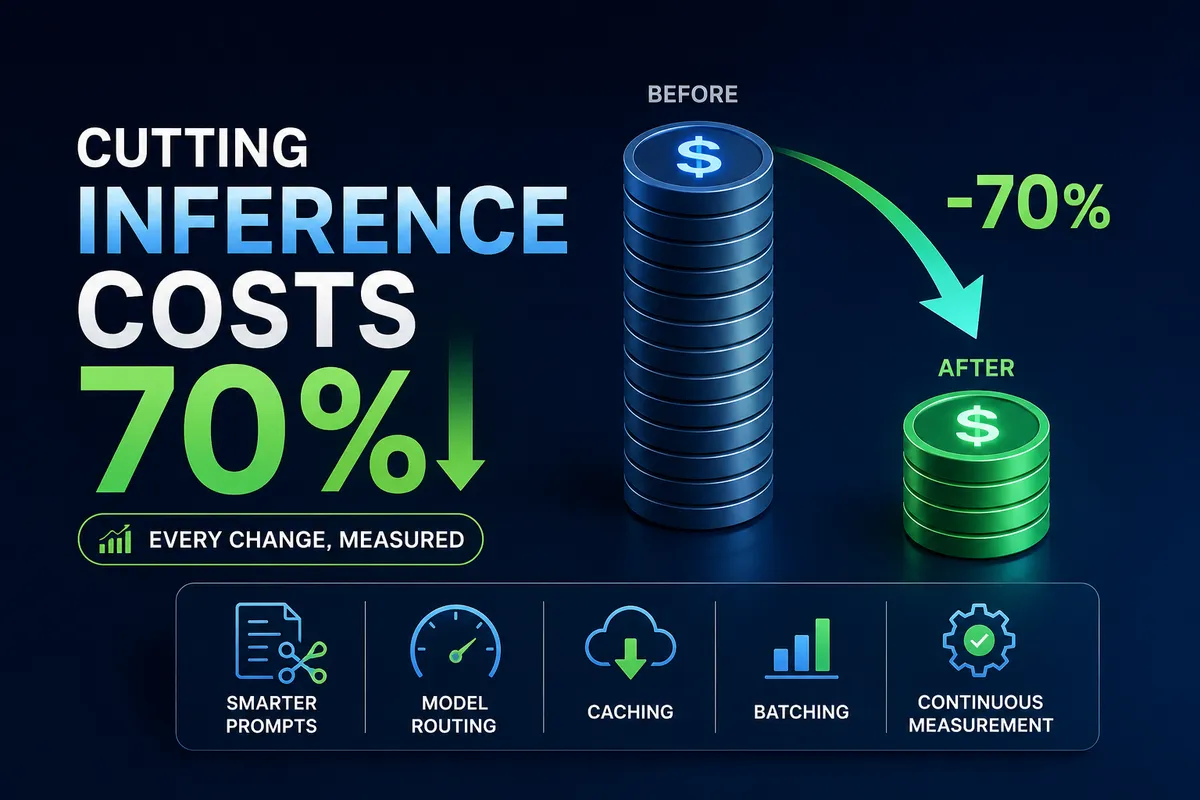
تصور کنید صورتحساب ماهانه استنتاج مدلهای زبانی شما از ۱۰,۰۰۰ دلار به ۳,۰۰۰ دلار سقوط کند. این کاهش ۷۰ درصدی هزینه، نتیجهی جایگزینی یک مدل با مدلی ارزانتر نبود، بلکه حاصل نگاه به استنتاج به عنوان یک مسئله مهندسی سیستمها است. به نقل از راهنمای فنی منتشر شده در dev.to در ۲۷ اوت ۲۰۲۶، کلید این بازسازی سیستماتیک، اندازهگیری هر تغییر در برابر یک خط مبنای کیفی سختگیرانه بود.
بسیاری از شرکتها برای کاهش هزینههای هوش مصنوعی، صرفاً به سراغ ارائهدهندگان ارزانتر یا مدلهای کوچکتر میروند. این رویکرد معمولاً شکست میخورد چون «هزینه واقعی یک وظیفه موفق» را نادیده میگیرد. توکن ارزانقیمت اگر منجر به سه بار تلاش مجدد یا رد شدن در تست کیفیت شود، در واقع هزینه نهایی هر خروجی موفق را افزایش میدهد.
برای حل این مشکل، تیم مذکور معیاری به نام «هزینه هر وظیفه موفق» (Cost per Successful Task) را پیاده کرد. این تغییر باعث شد تمرکز از قیمت ارائهدهنده به بهرهوری عملیاتی منتقل شود. فرمول مورد استفاده این بود: کل هزینه استنتاج تقسیم بر تعداد وظایف تکمیلشده با موفقیت. هر بهینهسازی باید دو شرط را همزمان برآورده میکرد: هزینهها باید کاهش یابند در حالی که کیفیت ثابت بماند. اگر کیفیت بهشدت افت میکرد، آن تغییر به عنوان یک بهینهسازی موفق پذیرفته نمیشد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی زیرساختهای مدلهای زبانی اشاره کردیم، بدون داشتن دادههای دقیق، هر ادعایی درباره صرفهجویی تنها یک حدس است، نه یک نتیجه مهندسی.
گام ۰: ایجاد خط مبنای اندازهگیری
تیم پیش از هر اقدامی، خط لوله خود را برای ثبت هر درخواست تجهیز کرد. آنها در کمترین حالت، یک شیء JSON شامل شناسه درخواست (request_id)، ویژگی (مثلاً "support_assistant")، مدل، توکنهای ورودی، توکنهای خروجی، توکنهای کششده، تأخیر بر حسب میلیثانیه (latency_ms)، هزینه تخمینی و یک مقدار بولی برای موفقیت (success boolean) ثبت کردند.
این دادهها بر اساس موارد زیر تجمیع شدند:
- مدل و ویژگی
- نقطه انتهایی (Endpoint) و مشتری
- نوع درخواست
- نسخه پرامپت
ردیابی نسخه پرامپت بهطور غافلگیرکنندهای مفید بود؛ چرا که تیم میتوانست ببیند آیا تغییر در یک دستور خاص باعث جهش ۲۰ درصدی هزینهها شده است یا خیر. این دادهها به یک داشبورد مفهومی تبدیل شد که تأخیر P50/P95، نرخ命中 کش (Cache Hit Rate)، توزیع مدلها و نمرات کیفیت را رصد میکرد.
معیارهای داشبورد
برای عبور از حدس و گمان، شاخصهای کلیدی عملکرد (KPI) زیر در داشبورد هزینه LLM رصد شدند:
- تعداد کل درخواستها
- توکنهای ورودی و خروجی
- توکنهای کششده
- هزینه هر درخواست
- هزینه هر وظیفه موفق
- تأخیر P50 / P95
- نمره کیفیت
- نرخ命中 کش
- توزیع مدلها
بدون این مبنا، هرگونه ادعای صرفهجویی — مانند اینکه «کش کردن پرامپت باعث صرفهجویی شد» — یک فرض است و نه یک نتیجه مهندسی. تیم از این دادهها برای شناسایی دقیق نقاطی که توکنها در نسخههای مختلف پرامپت و نقاط انتهایی مختلف هدر میرفتند، استفاده کرد.
تغییر ۱: پاکسازی پرامپت و زمینه
اولین هدف، پرامپتها بودند. پرامپتهای محیط تولید معمولاً بهصورت ارگانیک رشد میکنند و دستورات تکراری و مستندات بیش از حد در آنها جمع میشود. با حذف دستورات موازی — مثلاً جایگزینی چهار عبارت مختلف برای «مختصر بنویس» (مانند «پاسخهای بیش از حد طولانی تولید نکن»، «پاسخ خود را کوتاه نگه دار»، «از توضیحات اضافی پرهیز کن») با یک دستور صریح مانند «مگر در صورت درخواست کاربر برای جزئیات، پاسخ را مختصر بنویس» — هزینه ۱۱٪ کاهش یافت و مبلغ ماهانه از ۱۰,۰۰۰ دلار به ۸,۹۰۰ دلار رسید.
آنها همچنین ارسال تاریخچه کامل گفتگوها را متوقف کردند. بهجای یک پیادهسازی ساده که در آن messages = entire_conversation_history بود، فیلترگذاری بر اساس ارتباط و خلاصهسازی را پیاده کردند. در گفتگوهای طولانی، آنها تاریخچه ۲۰ پیامی را به ۶ پیام کاربردی کاهش دادند و سپس به مدل ارسال کردند. این کار علاوه بر کاهش هزینه، از حواسپرتی مدل به دلیل زمینههای قدیمی و منقضی شده جلوگیری کرد. این چالش با محدودیتهای عملیاتی پنجرههای متنی بزرگ مرتبط است که نشان میدهد افزایش حجم زمینه لزوماً به معنای بهبود کیفیت نیست.
در سیستمهای تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — آنها از بازیابی ساده «۲۰ مورد برتر» (top-k=20) به یک خط لوله پیشرفتهتر رفتند:
- بازیابی کاندیدها
- بازرتبهبندی (Reranking) نتایج
- انتخاب تنها تکههایی که حاوی پاسخ هستند
- ساخت زمینه فشرده
- تولید پاسخ
منطق بهینهسازی RAG
آنها دریافتند که چسباندن ساده ۲۰ سند بازیابیشده به یک رشته متنی واحد، «ماشین توکنساز» ایجاد میکند که حجم عظیمی از متنهای نیمهمرتبط را ارسال میکند. هدف از «ارائه حداکثری زمینه» به «ارائه شواهد کافی» تغییر یافت.
تغییر ۲: کنترل طول خروجی
توکنهای خروجی اغلب به اندازه ورودیها گران هستند. برای وظایف ساختاریافته، تیم مدل را مجبور کرد تا فقط JSON یا برچسبهای مورد نیاز را برگرداند. برای مثال، اگر وظیفه فقط تعیین دستهبندی و اولویت بود، آنها صراحتاً به مدل دستور دادند که فقط شیء JSON را برگرداند و از نوشتن توضیحات پنج پارگرافی پرهیز کند.
محدودیتهای خاص عبارت بودند از:
- خلاصهها: حداکثر ۵ مورد گلولهای (Bullet points).
- استخراج: فقط خروجی JSON.
- مسیریابی: فقط یک برچسب.
با ممنوع کردن تولید متن اضافی برای وظایف ساده طبقهبندی، هزینهها ۱۰.۵٪ دیگر کاهش یافت و مجموع به ۷,۹۵۰ دلار رسید. اصل راهنما این بود: ارزانترین توکن، توکنی است که تولید نشود.
تغییر ۳: استراتژیهای کشینگ
بسیاری از درخواستها دارای پرامپتهای سیستمی، تعاریف ابزار، سیاستها، طرحها (Schemas) و مثالهای یکسان بودند. تیم کش کردن پرامپت (Prompt Caching) را برای استفاده مجدد از این پیشوندهای بزرگ و ثابت پیاده کرد. در درخواستی با ۸,۰۰۰ توکن زمینه سیستمی مشترک و ۱۵۰ توکن پرسش کاربر، کشینگ اجازه میدهد پیشوند پردازششده برای تمام درخواستهای بعدی سازگار بازاستفاده شود. برای مدیریت بهینه این حجم از توکنها در جریانهای طولانی، تکنیکهایی مانند حفظ توکنهای کلیدی برای پایداری استنتاج میتوانند مکمل راهکارهای کشینگ باشند.
علاوه بر سطح API، آنها کشینگ در سطح اپلیکیشن را برای وظایف قطعی (Deterministic) اضافه کردند. با هش کردن درخواستهای نرمالشده، نتایج کششده برای طبقهبندیهای تکراری بازگردانده میشد. با این حال، آنها اشاره کردند که این کار نیازمند مدیریت سختگیرانه موارد زیر است:
- مجوزهای دادههای خاص هر کاربر
- تازگی دادهها (Data Freshness)
- نسخههای مدل و پرامپت
- نسخههای پایگاه دانش
آنها هشدار دادند که یک پاسخ کششده اشتباه یا غیرمجاز، بدتر از یک پاسخ گرانقیمت است. این مرحله هزینه را به ۶,۸۵۰ دلار (کاهش کلی ۳۱.۵٪) رساند.
تغییر ۴: مسیریابی بر اساس پیچیدگی
این مهمترین تغییر معماری بود. بهجای ارسال هر درخواست به قدرتمندترین مدل، مسیریابی (Router) برای دستهبندی وظایف بر اساس پیچیدگی ساختند. آنها برای هر دسته، مجموعههای ارزیابی ایجاد کردند تا ارزانترین مدلی که بهطور قابلاعتمادی آستانه کیفیت را رد میکند، بیابند.
- وظایف ساده (تشخیص قصد، استخراج ساده، طبقهبندی) $\rightarrow$ مدل کوچک
- وظایفی با پیچیدگی متوسط (آنهایی که زیر یک آستانه پیچیدگی خاص هستند) $\rightarrow$ مدل میانرده
- وظایف پیچیده (مانند تحلیل تعهدات متناقض قراردادی) $\rightarrow$ مدل قدرتمند
این مسیریابی بر اساس ارزیابیهای تجربی بود، نه شهود. سوال این نبود که «هوشمندترین مدل کدام است؟»، بلکه «ارزانترین مدلی که بهطور قابلاعتمادی این کار را درست انجام میدهد کدام است؟». این چرخش هزینه را ۲۳.۵٪ دیگر کاهش داد و مبلغ ماهانه به ۴,۵۰۰ دلار رسید.
تغییر ۵: الگوی ارتقاء (Escalation)
برای بهینهسازی بیشتر، گردش کار ارتقاء را معرفی کردند. بهجای شروع با یک مدل گرانقیمت، ابتدا یک مدل کوچک وظیفه را امتحان میکرد. اگر یک اعتبارسنج (Validator) خروجی را نامعتبر (مثلاً عدم تطابق با Schema) یا کماعتماد تشخیص میداد، درخواست به مدلی قدرتمندتر ارتقاء مییافت.
این کار تضمین کرد که مدل گرانقیمت فقط «دمِ دشوار» (Difficult Tail) درخواستها را مدیریت کند. تیم تأکید کرد که بدون یک اعتبارسنج قابلاعتماد، این الگو میتواند بهطور نامحسوس صرفهجویی در هزینه را به افت کیفیت تبدیل کند.
تغییر ۶: جایگزینی مدلها با کد
برخی ویژگیها صرفاً چون «شبیه هوش مصنوعی» بودند، با LLM پیاده شده بودند. تیم متوجه شد بسیاری از فراخوانیهای احتمالی باید به کدهای قطعی تبدیل شوند. مثالها:
- فرمت تاریخ: استفاده از
datetime.strptime(...)بهجای مدل زبانی. - اعتبارسنجی JSON: استفاده از JSON schema validator.
- محاسبه قیمت: استفاده از منطق اپلیکیشن.
- دسترسیها: استفاده از سرویس Authorization.
- جستجوی ID: استفاده از کوئری دیتابیس.
- استخراج ساده: استفاده از Regex یا پارسر.
جایگزینی اینها با نرمافزارهای استاندارد، هزینه این فراخوانیهای خاص را به صفر رساند. قانون جدید این شد: از مدل زبانی زمانی استفاده کنید که مسئله نیاز به درک یا تولید زبان دارد، نه صرفاً چون مدل میتواند آن را حل کند.
تغییر ۷: دستهبندی (Batching) بارهای کاری آفلاین
هر درخواستی نیاز به پاسخ آنی ندارد. تیم بارهای کاری تعاملی (چت، جستجو، کوپایلوتها) را از کارهای آفلاین جدا کرد. کارهای آفلاین شامل موارد زیر بود:
- طبقهبندیهای شبانه
- غنیسازی اسناد
- خلاصههای آفلاین
- اجراهای ارزیابی (Evaluation runs)
- خط لولههای استخراج انبوه و تحلیل
با انتقال اینها به پردازش دستهای (Batch Processing)، بهجای تأخیر، روی توان عملیاتی (Throughput) بهینهسازی کردند. برای استنتاجهای میزبانیشده شخصی، این کار باعث افزایش بهرهوری شتابدهندهها شد و برای APIها، امکان استفاده از قیمتگذاریهای مخصوص Batch را فراهم کرد. این کار هزینه را به ۳,۷۵۰ دلار رساند.
تغییر ۸: تنظیمات سطح زیرساخت
برای اجزای میزبانی شخصی، آنها مسیریابی آگاه از پیشوند (Prefix-aware routing) را بررسی کردند. با ارسال درخواستهای دارای پیشوندهای مشترک به یک Worker واحد، استفاده از KV-Cache به حداکثر رسید و از پردازش تکراری در سرورهای مختلف جلوگیری شد. این اقدام، بهینهسازی هزینه را از یک دغدغه اپلیکیشن به یک دغدغه زیرساخت سرویسدهی تبدیل کرد.
آنها همچنین کوانتایزیشن (Quantization) — یعنی تبدیل دقت مدل از FP16/BF16 به FP8، INT8 یا INT4 — را به عنوان یک آزمایش دیدند. آنها بهجای پذیرش پیشفرض، کیفیت، تعداد توکن در ثانیه، زمان تا اولین توکن (TTFT) و توان عملیاتی حافظه را بنچمارک کردند و اشاره کردند که دقت پایینتر لزوماً به معنای بهترین بهرهوری کلی نیست.
تغییر ۹: تولید با آگاهی از بودجه
در نهایت، هزینه را به یک محدودیت معماری تبدیل کردند و برای هر ویژگی بودجه توکن مشخصی تعیین کردند. یک شیء CostBudget حداکثر توکنهای ورودی، حداکثر توکنهای خروجی، مدل ترجیحی و اجازه ارتقاء را تعریف میکرد.
- طبقهبندی قصد: بودجه بسیار کم.
- پاسخ پشتیبانی: بودجه متوسط.
- تحلیل اسناد پیچیده: بودجه بالا.
این اقدام مانع از جهش ناگهانی صورتحساب توسط یک ویژگی خاص شد و هزینه نهایی را به حدود ۳,۰۰۰ دلار رساند؛ یعنی کاهش ۷۰ درصدی.
نتیجه تجمیعی
صرفهجوییها بهصورت ترکیبی روی خط مبنا اثر گذاشتند و نه بهصورت خطی. روند به این صورت بود:
- خط مبنا: ۱۰,۰۰۰ دلار
- پاکسازی پرامپت/زمینه: ۸,۹۰۰ دلار (۱۱٪ کاهش)
- کنترل خروجی: ۷,۹۵۰ دلار (۲۰.۵٪ کاهش کلی)
- کشینگ: ۶,۸۵۰ دلار (۳۱.۵٪ کاهش کلی)
- مسیریابی مدل: ۴,۵۰۰ دلار (۵۵٪ کاهش کلی)
- دستهبندی (Batching): ۳,۷۵۰ دلار (۶۲.۵٪ کاهش کلی)
- بودجه و سایر بهینهسازیها:
۳,۰۰۰ دلار (۷۰٪ کاهش کلی)
تحلیل: چرخش به سمت مهندسی سیستمها
این رویکرد ثابت میکند که کاهش هزینه استنتاج، یک مسئله «انتخاب مدل» نیست، بلکه یک مسئله «طراحی سیستم» است. خطرناکترین راه برای کاهش هزینه، تخریب کیفیت محصول است؛ تنها راه پایدار، حذف اتلافات است.
برای توسعهدهندگان، این یعنی واحد ارزش «وظیفه موفق» است، نه توکن. سناریویی را در نظر بگیرید که در آن مدل A با هزینه ۰.۰۰۴ دلار هر درخواست و نرخ موفقیت ۷۰٪ عمل میکند، در حالی که مدل B با هزینه ۰.۰۰۶ دلار و نرخ موفقیت ۹۸٪ است. نگاه کردن صرف به هزینه درخواست، مدل A را ارزانتر نشان میدهد، اما تلاشهای مجدد و دخالت انسانی باعث میشود مدل B انتخاب اقتصادیتری باشد.
محدودیتهای کیفیت و ارزیابی
برای تضمین اینکه کیفیت یک محدودیت سخت باقی بماند، هر آزمایش از این مسیر عبور کرد: تغییر کاندید $\rightarrow$ ارزیابی آفلاین $\rightarrow$ تست سایه (Shadow Test) $\rightarrow$ کاناری $\rightarrow$ تولید. معیارهای ارزیابی بسته به ویژگی متفاوت بود:
- استخراج ساختاریافته: دقت فیلدها، اعتبار Schema و نرخ فیلدهای گمشده.
- RAG: کیفیت بازیابی، صحت پاسخ، مستند بودن (Groundedness) و پشتیبانی از ارجاعات.
- پشتیبانی: کیفیت حل مسئله، نرخ ارتقاء و بازخورد کاربر.
- عاملها (Agents): تکمیل وظیفه، دقت فراخوانی ابزار، تعداد گامها در هر وظیفه و هزینه هر وظیفه موفق.
آنچه اثر نکرد
هر آزمایشی موفق نبود. تیم دریافت که کوچک کردن کورکورانه پرامپتها در نهایت منجر به حذف اطلاعات حیاتی و کاهش بازدهی شد. همچنین ارسال همه چیز به مدلهای بسیار کوچک، زمانی که حجم کار از توان مدل فراتر رفت، شکست خورد. کشینگ معنایی تهاجمی برای دادههای مالی، اطلاعات خاص کاربر و پاسخهای حساس به زمان خطرناک بود. در نهایت، کاهش شدید k-top در RAG روی کاغذ خوب به نظر میرسید اما باعث افت پوشش بازیابی شد.
برای پیادهسازی این استراتژی، ابتدا خط لوله خود را برای رصد «هزینه هر وظیفه موفق» تجهیز کنید. وقتی خط مبنا را داشتید، ابتدا اتلافات آشکار در پرامپتها و طول خروجی را حذف کنید و سپس به سراغ مسیریابی پیچیده و دستهبندی بروید. معماری نهایی باید از یک جریان ساده «کاربر $\rightarrow$ پرامپت $\rightarrow$ مدل» به یک خط لوله پیشرفته تبدیل شود که شامل ثبت هزینه، بررسی نیاز به LLM، بررسی کش، مسیریابی پیچیدگی و ارتقاء بر اساس اعتبارسنجی باشد.
گام بعدی شما
- ابتدا خط لوله خود را برای رصد «هزینه هر وظیفه موفق» تجهیز کنید تا نقاط هدررفت را بیابید.
- دستورات تکراری پرامپتها را حذف کرده و خروجیهای مدل را به فرمتهای فشرده (مانند JSON خالص) محدود کنید.
- یک مسیریاب (Router) ساده برای تفکیک وظایف «ساده» از «پیچیده» پیاده کنید تا از مدلهای کوچکتر برای کارهای روتین استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازیهای سطح سیلیکون مراجعه کنید.



گفتگو