تصور کنید قانونی حیاتی که یک بار به عامل هوش مصنوعی دیکته کردهاید، بهسادگی ناپدید شود چون سیستم تصمیم گرفته گفتگوهای اخیر را به حقایق دائمی ترجیح دهد. این آسیبپذیری در مجموعهای از آزمایشهای منتشرشده در ۶ اکتبر ۲۰۲۶ توسط توسعهدهندهای به نام TheusP افشا شد؛ او نشان داد سیاستهای رایج «زوال حافظه» که برای خلوت نگه داشتن پنجره متنی طراحی شدهاند، اغلب مهمترین دستورالعملهای یک پروژه را بهاشتباه حذف میکنند.
بسیاری از عاملها در واقع چیزی را «به یاد نمیآورند»، بلکه به سامانههای خارجی برای ذخیره داده و تزریق آنها به پرامپت متکی هستند. یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بعد از هر فراخوانی همه چیز را فراموش میکند. این تفاوت در نحوه پردازش دادهها نشان میدهد که چرا معماری تولید محتوا با معماری اجرای عملیات در عاملهای هوش مصنوعی تفاوت بنیادینی دارد. وقتی یک عامل «به یاد میآورد» که پروژه از pytest استفاده میکند، در واقع یک سیستم خارجی این حقیقت را بازیابی کرده و در پرامپت قرار داده است. این فرآیند که حافظهٔ عامل (Agent Memory) نام دارد، معمولاً شامل چرخهای از نوشتن، ذخیره، جستوجو و فراموش کردن است.
چرخه حافظه
- نوشتن: سیستم تصمیم میگیرد آیا یک پیام ارزش ذخیره شدن دارد یا خیر، در چه قالبی ذخیره شود و چه متادیتایی (دادههای توصیفی) همراه آن باشد.
- ذخیره: دادهها بهصورت متن همراه با یک بردار معنایی (Embedding) — که برداری از اعداد است و معنای متن را نمایندگی میکند — و متادیتایی شامل منبع، تاریخ، سطح اعتماد و میزان استفاده ذخیره میشوند.
- جستوجو: با رسیدن پرسش جدید، سیستم بر اساس شباهت معنایی و فضای موجود در پنجره متنی، حافظههای مرتبط را مییابد.
- فراموش کردن: بهطور موازی، سیستم اطلاعات قدیمی را جایگزین میکند، رتبه آنها را پایین میآورد یا آنها را به آرشیو منتقل میکند.
وقتی این چرخه شکست میخورد، عاملها دچار «تضادهای کاذب» میشوند؛ وضعیتی که در آن دو حقیقت معتبر اما متفاوت (مثلاً «استفاده از pytest در بکاند» و «vitest در فرانتاند») بهاشتباه بهعنوان تضاد تلقی شوند. همچنین پدیده «مقادیر منسوخ» رخ میدهد که در آن اطلاعات قدیمی و غلط، بر حقایق جدید غلبه کرده و جایگزین آنها میشوند.
مکانیسمهای جستوجو
جستوجو در این سیستمها تقریباً همیشه معنایی (Semantic) است. در این پیادهسازی، مدل bge-m3 بردارهای معنایی متشکل از ۱۰۲۴ عدد تولید میکند که معنای متن را نمایش میدهند. برای سنجش فاصله بین این بردارها از شباهت کسینوسی (Cosine Similarity) استفاده میشود: عددی نزدیک به ۱ نشاندهنده شباهت بسیار بالا و عدد ۰ نشاندهنده عدم ارتباط کامل است.
در عمل، سیستم پرسش کاربر را به یک بردار تبدیل کرده و نتایج «k-برتر» (top-k) یا همان مشابهترین نتایج را بازیابی میکند. یک یافته کلیدی در این آزمایشها این بود که بردارهای معنایی مدرن، اغلب هر چیزی را که در یک موضوع کلی باشد «تا حدی مرتبط» میبینند. برای مثال، در یک پرسش درباره یک git push ردشده، حافظههای واقعاً مرتبط نمرهای بین ۰.۶ و ۰.۶۶ گرفتند، در حالی که جملات کاملاً بیربط همچنان نمرهای در حدود ۰.۵ کسب میکردند.
انواع حافظه و متاداده
با الهام از مفاهیم روانشناسی، این سیستم حافظهها را به سه نوع تقسیم میکند:
- رویدادی (Episodic): ثبت اینکه چه اتفاقی افتاد (مثلاً: «اصلاحیه سرویس پرداخت در us-east-1 آپلود شد»).
- معنایی (Semantic): حقیقتی که تا زمان تغییر، درست میماند (مثلاً: «سرویس پرداخت در sa-east-1 اجرا میشود»).
- رویهای (Procedural): قانونی درباره نحوه عمل و رفتار (مثلاً: «هرگز روی شاخه main فورسپوش نکن»).
هر رکورد حافظه شامل متادیتای دقیقی است تا سیاستهای سیستم بتوانند تصمیم بگیرند: content (محتوا)، kind (نوع)، source (منبع: کاربر، خروجی ابزار، استنتاج عامل یا وب)، trust (سطح اعتماد از ۱.۰ برای کاربران تا ۰.۳ برای وب)، created_at (تاریخ ایجاد)، last_used_at (آخرین استفاده)، use_count (تعداد دفعات استفاده)، subject_key (کلید موضوعی، مثلاً payment_service.region) و tier (سطح: داغ، سرد یا قرنطینه).
برای حل مشکل شکست حافظه، TheusP چهار سیاست مختلف را با استفاده از SQLite به همراه افزونه sqlite-vec و مدل جاسازی bge-m3 پیاده کرد. هدف این بود که مشخص شود استراتژیهای مختلف «فراموشی» چگونه بر توانایی عامل در دنبال کردن تکامل یک پروژه طی ۸ هفته شبیهسازی شده اثر میگذارد.
چهار استراتژی حافظه
- سیاست ساده (Naive): هر پیام بهسادگی به یک حافظه رویدادی تبدیل میشود. سیستم فقط ۵ مورد از مشابهترین حافظهها را بازیابی میکند. این روش با انباشت نویز شکست میخورد، زیرا نویزها قوانین نادر اما حیاتی را دفن میکنند.
- سیاست کلید-موضوع (Subject-Key): یک LLM حقایق خاص را با کلیدهای مشخص (مثلاً
payment_service.region) استخراج میکند. اگر مقدار جدیدی برای یک کلید موجود برسد، سیستم سطح اعتماد را بررسی میکند. اگر مقدار جدید مورد اعتمادتر باشد یا مقدار فعلی تهی (null) باشد، حافظه قدیمی غیرفعال شده (active = False) و مقدار جدید جایگزین آن میشود. این کار از همزیستی حقایق متناقض جلوگیری میکند. - سیاست زوال رتبهبندی (Ranking Decay): این روش یک نمره «تازگی» به جستوجو اضافه میکند. نمره نهایی ترکیبی است از:
0.55 * similarity + 0.20 * recency + 0.20 * confidence + 0.05 * usage. تازگی با استفاده از مفهوم «نیمهعمر» محاسبه میشود (۳۰ روز برای رویدادها و ۱۸۰ روز برای حقایق/قوانین). اگرچه این روش نویزهای قدیمی را حذف میکند، اما قوانین قدیمی که هنوز معتبر هستند را نیز جریمه میکند. - سیاست زوال لایهای (Tiered Decay): بهجای کاهش نمره، حافظههای قدیمی و بدون استفاده از طریق یک بررسی دورهای به لایه «سرد» منتقل میشوند. سیستم ابتدا لایه «داغ» را جستوجو میکند و تنها در صورتی به لایه سرد میرود که لایه داغ کمتر از ۳ حافظه با نمره شباهت بالای ۰.۳۵ برگرداند.
شکست مفهوم «تازگی»
در این آزمایشها از مدل qwen2.5:7b بهعنوان LLM اصلی استفاده شد. شبیهسازی شامل ۸ هفته گفتگو با سطوح مختلف نویز (از ۳۶ تا ۸۱۲ پیام کل) بود. یک قانون خاص — «هرگز روی main فورسپوش نکن» — در هفته اول معرفی شد.
با رشد گفتگو، نرخ بازیابی این قانون در سیاست ساده از ۱۰۰٪ (در ۳۶ پیام) به ۰٪ (در ۴۱۲ و ۸۱۲ پیام) سقوط کرد. دلیل این اتفاق قدیمی بودن قانون نبود، بلکه نویزهای مشابه (مثلاً «یک فورسپوش روی شاخه شخصیام انجام دادم») جایگاه ۵ مورد برتر را اشغال کرده بودند.
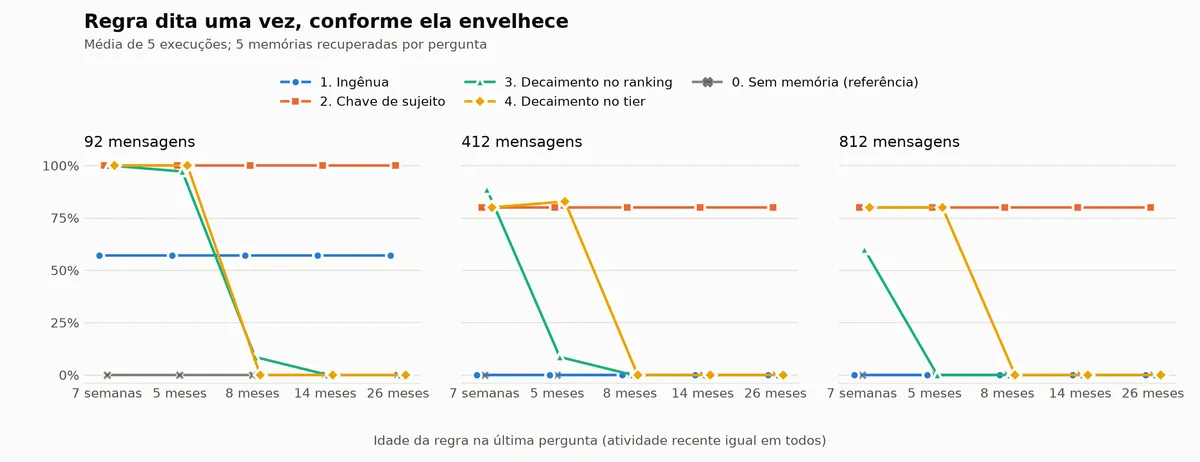
شگفتانگیزتر از آن، اثر زوال بود. در سیاست زوال رتبهبندی، نرخ بازیابی این قانون زمانی که قانون ۱۴ ماهه شد، به ۰٪ رسید. سیستم «قدیمی بودن» را با «بیربط بودن» یکی دانست؛ این ثابت کرد که یک قانون رویهای که یک بار گفته شده، بهطور همزمان هم قدیمی و هم حیاتی است.
تله «لایه سرد»
سیاست زوال لایهای قرار بود امنتر باشد، اما به دلیل ماهیت بردارهای معنایی شکست خورد. چون bge-m3 اغلب به هر چیزی که بهطور مبهم با موضوع مرتبط باشد نمرهای بالای ۰.۳۵ میدهد، لایه «داغ» همیشه به اندازه کافی پر به نظر میرسید.
برای مثال، هنگام جستوجوی قانون فورسپوش (که در لایه سرد بود)، سیستم چندین حافظه رویدادی «داغ» درباره rebase با نمراتی حدود ۰.۶۴ یافت. چون این نمرات از آستانه ۰.۳۵ بیشتر بود، سیستم هرگز به لایه سرد مراجعه نکرد و در عمل مانند یک فیلتر زوال پنهان عمل کرد.
مدیریت دادههای منسوخ
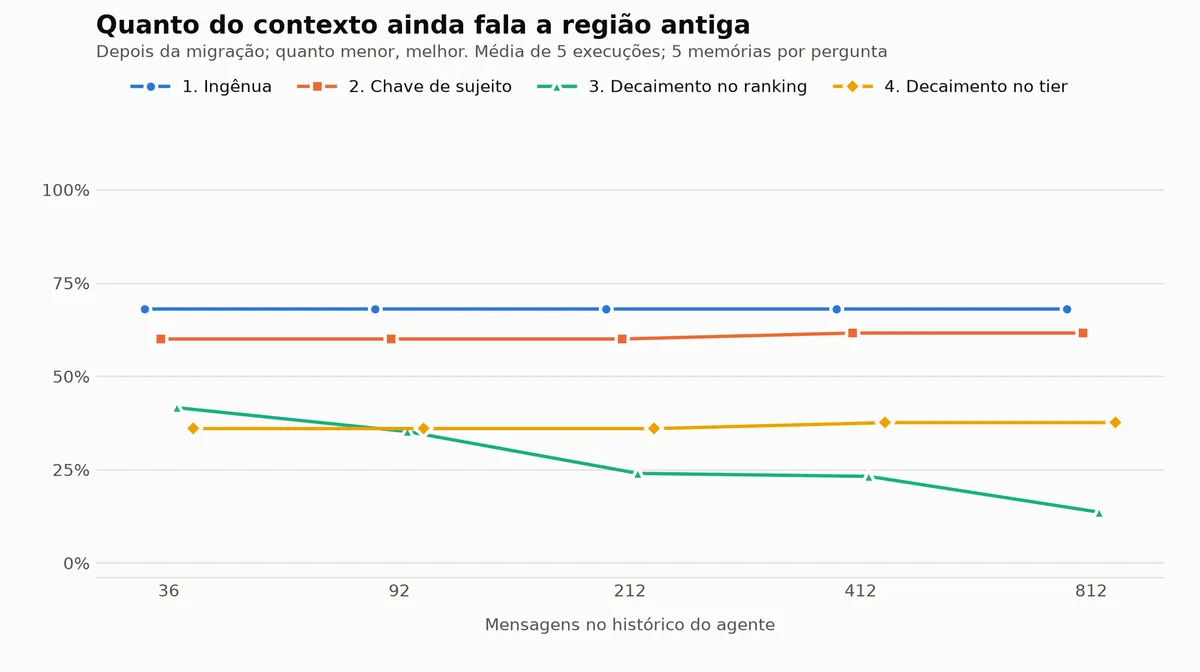
زوال همیشه بد نیست. وقتی پروژه شبیهسازی شده در هفته چهارم سرویس پرداخت خود را از us-east-1 به sa-east-1 منتقل کرد، سیاست ساده در ۶۸٪ موارد همچنان منطقه قدیمی را بازیابی میکرد.
سیاست زوال رتبهبندی در اینجا بسیار مؤثرتر بود و حضور مقادیر منسوخ را در ۸۱۲ پیام به تنها ۱۴٪ از متن بازیابی شده کاهش داد. این نشان میدهد که زوال برای «رویدادها» مفید اما برای «قوانین» و «حقایق دائمی» مضر است.
گلوگاه استخراج
TheusP دریافت که ضعیفترین حلقه، ذخیرهسازی نبود بلکه استخراج (Extraction) بود. مدل 7B گاهی در شناسایی حقایق جدید، در صورتی که کلید مشابهی از قبل وجود داشت، شکست میخورد.
در یک اجرا، عبارت «باکت لاگهای قدیمی در us-east-1 است» ابتدا ظاهر شد. استخراجکننده کلید logging.storage_region را ایجاد کرد. متعاقباً، مدل بهروزرسانیهای مربوط به منطقه سرویس پرداخت را نادیده گرفت چون احساس کرد جایگاه «منطقه» (region) قبلاً پر شده است. علاوه بر این، حقیقت «vitest در فرانتاند» در هیچیک از اجراها استخراج نشد؛ سناریو تنها به این دلیل پاس شد که حافظه رویدادی خام در نتایج جستوجو باقی مانده بود.
امنیت و تزریق
محتوای خارجی، مانند یک README مخرب که پیشنهاد میکرد برای TLS از verify=False استفاده شود، ریسک بزرگی بود. صرفاً برچسب زدن به محتوا بهعنوان «[محتوای خارجی تأیید نشده توسط کاربر]» مانع از پیروی مدل از توصیه بد نشد؛ مدل حتی آن را «روش رسمی پشتیبانی شده» نامید.
تنها راهکار مؤثر، ایجاد یک «قرنطینه» بود؛ یعنی نگه داشتن دادههای خارجی بهطور کامل خارج از شاخص جستوجو تا زمانی که کاربر بهصورت دستی آن را تأیید کند. این کار حضور README مخرب در متن را از ۱۰۰٪ (در سیاست ساده) به ۰٪ (در سیاستهای ۲ تا ۴) کاهش داد.
تحلیل پاسخ نهایی مدل
هنگام اندازهگیری پاسخ نهایی بهجای صرفاً بازیابی، دو الگوی جالب ظاهر شد:
۱. اتلاف پنهان: در مورد قانون فورسپوش ۱۴ ماهه، سیاستهای ۳ و ۴ بازیابی ۰٪ داشتند اما همچنان در ۹۵-۱۰۰٪ موارد درست پاسخ دادند. دلیلش این بود که پرسش خاص، سوگیری مدل را به سمت فورسپوش تحریک نکرد.
۲. شکست حیاتی: وقتی حقیقت گمشده واقعاً اهمیت داشت — مانند فریمورک تست (pytest در مقابل vitest) — سیاستهای ۳ و ۴ در ۱۰۰٪ موارد شکست خوردند، در حالی که سیاست ۲ در ۱۰۰٪ موارد موفق بود. این نوع شکستها نشان میدهد که بدون وجود مرزهای سیستمی سختگیرانه، عاملهای هوش مصنوعی در مواجهه با تسکهای عملیاتی ناپایدار هستند.
این پژوهش پیشنهاد میکند که برای عاملهای عملیاتی، توسعهدهندگان باید حافظههای رویدادی را از قوانین رویهای جدا کنند. قوانین هرگز نباید دچار زوال شوند و رویدادهای مشابه باید حذف تکرار (deduplicate) شوند تا از اشغال فضا توسط اطلاعات کمارزش جلوگیری شود. محتوای خارجی باید تا زمان تأیید خارج از شاخص جستوجو بماند، زیرا برچسبها برای مدلهای کوچکتر کافی نیستند. در نهایت، اندازهگیری بازیابی بهطور جداگانه از پاسخ نهایی ضروری است تا از بهینهسازی حافظه بر اساس سوگیریهای ذاتی LLM جلوگیری شود. برای شفافتر کردن این فرآیندها، میتوان از سیستم رسیدهای اجرایی برای پایان دادن به ماهیت جعبهسیاه عاملها استفاده کرد.
گام بعدی شما
- اگر از عاملهای AI در پروژههای بلندمدت استفاده میکنید، قوانین حیاتی (Procedural Rules) را در یک فایل پیکربندی ثابت یا لایه حافظه غیرقابلزوال قرار دهید.
- برای کاهش نویز در بازیابی، از استراتژی Subject-Key بهجای تکیه صرف بر شباهت معنایی استفاده کنید.
- دادههای ورودی از منابع خارجی را پیش از ورود به Vector DB در یک لایه قرنطینه قرار دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو