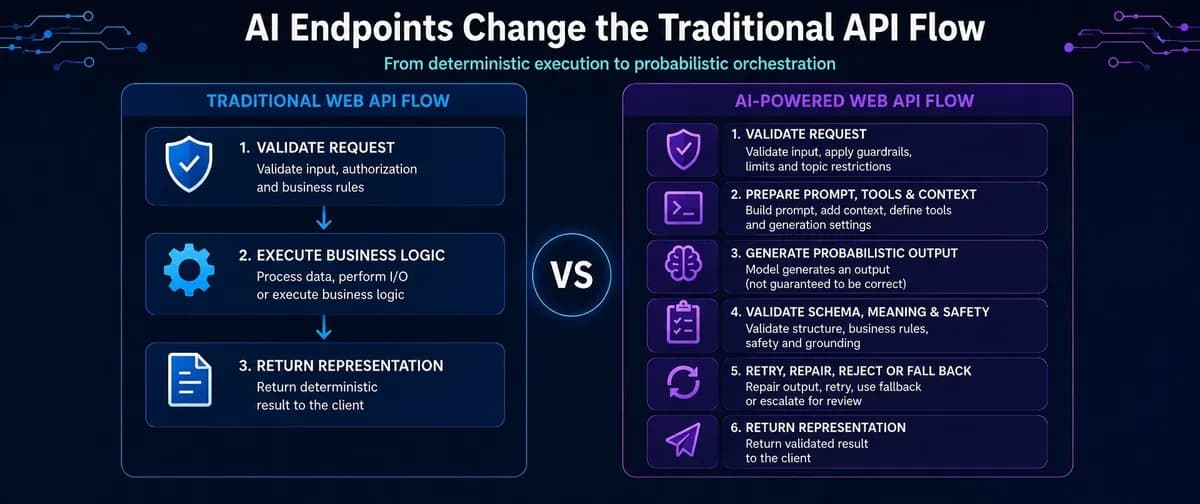
اگر امروز یک توسعهدهنده بکاندر باشید، مدل ذهنی شما از نحوه تعامل با سرورها در حال تغییر است. باید بدانید که تبدیل یک API ساده به یک نقطه اتصال هوش مصنوعی، در واقع تبدیل یک «پروکسی» به یک «خط لوله هماهنگساز» پیچیده است. این مشاهده کلیدی که در یک راهنمای فنی در تاریخ ۲۳ جولای ۲۰۲۶ در وبسایت dev.to به تفصیل شرح داده شده، نشان میدهد که چگونه گذار به سمت نقاط اتصال مبتنی بر AI در حال بازنویسی مدل ذهنی بنیادین توسعهدهندگان بکانند برای اپلیکیشنهای وب است. برخلاف یک API استاندارد که توالی پیشتعریفشدهای از دستورات را برای رسیدن به یک نتیجه قطعی (Deterministic) اجرا میکند، یک نقطه اتصال AI بخشی از خلق نتیجه را به یک سیستم احتمالی (Probabilistic) میسپارد.
بسیاری از توسعهدهندگان در ابتدا با نقاط اتصال AI مانند پروکسیهای ساده برخورد میکنند: دریافت درخواست، ارسال پرامپت به مدل و بازگرداندن پاسخ. طبق گزارشهای فنی، این رویکرد در محیط عملیاتی بهسرعت شکست میخورد. بدون محدودیتهای سختگیرانه برای ورودیها و حفاظها (Guardrails)، این نقاط اتصال در برابر سوءاستفاده آسیبپذیر میشوند و کاربران خارجی میتوانند با ارسال دستورات مخرب یا contextهای بیش از حد بزرگ، اعتبار مصرفی AI شرکت را تخلیه کنند. علاوه بر این، ارسال یک context حجیم برای یک وظیفه خاص، نه تنها هزینه را افزایش میدهد، بلکه ممکن است منجر به تولید نتایج غیرمنتظره شود. این چالش در درک دقیق زمینه تجاری، مشابه آنچه در بررسی نقاط ضعف ابزارهای سازندهی سایت در مدیریت کانتکستهای پیچیده مشاهده شد، بازتاب مییابد.

مبنای APIهای وب سنتی
برای درک این تغییر، ابتدا باید به مدل سنتی یا Baseline نگاه کنیم. یک نقطه اتصال Web API متعارف معمولاً یک جریان خطی ساده را دنبال میکند: اعتبارسنجی درخواست $\downarrow$ اجرای منطق کسبوکار $\downarrow$ بازگرداندن نمایش داده (Representation).
در مرحله اول، بکانند دادههای ورودی را بر اساس محدودیتهای ویژگی (Property Constraints)، قراردادهای API، قوانین احراز هویت (Authorization Rules) و قوانین کسبوکار خاص اپلیکیشن بررسی میکند. مرحله دوم شامل پردازش دادهها، انجام عملیات ورودی/خروجی (I/O) یا اجرای منطق کسبوکار است. در مرحله نهایی، نتیجه بازگردانده میشود.
این فرآیند در یک وضعیت (State) مشخص از برنامه، کاملاً قطعی است؛ یعنی اجرای کد مشابه روی وضعیت دادهای مشابه، عموماً نتیجه یکسانی دارد. جریان کلی این فرآیند نسبتاً ساده است، حتی اگر گامهای فردی آن پیچیده باشند. اما مدلهای AI به این صورت عمل نمیکنند؛ آنها صرفاً یک توالی از دستورات پیشتعریفشده را اجرا نمیکنند تا همیشه نتیجه یکسانی تولید کنند.
جریان جدید نقاط اتصال AI
یک نقطه اتصال مبتنی بر AI به مراتب پیچیدهتر است. این دیگر یک توالی ساده از دستورات نیست، بلکه یک «خط لوله هماهنگساز» (Orchestration Pipeline) است: اعتبارسنجی درخواست $\downarrow$ آمادهسازی پرامپت، ابزارها و زمینه $\downarrow$ تولید خروجی احتمالی $\downarrow$ اعتبارسنجی طرحواره، معنا و ایمنی $\downarrow$ تلاش مجدد، ترمیم، رد یا جایگزینی $\downarrow$ بازگرداندن نمایش داده.
این چرخه حیات گسترشیافته شامل چندین لایه حیاتی است:
- حفاظهای ورودی (Input Guardrails): فراتر از محدودیتهای ویژگی و قوانین کسبوکار استاندارد، بکانند اکنون باید موضوعات درخواستشده را محدود کند، اندازه ورودی را کنترل نماید، کنترلهایی علیه دستورات مشکوک اعمال کند، محتوای بازیابیشدهی غیرقابلاعتماد را ایزوله کند و تصمیم بگیرد که مدل دقیقاً مجاز به فراخوانی کدام ابزارها (Tools) است.
- ساختار پرامپت (Prompt Construction): اپلیکیشن بهصورت پویا دستورالعملها، تاریخچه گفتگو، زمینه بازیابیشده (Retrieved Context)، تعاریف ابزارها و تنظیمات تولید (Generation Settings) را برای فراخوانی مدل آماده میکند.
- تولید احتمالی (Probabilistic Generation): مدل خروجی را تولید میکند. نکته بسیار حیاتی این است که یک پاسخ HTTP موفق از سوی ارائهدهنده مدل، تنها تایید میکند که مدل «چیزی» تولید کرده است؛ این اصلاً تضمینکننده کامل بودن، ایمن بودن، مستند بودن (Grounded) یا مفید بودن نتیجه نیست.
- اعتبارسنجی پس از تولید (Post-Generation Validation): بررسی در دو مرحله رخ میدهد. ابتدا، سیستم طرحواره (Schema) JSON را تایید میکند، مشابه پاسخی که از یک سرویس خارجی متعارف دریافت میشود. دوم، سیستم بررسی میکند که آیا نتیجه از نظر منطقی برای حوزه کسبوکار غلط است یا ویژگیهایی که باید بر اساس زمینه حضور داشته باشند، حذف شدهاند.
- منطق بازیابی (Recovery Logic): وقتی خروجی در بررسیها شکست میخورد، سیستم درباره گام بعدی تصمیم میگیرد. ممکن است سعی کند پاسخ را ترمیم کند، از مدل بخواهد دوباره آن را تولید کند، از یک مدل جایگزین (Fallback) استفاده کند، یک خطای کنترلشده بازگرداند یا درخواست را برای بازبینی انسانی ارسال کند. هر تصمیم دارای هزینه است: تلاشهای مجدد توکن مصرف میکنند و دخالت انسانی هزینه زمانی و مالی دارد.
معادله تأخیر و هزینه
تأخیر (Latency) در APIهای سنتی توسط منطق کسبوکار، I/O و پردازش دادهها تعیین میشود. این موارد را میتوان با بهبود کد، بهروزرسانی کوئریهای دیتابیس یا افزودن کشینگ بهینه کرد. اما نقاط اتصال AI سطح جدیدی از تغییرپذیری را معرفی میکنند که در آن زمان تولید به مدل، پرامپت، اندازه زمینه (Context Size)، طول خروجی و بار سرور ارائهدهنده بستگی دارد.
یک درخواست ممکن است پس از یک بار فراخوانی به پایان برسد، در حالی که درخواست دیگر به چندین فراخوانی ابزار، تلاشهای اعتبارسنجی یا مراحل تولید مجدد نیاز داشته باشد. این موضوع باعث میشود مدیریت Time-outها، لغو درخواست (Cancellation)، استریمینگ (Streaming)، پردازش غیرهمزمان و بودجههای تأخیر بسیار حیاتیتر شوند. چون مدلهای AI احتمالی هستند، آنها صرفاً یک توالی دستور را اجرا نمیکنند تا همیشه نتیجه یکسانی دهند، و همین امر لایهای از تغییرپذیری غیرقابلپیشبینی به زمان پاسخدهی اضافه میکند.
برای بهینهسازی این وضعیت، توسعهدهندگان از درخواست اشیاء (Objects) کامل فاصله گرفتهاند. به عنوان مثال، اگر بکانند دادههایی مانند این داشته باشد:
{
  "data": [
    { "id": 1, "name": "john doe", "address": "Mordor", "category": "Nazgûl" },
    { "id": 2, "name": "joe doe", "address": "Gondor", "category": "soldier" }
  ]
}
بکانند میتواند این لیست را به مدل ارائه دهد اما به مدل دستور دهد که بهجای تکرار کامل اشیاء، تنها IDهای انتخاب شده را بازگرداند. سپس بکانند آن IDها را دوباره به دادههای اصلی نگاشت (Map) میکند. این کار تعداد توکنهای خروجی را کاهش داده و هم تأخیر و هم هزینه را بهبود میبخشد. در اصل، بهینهسازی نقاط اتصال AI مستلزم تغییر رویکرد به سمت بهینهسازی پرامپتها، اندازه زمینه، انتخاب مدل و شکل دقیق خروجی تولید شده است.
بازنگری در منطق تلاش مجدد (Retry) و یکتایی (Idempotency)
در APIهای سنتی، تلاشهای مجدد بر اساس شکستهای فنی هستند، مانند عدم دسترسی موقت به یک وابستگی، قطع اتصال یا دریافت یک کد وضعیت گذرا (Transient) از سرویس خارجی. اما نقاط اتصال AI «تلاشهای مجدد منطقی» (Logical Retries) را معرفی میکنند. یک درخواست میتواند در سطح انتقال (Transport) موفق باشد، اما خروجی غیرقابل استفاده باشد؛ مثلاً یک فیلد ضروری گم شده باشد، طرحواره را بشکند، با زمینه ارائهشده در تضاد باشد یا یک قانون کسبوکار را نقض کند.
چون هر توکن قیمت دارد، تلاشهای مجدد AI را نمیتوان مانند بازtryingهای شبکه عادی مدیریت کرد. اینها نیاز به محدودیتهای صریح و در نظر گرفتن بودجههای مالی، دلیل شکست، احتمال موفقیت در تلاش بعدی و در دسترس بودن یک مدل جایگزین یا جایگزین قطعی دارند.
یک خط لوله Retry در C# را در نظر بگیرید که از یک مدل محلی از طریق Ollama استفاده میکند. یک ResiliencePipelineBuilder معمولی ممکن است HttpRequestException ،JsonException و TaskCanceledException را با حداکثر دو تلاش مجدد و عقبنشینی نمایی (Exponential Backoff) که از دو ثانیه شروع میشود (با استفاده از DelayBackoffType.Exponential و UseJitter = true) مدیریت کند. با این حال، نیاز تخصصی AI، افزودن متد .HandleResult(r => r.IsFailed) است. این تضمین میکند که اگر پاسخ از نظر فنی معتبر اما از نظر منطقی غلط بود، خط لوله یک تلاش مجدد را فعال کند.
اگرچه این رویکرد برای مدلهای محلی و رایگان عملی است، اما برای ارائهدهندگان پولی گران است زیرا هر تلاش مجدد توکنهای اضافی مصرف میکند. گاهی تصمیم درست این است که تلاش مجدد نکنیم، بلکه خروجی را رد کنیم، خطای کنترلشده بازگردانیم یا از کاربر اطلاعات بیشتری بخواهیم.
موضوع یکتایی (Idempotency) نیز زمانی که مدلها از ابزارها استفاده میکنند، به یک ریسک بحرانی تبدیل میشود. برای نقاط اتصال فقط-خواندنی (Read-only)، عبارتهای مختلف برای یک پرامپت یکسان پذیرفتنی است چون وضعیت سرور تغییر نمیکند. اما اگر یک نقطه اتصال بتواند عملیاتی انجام دهد — مانند ایجاد سفارش، ارسال ایمیل یا بهروزرسانی دادهها از طریق یک ابزار — یک تلاش مجدد پس از شکست اعتبارسنجی میتواند منجر به فراخوانی دوبارۀ ابزار توسط مدل شود. این امر منجر به ایجاد سفارشات تکراری میگردد.
برای جلوگیری از این اتفاق، عملیاتهای تحریکشده توسط AI باید از محافظاتی مانند کلیدهای یکتایی (Idempotency Keys)، نتایج عملیات ذخیرهشده و محدودیتهای منحصربهفرد استفاده کنند. تکرار همان عمل با همان ID عملیات باید نتیجه اصلی را بازگرداند، بهجای اینکه اثر جانبی (Side Effect) را دوباره اجرا کند.
تغییرات در تست و مشاهدهپذیری
تستهای «تطبیق دقیق خروجی» (Exact-output assertions) بسیار شکننده هستند، زیرا یک پاسخ معتبر میتواند به چندین روش مختلف نوشته شود و بهروزرسانیهای مدل ممکن است کلمات را بدون تغییر معنا عوض کنند. از طرف دیگر، تست کردن صرفاً پاسخ 200 OK یا فیلدهای غیر-null بیش از حد ضعیف است.
بهجای استفاده از Assert.Equal برای رشتههایی مانند "Family Day in Brno" یا یک توصیف خاص یا هزینه دقیق ۱,۵۰۰، توسعهدهندگان باید از «اعتبارسنجیهای مبتنی بر ویژگی» (Property-based assertions) استفاده کنند. این رویکرد بهینه در تست، یادآور تجربههایی است که در آن بهرهگیری از حلقههای بازخورد در پایتون توانست زمان نوشتن تستهای APIهای حجیم را به شدت کاهش دهد. برای یک برنامه تولید شده، تستها باید موارد زیر را تأیید کنند:
- نتیجه null نباشد و فعالیتها خالی نباشند (
Assert.NotNull(result),Assert.NotEmpty(result.Activities)). - هزینه کل در یک محدوده (Range) باشد (مثلاً بین ۰ و بودجه درخواست شده:
Assert.InRange(result.TotalCost, 0, request.Budget)). - تمامی فعالیتها با
AllowedActivityTypesمطابقت داشته باشند و زمان سفر (TravelTimeMinutes) در محدوده حداکثری درخواست شده باشد (Assert.Containsبرای انواع،Assert.InRangeبرای زمان). - هیچ فعالیتی به عنوان «بسته شده» علامتگذاری نشده باشد (
Assert.DoesNotContain(result.Activities, activity => activity.IsClosed)). - تمامی فعالیتها شامل
SourceIdsاجباری باشند و نام آنها خالی نباشد (Assert.All(result.Activities, activity => Assert.NotEmpty(activity.SourceIds)),Assert.False(string.IsNullOrWhiteSpace(activity.Name))).
در حالی که اعتبارسنجی طرحواره، احراز هویت، مجوزهای ابزار، پارس کردن، منطق جایگزینی و مدیریت اثرات جانبی را همچنان میتوان مانند کدهای برنامهنویسی معمولی به صورت قطعی تست کرد، اما نتیجه تولید شده نیاز به گذار به سمت تأییدیه مبتنی بر محدوده و قانون دارد.
قرارداد خروجی و مشاهدهپذیری
خروجی AI یک مشکل ظریف ایجاد میکند که در آن پاسخ یک JSON معتبر است اما از نظر منطقی متناقض است. برای مثال، پاسخی ممکن است به این شکل باشد:
{
  "approved": true,
  "reason": "The customer meets all required conditions.",
  "failedConditions": [
    { "name": "age", "value": 13, "description": "The customer is under the required age." }
  ]
}
این پاسخ با طرحواره مورد انتظار مطابقت دارد و یک JSON کاملاً معتبر است، اما با خودش در تضاد است: مشتری تأیید شده است در حالی که شرط سنی را رد کرده است. اعتبارسنجی طرحواره لازم است اما کافی نیست؛ سیستم به اعتبارسنجی قوانین کسبوکار، بررسیهای سازگاری منطقی و اعتبارسنجی ایمنی نیاز دارد. نقطه اتصال باید بین پاسخی که «قابل تجزیه (Parse) است» و پاسخی که «قابل اعتماد است»، تفاوت قائل شود.
مشاهدهپذیری (Observability) نیز باید تکامل یابد. معیارهای سنتی (تعداد درخواست، تأخیر، نرخ خطا) ناکافی هستند. نقاط اتصال AI به معیارهای تخصصی مدل نیاز دارند:
- مصرف توکن: نظارت بر هر دو توکن ورودی و خروجی.
- ردیابی مدل: ثبت مدل خاص و شماره نسخه استفاده شده.
- ردیابی تلاشها: تعداد دفعات تولید و فرکانس تلاشهای مجدد.
- معیارهای کیفیت: شکستهای اعتبارسنجی، نرخ موفقیت ترمیم و امتیازهای ارزیابی.
- شاخصهای مالی: تخمین هزینه به ازای هر درخواست.
بدون اینها، ممکن است ارائهدهنده مدل را پشت یک نام مستعار (Alias) تغییر دهد و باعث شود نقطه اتصال «عملیاتی» بماند (200 OK)، در حالی که هزینه افزایش مییابد، حجم زمینه بازیابیشده در طول زمان رشد میکند و کیفیت خروجی بهتدریج افت میکند.
خلاصه
نقاط اتصال سنتی منطق کسبوکاری را اجرا میکنند که توسط کد تعریف و کنترل شده است. نقاط اتصال AI متفاوت هستند؛ آنها تولیدات احتمالی را هماهنگ میکنند، نتیجه را اعتبارسنجی میکنند و تصمیم میگیرند که آیا نتیجه برای بازگرداندن به اندازه کافی قابل اعتماد است یا خیر. این امر نقطه اتصال را از یک پروکسی ساده حول یک فراخوانی مدل، به یک خط لوله هماهنگساز تبدیل میکند.
یک نقطه اتصال AI نباید صرفاً یک پروکسی نازک باشد. مدل خروجی را تولید میکند، اما بکانند همچنان تصمیم میگیرد که آیا این خروجی باید به پاسخ نهایی تبدیل شود یا خیر. برای تسلط بر این موضوع، توسعهدهندگان باید لایههای سختگیرانه اعتبارسنجی طرحواره و مانیتورهای ردیابی توکن را برای هر مسیر فعالشده با AI در استک خود پیادهسازی کنند.
گام بعدی شما
- لایههای اعتبارسنجی طرحواره (Schema Validation) سختگیرانه را برای تمامی مسیرهای AI در استک خود پیاده کنید.
- سیستم مانیتورینگ توکنها را برای هر درخواست به صورت مجزا فعال کنید تا نشت هزینه را شناسایی کنید.
- برای هر عملیاتی که از طریق Tool Use انجام میشود، مکانیسم Idempotency Key را اجباری کنید.
این تغییر در معماری تنها آغاز ماجراست؛ اثر موجگونهی این رویکرد بر توسعه سامانههای عاملمحور را در گزارشهای بعدی بررسی خواهیم کرد.



گفتگو