
عدد «۱۶۸» برای اکثر مردم فقط یک عدد است، اما برای کسی که در شهری آلوده زندگی میکند، یک هشدار مبهم است که نمیگوید دقیقاً چه اتفاقی در حال رخ دادن است. در حالی که این عدد در شاخص کیفیت هوا (AQI) به کاربر میگوید که هوا در وضعیت «متوسط» قرار دارد، اما نمیتواند توضیح دهد که چرا این اتفاق افتاده است. پروژه AirAware India — که برای ایداتون Cohort 3 آکادمی Gen AI APAC توسعه یافته است — قصد دارد این شکاف را پر کند و دادههای خام محیطی را به اطلاعاتی تبدیل کند که هر انسانی بتواند آن را بفهمد.
بسیاری از کاربران با شاخصهای کیفیت هوا مانند گزارشهای آبوهوا برخورد میکنند؛ آنها یک عدد و یک رنگ را میبینند اما نمیتوانند شیمیِ زیربنایی آن را تفسیر کنند. این پروژه در زمانی عرضه شده که هند از طریق شورای مرکزی کنترل آلودگی (CPCB)، اکوسیستم نظارتی گستردهای دارد، اما دادهها همچنان در داشبوردهای فنی محبوس ماندهاند. همانطور که در تحلیل قبلی ما دربارهی استفاده از گوگل جمینای (Google Gemini) برای خودکارسازی گردشهای کاری پیچیده در بخش حقوقی اشاره کردیم، AirAware نیز قابلیتهای استدلالی مشابه را برای مجموعهدادههای محیطی عمومی به کار میگیرد.
زمینه و چالش دادههای کیفیت هوا
زیرساختهای نظارتی فعلی هند قدرتمند است، اما نحوه ارائه این اطلاعات اغلب بیش از حد فنی است. شورای CPCB اندازهگیریهای حیاتی را برای طیف وسیعی از آلایندهها منتشر میکند که شامل موارد زیر است:
- ذرات معلق (PM2.5 و PM10)
- دیاکسید نیتروژن (NO₂)
- دیاکسید گوگرد (SO₂)
- مونوکسید کربن (CO)
- ازون (O₃)
مشکل اصلی، کمبود داده نیست، بلکه وجود یک شکاف در دسترسیپذیری است. AirAware India به عنوان یک لایه گفتگویی روی این اندازهگیریهای واقعی طراحی شده است. به جای یک داشبورد ایستا، کاربران میتوانند سوالات خاصی بپرسند، مثلاً: «چرا کیفیت هوای امروز بد است؟» یا «این اعداد را بدون استفاده از تمام اصطلاحات فنی برایم توضیح بده».
معماری هوش مصنوعی مبنیسازیشده
برای جلوگیری از اینکه هوش مصنوعی اعداد کیفیت هوا را از خودش اختراع کند، توسعهدهنده تفکیکی سختگیرانه بین بازیابی داده و توضیح آنها ایجاد کرده است. این سیستم از یک خط لوله (Pipeline) مشخص پیروی میکند: ابتدا مشاهدات خام را بازیابی میکند، آنها را اعتبارسنجی میکند، دادهها را نرمالسازی میکند و تنها پس از آن، تحلیل را برای سنتز زبان طبیعی به Gemini میسپارد.
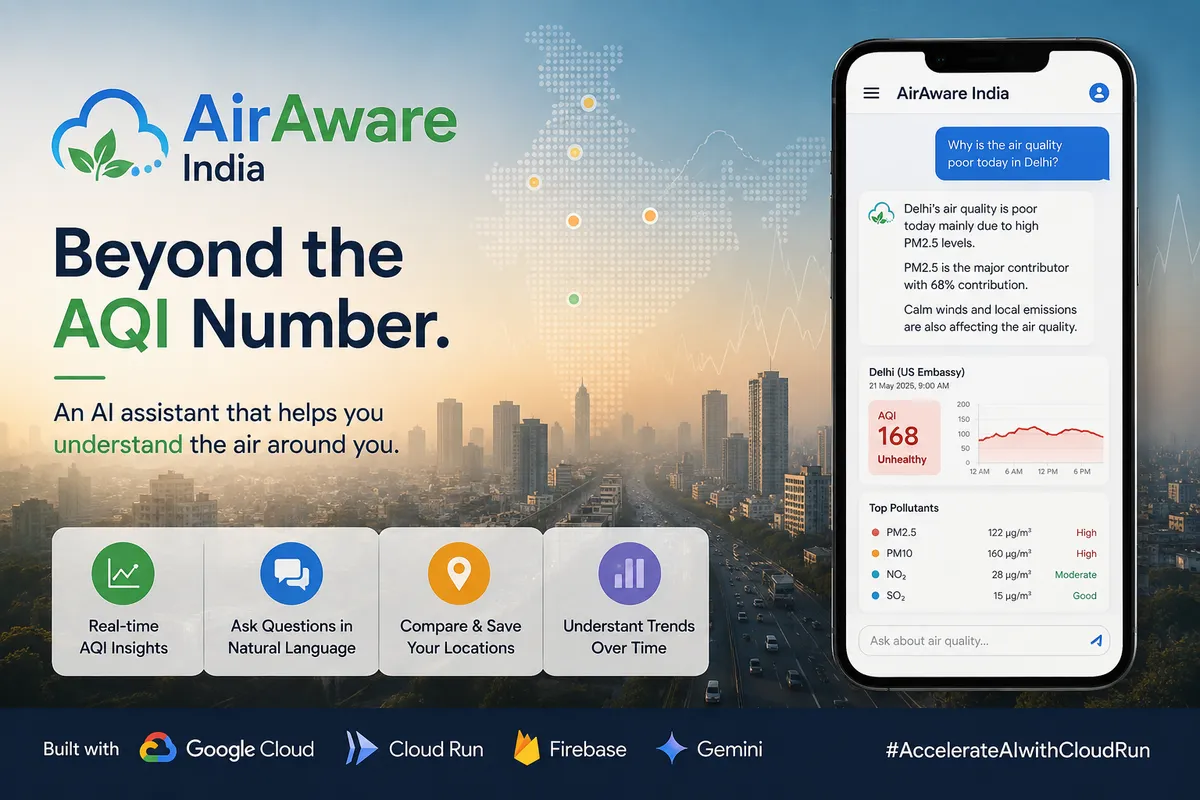
گردش کار مورد نظر به این صورت ساختار یافته است: پرسش کاربر $
ightarrow$ بازیابی دادههای کیفیت هوا $
ightarrow$ اعتبارسنجی اعداد $
ightarrow$ تحلیل دادهها $
ightarrow$ Gemini $
ightarrow$ توضیح قابلفهم انسانی. این ساختار تضمین میکند که جمینای پاسخ را از حافظه خود حدس نزند، بلکه دادههای منبعِ مبنیسازیشده (Grounded) را تفسیر کند.
پشته فنی این پروژه بر چهار جزء اصلی گوگل کلاود (Google Cloud) استوار است:
- Cloud Run: به عنوان بکاِند عمل میکند و جریان بین درخواستهای کاربر، دادههای CPCB و لایه هوش مصنوعی را سازماندهی میکند.
- Firebase Authentication: دسترسی امن و شخصیسازیشده به پروفایل کاربران را تضمین میکند تا کاربران یک وضعیت اپلیکیشن ناشناس و مشترک نداشته باشند.
- Firestore: دادههای خاص کاربر، مانند مکانهای ذخیرهشده خانه و محل کار را ذخیره میکند تا پرسوجوهای مقایسهای امکانپذیر شود.
- Gemini API: به عنوان لایه استدلال و ارتباط عمل میکند و اعداد فنی آلایندهها را به زبان ساده انگلیسی (و زبانهای دیگر) تبدیل میکند.
فراتر از یک داشبورد ساده
AirAware بر سه نیاز خاص کاربر تمرکز دارد که اپلیکیشنهای سنتی نادیده میگیرند. اول، پاسخ به «چرا»؛ سیستم با شناسایی اینکه کدام آلاینده خاص — مانند PM2.5، PM10، NO₂، SO₂، CO یا O₃ — محرک اصلی یک عدد بد است، علت را توضیح میدهد. اگر ذرات معلق عامل اصلی در یک مکان خاص باشند، هوش مصنوعی آن آلاینده را برجسته کرده و توضیح میدهد که این اندازهگیری در زبان ساده به چه معناست.
دوم، امکان مقایسههای مبتنی بر مکان است. چون اپلیکیشن مکانهای کاربر را در Firestore ذخیره میکند، کاربر میتواند بپرسد «هوای اطراف خانه در مقایسه با محل کار چطور است؟» بدون اینکه نیاز باشد دوباره مختصات را وارد کند. برای مثال، یک کاربر میتواند مکانهای زیر را ذخیره کند:
- خانه $
ightarrow$ حیدرآباد (Hyderabad) - محل کار $
ightarrow$ شهر HITEC - خانواده $
ightarrow$ سکندرآباد (Secunderabad)
سوم، ارائه تحلیلهای تاریخی است. به جای اجبار کاربر به تفسیر یک نمودار خطی، اپلیکیشن آمار را محاسبه کرده و از Gemini میخواهد روند را توضیح دهد. کاربر کافی است بپرسد «این هفته چه تغییری کرد؟» تا خلاصهای از تغییرات کیفیت هوا را دریافت کند.
مدیریت نویز در دادههای واقعی
حسگرهای محیطی بهندرت بینقص هستند. توسعهدهنده اشاره کرده است که دادههای دنیای واقعی اغلب ناقص، دارای تأخیر یا غیرطبیعی هستند. برای مقابله با این موضوع، AirAware یک لایه اعتبارسنجی دارد که اعداد غیرقابلاعتماد را شناسایی میکند.
خط لوله برای مدیریت این نویز به این ترتیب است: مشاهده خام $
ightarrow$ اعتبارسنجی $
ightarrow$ نرمالسازی $
ightarrow$ تحلیل $
ightarrow$ Gemini $
ightarrow$ کاربر.
اگر یک عدد در دسترس نباشد یا غیرقابلاعتماد به نظر برسد، سیستم طوری طراحی شده است که اعتراف کند پاسخ را نمیداند، به جای اینکه اجازه دهد هوش مصنوعی جای خالی را با یک حدس پر کند. این یک اصل اساسی در ساخت هوش مصنوعی مسئولانه است: دانستن اینکه چه زمانی سیستم اطلاعات کافی و قابلاعتمادی برای پاسخ دادن با اطمینان ندارد.
حفاظهای ایمنی و اخلاقی
از آنجا که کیفیت هوا مستقیماً بر سلامت تأثیر میگذارد، این پروژه مرزهای اخلاقی سختگیرانهای را در بر گرفته است. سیستم صراحتاً طوری طراحی شده است که تشخیص پزشکی ارائه نکند یا جایگزین توصیههای بهداشتی متخصصان نشود. این برنامه تمایزی واضح بین توضیح اطلاعات محیطی و تصمیمگیریهای پزشکی فردی قائل میشود.
برای تضمین ایمنی و حریم خصوصی، پروژه از چندین اصل کلیدی پیروی میکند:
- مبنیسازی دادهها (Data Grounding): مقادیر محیطی باید از منابع داده متصل بیایند، نه از دانش تولید شده توسط مدل.
- قابلیت ردیابی: اندازهگیریها باید اطلاعات مربوط به مکان و زمان مشاهده را حفظ کنند.
- شفافیت: اعداد ناقص یا غیرطبیعی باید شناسایی شوند، نه اینکه به عنوان دادههای نرمال تفسیر شوند.
- حریم خصوصی: اطلاعات شخصی کاربران احراز هویتشده باید به طور سختگیرانه بین حسابها جدا بماند.
- امنیت: تمام اعتبارنامههای API و اسرار (Secrets) در سمت سرور باقی میمانند و هرگز از طریق کلاینت یا مخازن عمومی افشا نمیشوند.
این رویکرد، نقش هوش مصنوعی زاینده (Generative AI) را از یک «تولیدکننده محتوا» به یک «مترجم داده» تغییر میدهد. با مبنیسازی مدل بر اساس اندازهگیریهای CPCB، این پروژه آزمایش میکند که آیا مدلهای زبانی بزرگ (LLMs) میتوانند مجموعهدادههای عمومی را برای شهروندان عادی واقعاً در دسترس قرار دهند یا خیر.
گامهای بعدی برای توسعه
پروژه AirAware India در حال حاضر در حال انتقال از مفهوم به نمونه اولیه (Prototype) است. گام فوری بعدی، اعتبارسنجی دادههای موجود کیفیت هوا و ساخت اولین گردش کار کامل (End-to-End) است: ورود به سیستم $
ightarrow$ انتخاب مکان $
ightarrow$ بازیابی اندازهگیریها $
ightarrow$ تحلیل دادهها $
ightarrow$ پرسش از جمینای $
ightarrow$ دریافت یک توضیح مبنیسازیشده.
پس از این مرحله، توسعهدهنده قصد دارد روی مکانهای ذخیرهشده، مقایسهها و بینشهای تاریخی آزمایش کند، در حالی که نسخه اولیه را به اندازه کافی کوچک نگه میدارد تا قابلاعتماد باقی بماند. هدف نهایی این است که تعیین شود آیا هوش مصنوعی زاینده میتواند استفاده از مجموعهدادههای عمومی را برای مردم واقعاً آسانتر کند، یا صرفاً اطلاعات بیشتری تولید میکند.
منتظر انتشار نمونه اولیه باشید تا ببینید آیا این لایه گفتگویی میتواند تعامل کاربران با دادههای محیطی عمومی را به طور قابل توجهی افزایش دهد یا خیر. #AccelerateAIwithCloudRun
گام بعدی شما
- اگر توسعهدهنده هستید، معماری تفکیک «بازیابی $
ightarrow$ اعتبارسنجی $
ightarrow$ سنتز» را برای جلوگیری از توهم در دادههای عددی بررسی کنید. - برای پروژههای دادهمحور، از Cloud Run برای مدیریت جریانهای دادهای بین APIهای دولتی و مدلهای زبانی استفاده کنید.
- در طراحی رابطهای AI، به جای ارائه نمودار، قابلیت «تفسیر روند» را به کاربر بدهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو