تصور کنید در یک نیروگاه هستهای، تشخیص تغییرات بسیار ریز در لرزش و فشار تجهیزات، تنها مانع از یک فاجعهی صنعتی باشد. در چنین محیطهای حساسی، نگهداری پیشگیرانه به شناسایی نوسانات کوچک وابسته است، پیش از آنکه این نوسانات به شکستهای بحرانی تبدیل شوند. برای حل این چالش، در ۱۴ سپتامبر ۲۰۲۶، یک چارچوب معماری جدید معرفی شد که با جفت کردن Apache IoTDB و Timer، شیوهی مدیریت جریانهای عظیم دادههای حسگر را دگرگون میکند.
چالش دادهها در محیطهای هستهای
در محیطهای صنعتی، دادهها ترکیبی آشفته از پایشهای سریع (High-frequency) و اندازهگیریهای محیطی کند هستند. در یک نیروگاه هستهای، یک جهش دمایی بهتنهایی بیمعنی است، مگر اینکه به یک دارایی خاص، حالت عملیاتی و پیشینهی تاریخی متصل باشد. این وضعیت یک بحران دادهای ایجاد میکند؛ چراکه پایگاههای داده سنتی در مواجهه با فرکانسهای نمونهبرداری متفاوت و نیاز به نگهداری طولانیمدت دادهها، معمولاً شکست میخورند.
تجهیزات نیروگاههای هستهای بسیار پیچیده و بههمپیوستهاند و از زیرسیستمهای بهشدت متصل به هم تشکیل شدهاند. حسگرها طیف گستردهای از سیگنالها را تولید میکنند، از جمله لرزش، دما، فشار، جریان سیالات، سطح مایعات، جریان الکتریکی و ولتاژ. این سیگنالها فرکانس یکسانی ندارند؛ برخی در قالب جریانهای با فرکانس بالا ارسال میشوند، در حالی که برخی دیگر اندازهگیریهای عملیاتی کندتری هستند.
از آنجا که تحلیل قابلیت اطمینان و برنامهریزی برای تعمیرات به مقایسهی وضعیت فعلی با رفتار تاریخی وابسته است، سیستم به افقهای زمانی طولانی برای ذخیرهسازی دادهها نیاز دارد. همچنین، قابلیت ردیابی تصمیمات (Decision Traceability) الزامی است؛ هر هشدار باید بتواند دقیقاً به اندازهگیری، دارایی، بازهی زمانی و بافت عملیاتی خاصی اشاره کند که منجر به تولید آن هشدار شده است.
نقش Apache IoTDB
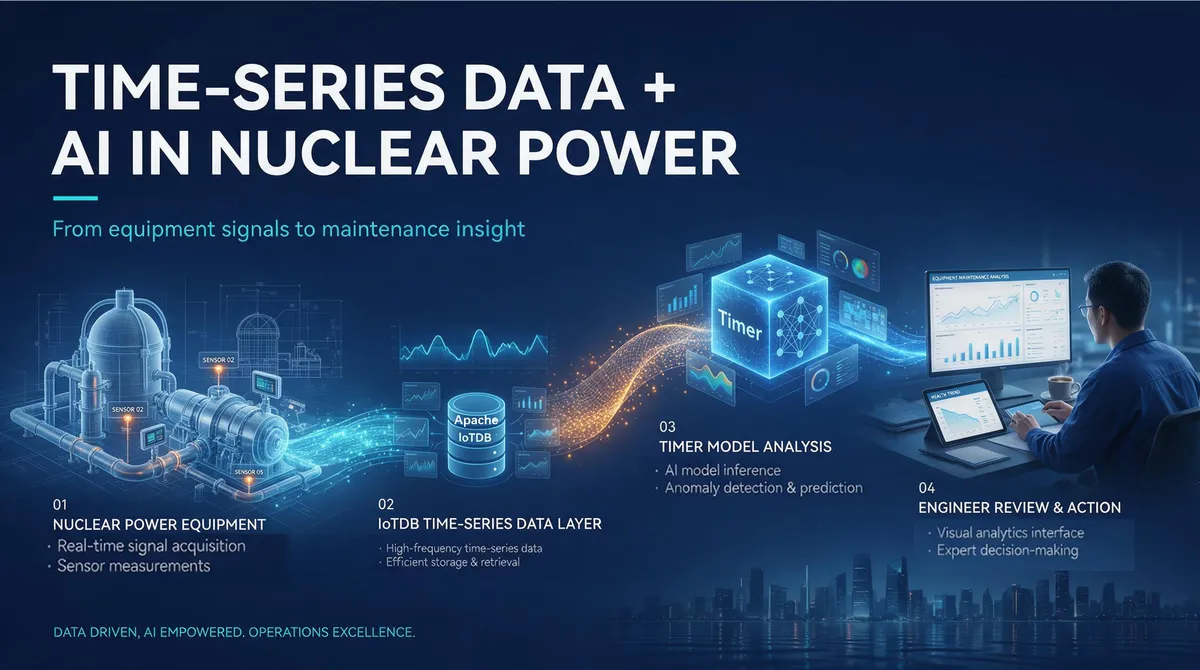
برای حل این مشکل، این معماری از Apache IoTDB بهعنوان لایهی بنیادی دادههای سری زمانی استفاده میکند. طبق گزارش وبسایت dev.to، این پایگاه دادهی متنباز بار سنگین جذب و سازماندهی دادهها را بر عهده دارد. این ابزار بهطور مشخص موارد زیر را مدیریت میکند:
- مدیریت سلسلهمراتبی: اتصال هر نقطهی اندازهگیری به یک دارایی و زیرسیستم خاص، تا اطمینان حاصل شود که مدل داده شامل سلسلهمراتب داراییها و بافت عملیاتی است.
- جذب دادههای چند-فرکانسی: مدیریت دادههای نامنظم (Out-of-order) از حسگرهایی با نرخهای نمونهبرداری متفاوت، که بازتابدهندهی شیوهی واقعی ورود دادهها در نیروگاه است.
- همترازی برچسبهای زمانی: اطمینان از اینکه مقایسهی حسگرهای مختلف در هنگام پرسوجو (Query) از طریق همترازی برچسبهای زمانی در سریهای مختلف، قابل اعتماد است.
- مدیریت یکپارچه: پشتیبانی همزمان از پایش لحظهای (Real-time) و بررسیهای تاریخی طولانیمدت در یک لایهی واحد.
هوشمندی از طریق Timer
در حالی که IoTDB شواهد را ذخیره میکند، Timer — یک مدل بنیادی (Foundation Model) سری زمانی از شرکت Timecho — هوشمندی سیستم را تامین میکند. Timer شبیه به یک متخصص خبره است که سالها دادههای صنعتی را خوانده و حالا الگوهای پنهان را میشناسد. پرسوجوهای استاندارد و حد آستانهها (Thresholds) تنها زمانی هشدار میدهند که یک وضعیت شناختهشده رخ دهد یا یک حد رد شود، اما وقتی چندین سیگنال با هم تداخل دارند، برچسبهای داده کمیاب هستند یا تخریب تجهیزات بهکندی رخ میدهد، این روشها ناکارآمد میشوند.
Timer الگوهای پیچیدهی چندمتغیره را شناسایی میکند که نشاندهندهی تخریب تدریجی هستند. این مدل بهجای جایگزینی قوانین و آمار، آنها را تکمیل میکند و شناسایی الگوها را در سریهای مرتبط و بازههای زمانی طولانتر ممکن میسازد. این رویکرد مشابه کاربردهایی است که تولیدکنندگان پهپاد برای جلوگیری از توقف خط تولید از نگهداری پیشبینانه استفاده میکنند. این قابلیت به مهندسان اجازه میدهد سه مرحلهی ارزشآفرین را طی کنند:
- پایش وضعیت (Condition Monitoring): بررسی همزمان لرزش، دما و اندازهگیریهای الکتریکی بهجای نمودارهای مجزا برای شناسایی تغییرات.
- پیشبینی روند (Trend Forecasting): تخمین الگوهای احتمالی آینده برای تشخیص اینکه آیا روند دما در حال انحراف است یا رفتار فشار بهتدریج در حال تغییر است.
- ارزیابی وضعیت سلامت (Health-State Assessment): ترکیب چندین سیگنال و بافت عملیاتی برای توصیف دقیق وضعیت فعلی تجهیزات دوار، سیستمهای کمکی یا داراییهای مرتبط با خنککنندگی.
مرزهای ایمنی و حاکمیت
نکتهی حیاتی این است که لایهی هوش مصنوعی کاملاً خارج از سیستمهای حفاظت و کنترل ایمنی نیروگاه قرار دارد. این لایه دادهها را از طریق مسیرهای تاییدشدهی یکطرفه (One-way) یا واسطههای مدیریتشده از تاریخنگارها (Historians)، سیستمهای پایش وضعیت یا سایر سرویسهای دادهی نیروگاه دریافت میکند.
با اطمینان از اینکه هوش مصنوعی نمیتواند دستوری به سیستمهای حفاظتی کلاس-ایمنی یا کنترلهای DCS صادر کند، یک مرز امنیتی سختگیرانه تحت عنوان «دفاع در عمق» (Defense-in-Depth) ایجاد شده است. در این ساختار، بهرهبردار باید طبقهبندی دادهها، کنترل دسترسی، مدیریت تغییرات و ردپای حسابرسی (Audit Trails) را تعیین کند. در برخی حوزههای قضایی، این موارد شامل کنترلهای مبتنی بر NQA-1 در چارچوب تضمین کیفیت هستهای است.
این تغییر، بار جمعآوری شواهد را از دوش مهندس به دوش سیستم منتقل میکند. بهجای جستوجوی دستی در نمودارهای پراکنده، مهندسان ارزیابیهای ساختاریافته دریافت میکنند. هوش مصنوعی در اینجا صرفاً نقش مشاور (Advisory) را دارد و تصمیم نهایی همچنان با انسان است؛ رویکردی که نشان میدهد حضور انسان در حلقه (Human-in-the-loop) تنها راهکار قابلاعتماد برای ترمیم سیستمهای عملیاتی AI است. اما این تصمیم اکنون بر اساس دادههای همترازی و ردیابیپذیر گرفته میشود.
مسیر پیادهسازی
تیمهایی که به دنبال پیادهسازی این مدل هستند، باید با یک گردشکار نگهداری واحد در خارج از توابع ایمنی شروع کنند. این فرآیند شامل نقشهبرداری از سلسلهمراتب داراییها، آهنگ سیگنالها (Signal Cadence)، نیازهای ذخیرهسازی و حالتهای عملیاتی است.
بهرهبرداران باید ابتدا آزمایش کنند که آیا Apache IoTDB جذب دادهها و پرسوجوهای همترازی مورد نیاز را فراهم میکند یا خیر. سپس، میتوانند مدل Timer را در برابر دادههای تاریخی نماینده ارزیابی کرده و حد آستانههای مشخصی برای ارجاع به سطوح بالاتر و یک مرحلهی بررسی مستند توسط مهندس ایجاد کنند. هدف این است که جمعآوری و مقایسهی شواهد آسانتر شود، بدون اینکه مرز بین تحلیلهای داده و کنترل ایمنی کمرنگ شود.
باید منتظر بود و دید که چگونه این الگوی «هوش مصنوعی صرفاً مشاور» به صنایع حساس دیگر مانند هوافضا یا فرآیندهای شیمیایی سرایت میکند؛ جایی که مرز بین تحلیل و کنترل ایمنی بهطور مشابه صلب و سختگیرانه است.



گفتگو