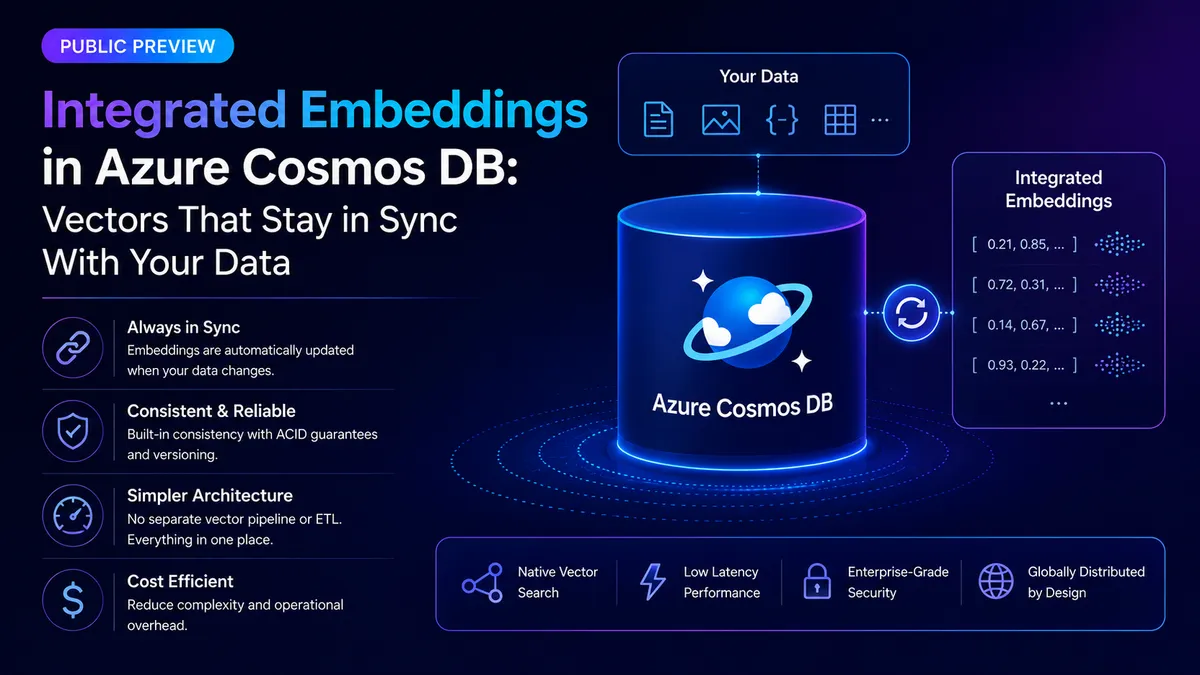
اگر مهندسی هستید که اپلیکیشنهای هوش مصنوعی در مقیاس تولیدی میسازید، احتمالاً بیشترین زمان شما صرف مدیریت همگامسازی دادههای خام با بردارهای معنایی شده است. مایکروسافت با معرفی قابلیت Integrated Embeddings در Azure Cosmos DB، این نقطهٔ اصطکاک را بهطور کامل حذف کرد.
به گزارش مستندات فنی مایکروسافت، این قابلیت که بهتازگی وارد پیشنمایش عمومی (Public Preview) شده، کل چرخهٔ حیات بردارسازی را خودکار میکند. تا پیش از این، توسعهدهندگان مجبور بودند خط لولههای «سایدکار» (Sidecar) پیچیدهای بسازند. این سیستمها تغییرات داده را رصد میکردند، یک مدل بردارساز (Embedding Model) را فراخوانی میکردند و سپس بردارهای حاصل را دوباره در پایگاهداده مینوشتند. در عمل، این خط لولههای دستی باید بتوانند مواردی چون شکستهای سیستمی، تکرار درخواستها (Retries)، محدودیتهای نرخ فراخوانی (Throttling)، مقیاسپذیری و مانیتورینگ را همگام با رشد دادهها و ترافیک مدیریت کنند.
اگر این خط لوله دچار اختلال میشد یا با محدودیت Throttling مواجه میگشت، دانش هوش مصنوعی قدیمی میشد. این امر منجر به توهم (Hallucination) — یعنی زمانی که مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد یا منسوخ شده است، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — در جریانهای تولید بازیابیافزا (RAG) میگشت.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی بازیابی اطلاعات اشاره کردیم، تازگی دادهها در RAG حیاتی است. تصور کنید یک کاتالوگ خردهفروشی دارید که قیمتها یا توضیحات محصولات در آن هر ساعت تغییر میکند. بدون این یکپارچگی، شما به یک شنونده (Listener) سفارشی نیاز داشتید تا برای هر ویرایش تکتک آیتمها، بردارسازی مجدد را تحریک کند. اکنون Azure Cosmos DB این فرآیند بهصورت داخلی مدیریت میکند تا بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — همیشه منعکسکنندهٔ وضعیت فعلی دادهها باشد. این یعنی توسعهدهندگان بهجای درگیر شدن با لولهکشی پیچیدهٔ خط لوله داده، روی ساخت خودِ اپلیکیشن AI تمرکز میکنند.
سازوکار یکپارچهسازی
این اتوماسیون توسط بلوک جدیدی به نام embeddingSource در سیاست برداری (Vector Policy) کانتینر هدایت میشود. سایر بخشهای سیاست — بهویژه مسیر بردار (Vector Path)، ابعاد (Dimensions) و تابع فاصله (Distance Function) — بدون تغییر باقی میمانند. بر اساس مستندات مایکروسافت، این پیکربندی سه مورد حیاتی را به پایگاهداده میگوید: چه چیزی باید بردار شود، از کدام مدل استفاده شود و احراز هویت چگونه باشد.
- مسیرهای منبع (Source Paths): کاربران یک یا چند ویژگی از آیتم را برای بردارسازی در لیست
sourcePathsمشخص میکنند. اگر مسیرهای متعددی لیست شده باشند، دیتابیس مقادیر را با هم ترکیب (Concatenate) کرده و به عنوان یک ورودی واحد به مدل میدهد. این قابلیت بهویژه زمانی مفید است که هیچ فیلد واحدی اطلاعات کافی را حمل نکند؛ برای مثال، ترکیب/titleو/descriptionبرداری غنیتر نسبت به استفاده از یک عنوان کوتاه ایجاد میکند. - منطق ماشه (Trigger Logic): یک آیتم تنها زمانی دوباره بردارسازی میشود که یکی از این ویژگیهای مشخصشده تغییر کند. این بهرهوری تضمین میکند که بهروزرسانی فیلدهای غیر-برداری (Non-embedded fields)، باعث فراخوانیهای غیرضروری و هزینهبر API نشود.
- احراز هویت: در حال حاضر تنها مقدار پشتیبانیشده برای
authTypeگزینه «Entra» (Microsoft Entra ID) است تا ارتباط امن و استانداردی بین پایگاهداده و مدل تامین شود.
جزئیات پیکربندی و نمونهٔ سیاست
تنظیمات از طریق تعریف آرایه vectorEmbeddings در سیاست کانتینر انجام میشود. برای مثال، سیاستی که ویژگی /text را با استفاده از مدل text-embedding-3-small بردارسازی کرده و نتیجه را در /embedding مینویسد، به شکل زیر خواهد بود:
{
  "vectorEmbeddings": [
    {
      "path": "/embedding",
      "dataType": "float32",
      "dimensions": 1536,
      "distanceFunction": "cosine",
      "embeddingSource": {
        "sourcePaths": ["/text"],
        "deploymentName": "text-embedding-3-small",
        "modelName": "text-embedding-3-small",
        "endpoint": "https://<foundry-resource-name>.openai.azure.com/",
        "authType": "Entra"
      }
    }
  ]
}
مدلهای پشتیبانیشده و تنظیمات چندبرداری
این یکپارچگی در حال حاضر از طریق استقرارهای Microsoft Foundry عمل میکند. سیستم از سه مدل بردارساز خاص Azure OpenAI پشتیبانی میکند:
text-embedding-3-small(۱۵۳۶ بُعد)text-embedding-3-large(۳۰۷۲ بُعد)text-embedding-ada-002
توسعهدهندگان میتوانند با افزودن ورودیهای بیشتر به بلوک vectorEmbeddings چندین بردار (Multi-vector) برای هر آیتم تولید کنند. هر ورودی مسیر، مدل و ویژگیهای منبع خاص خود را بهطور موازی حفظ میکند. برای مثال، یک کاربر میتواند همزمان یک بردار /desc_embedding از فیلد /description با مدل text-embedding-3-large و یک بردار /title_embedding از فیلد /title با مدل text-embedding-3-small ایجاد کند.
در ادامه، پیکربندی برای یک setup چندبرداری آورده شده است:
{
  "vectorEmbeddings": [
    {
      "path": "/desc_embedding",
      "dataType": "float32",
      "dimensions": 3072,
      "distanceFunction": "cosine",
      "embeddingSource": {
        "sourcePaths": [ "/description" ],
        "deploymentName": "text-embedding-3-large",
        "modelName": "text-embedding-3-large",
        "endpoint": "https://<foundry-resource-name>.openai.azure.com/",
        "authType": "Entra"
      }
    },
    {
      "path": "/title_embedding",
      "dataType": "float32",
      "dimensions": 1536,
      "distanceFunction": "cosine",
      "embeddingSource": {
        "sourcePaths": [ "/title" ],
        "deploymentName": "text-embedding-3-small",
        "modelName": "text-embedding-3-small",
        "endpoint": "https://<foundry-resource-name>.openai.azure.com/",
        "authType": "Entra"
      }
    }
  ]
}
از بردارها تا عاملهای RAG: مسیر اجرا
مایکروسافت کارایی این سیستم را از طریق یک اپلیکیشن نمونه با پایتون (موجود در گیتهاب در مسیر abhirockzz/integrated-embeddings-sample) نمایش داده است. جریان کار یک توالی دقیق پایان-به-پایان را دنبال میکند:
- پیشنیازها: برای عملکرد صحیح، حساب کاربر باید جستوجوی برداری و حالت Change Feed را فعال کرده باشد و یک استقرار مدل در Microsoft Foundry داشته باشد. بهطور خاص، Managed Identity حساب Azure Cosmos DB باید نقش «Cognitive Services OpenAI User» در منبع Foundry داشته باشد. همچنین کاربر به نقش «Cosmos DB Operator (Azure RBAC)» برای ایجاد دیتابیس و کانتینر، و نقش «Cosmos DB Built-in Data Contributor» برای عملیات Upsert و خواندن آیتمها نیاز دارد.
- استقرار: اپلیکیشن نمونه از پایتون ۳.x استفاده میکند. پس از کلون کردن و نصب نیازمندیها (از طریق
pip install -r requirements.txt)، کاربران فایل.envرا با اندپوینت Azure Cosmos DB و جزئیات استقرار Foundry تنظیم میکنند. کاربران باید برای احراز هویت با دستورaz loginدر Azure CLI وارد شوند. - ایجاد کانتینر: یک اسکریپت، دیتابیس و کانتینری با سیاست
embeddingSourceکه مسیر/descriptionرا هدف قرار داده، میسازد. برای فعالسازی کوئریهای بهینه، از یک ایندکس برداریquantizedFlatروی مسیر/embeddingاستفاده میشود. کانتینر با قابلیت Autoscale روی ۱,۰۰۰ RU/s تنظیم شده است. - درج دادهها: اسکریپت ۱۰۰ آیتم از محصولات فضای باز را از یک فایل
items.jsonوارد (Upsert) میکند. در حالی که آیتمها شامل فیلدهایی مثلid,name,categoryوtagsهستند، طبق سیاست تعریفشده، تنها/descriptionبه مدل ارسال میشود. - تولید نامتقارن: بردارها بهصورت نامتقارن (Asynchronous) تولید میشوند. کاربران میتوانند این موضوع را در Data Explorer پورتال Azure با اجرای کوئری
SELECT VALUE COUNT(1) FROM c WHERE IS_DEFINED(c.embedding)تأیید کنند. زمانی که تعداد به ۱۰۰ رسید، تولید بردارها کامل شده است. - جستوجوی برداری: اپلیکیشن یک عبارت جستوجو (مثلاً «برای سفر اسکی سرد به گرمکن نیاز دارم») را با فراخوانی مستقیم مدل Foundry از طریق یک API Key (
FOUNDRY_API_KEY) بردار میکند و یک کوئریVectorDistance()اجرا میکند. نتایج شامل محصولاتی مانند «Studio Talon Insulated Storm Glove» (امتیاز=۰.۴۹۷۴)، «Prairie Nomad Waterproof Resort Shell Jacket» (امتیاز=۰.۴۹۲۳) و «Everest All-Weather Short 850 Fill Trail Sack» (امتیاز=۰.۴۷۵۶) میشود، با وجود اینکه توضیحات این محصولات دقیقاً شامل کلمات عبارت جستوجو نیستند.
قابلیتهای پیشرفتهٔ جستوجو
در حالی که جستوجوی برداری صرفاً روی شباهت معنایی تمرکز دارد، Azure Cosmos DB for NoSQL ابزارهای دقیقتری را برای افزایش دقت ارائه میدهد:
- جستوجوی ترکیبی (Hybrid Search): برای کوئریهایی که در آنها هم قصد معنایی و هم اصطلاحات خاص اهمیت دارند، سیستم شباهت برداری را با رتبهبندی متن کامل (BM25) با استفاده از Reciprocal Rank Fusion ترکیب میکند.
- فیلترگذاری: کاربران میتوانند بندهای استاندارد SQL
WHEREرا اضافه کنند تا نتایج را پیش از اعمال شباهت برداری، به یک دستهبندی یا تگ خاص محدود کنند. - تنظیم نتایج: اپلیکیشن نمونه به کاربران اجازه میدهد تعداد نتایج بازگشتی را با فلگ
--top-k(که پیشفرض آن ۵ است) کنترل کنند؛ مثلاً جستوجو برای «cookware lightweight for backpacking» با--top-k 3. - انعطافپذیری در کوئری: کاربران میتوانند کوئریهای سبک برنامهریزی (مثلاً «برنامهریزی برای یک پیادهروی طولانی در زمینهای ناشناخته») را برای بازیابی راهنمای مسیرها، یا کوئریهای تجهیزات خاص (مثلاً «سرپناهی که سریع نصب شود برای یک نفر») را برای یافتن چادرهای تکنفره اجرا کنند.
ساخت یک عامل RAG
این لایهٔ بازیابی، زیربنای یک عامل RAG است. با تبدیل جستوجوی برداری به یک ابزار retrieve_context برای یک مدل زبانی (مانند gpt-5.4)، یک عامل LangChain میتواند به سوالات زبان طبیعی پاسخ دهد. این رویکرد شباهت زیادی به سیستمهای ذخیرهسازی وضعیت در ابزارهای کدنویسی AI دارد که برای حفظ حافظه فعال در طول جلسات کاری از مکانیسمهای مشابه بازیابی داده استفاده میکنند.
برای مدلسازی دقیق و جلوگیری از توهم، پرامپت سیستمی مدل را مجبور میکند که تنها محصولات موجود در نتایج بازیابیشده را توصیه کند و هرگونه دستورالعمل موجود در متن بازیابیشده را نادیده بگیرد. برای مثال، اگر کاربر درباره «عینک اسکی با لنز مغناطیسی» بپرسد، جستوجوی برداری ممکن است تمام عینکهای موجود را بازگرداند، اما لایهٔ استدلالی عامل، نتایج را فیلتر کرده و فقط دو مدلی را پیشنهاد میدهد که واقعاً سیستم لنز مغناطیسی دارند. این همان مزیت «بازیابی گسترده، استدلال محدود» در RAG است.
در جریان کار این عامل، FOUNDRY_CHAT_DEPLOYMENT و FOUNDRY_API_KEY در فایل .env مشخص میشوند. در این مرحله، مدیریت امن کلیدهای API بسیار حیاتی است، چرا که به دلیل مخاطرات امنیتی سرورهای ابری، نشت این اطلاعات میتواند منجر به دسترسیهای غیرمجاز شود.
وقتی سؤال شود «چه کیسههای خوابی برای شبهای سرد دارید؟»، عامل سه کیسه خواب پر (Down) مخصوص هوای سرد را بازیابی کرده و ویژگیهای مشترک آنها مانند گرمای 850-fill و کاربردهای خاصشان را لیست میکند.
محدودیتها و پیادهسازی
در زمان پیشنمایش عمومی (Public Preview)، این ویژگی از طریق SDK پایتون Azure Cosmos DB (با استفاده از احراز هویت مبتنی بر کلید) یا SDK مدیریتی در پایتون و جاوااسکریپت (با استفاده از Microsoft Entra ID) در دسترس است.
در حال حاضر چند محدودیت پلتفرمی وجود دارد:
- پشتیبانی پورتال: Data Explorer در پورتال Azure هنوز از پیکربندی یا مدیریت Integrated Embeddings پشتیبانی نمیکند؛ توسعهدهندگان باید از SDKها استفاده کنند.
- CLI/ARM/Bicep: پشتیبانی از Azure CLI، ARM و Bicep برای نسخههای بعدی برنامهریزی شده است.
ساختار هزینهها از «نگهداری خط لوله» به «مصرف خدماتی» تغییر میکند. کاربران هزینه فراخوانیهای استنتاج Microsoft Foundry و واحدهای درخواست (RU) مورد نیاز برای دیتابیس جهت خواندن Change Feed و نوشتن بردارهای بهروزرسانیشده را پرداخت میکنند.
این تغییر عملاً خط لوله بردارسازی را از لایه اپلیکیشن به لایه پایگاهداده منتقل میکند. مایکروسافت با حذف سربار عملیاتی مدیریت شکستها، تکرارها و مقیاسدهی برای حلقه بردارسازی، مانع ورود اپلیکیشنهای RAG از مرحله پروتوتایپ به محیط تولید را کاهش داده است. توسعهدهندگان اکنون میتوانند خط لولههای بردارساز مجزا را حذف کنند و ایندکسهای خود را بهصورت خودکار با افزودن، بهروزرسانی یا حذف محصولات تازه نگه دارند.
گام بعدی شما
- اگر از Cosmos DB استفاده میکنید، بررسی کنید که آیا مدلهای فعلی شما با لیست پشتیبانیشده در Microsoft Foundry همخوانی دارد یا خیر.
- برای کاهش توهمات در عاملهای خود، ترکیب Hybrid Search را با لایههای فیلترینگ SQL تست کنید.
- مستندات SDK پایتون را برای پیادهسازی سیاست
embeddingSourceدر محیط Sandbox مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو