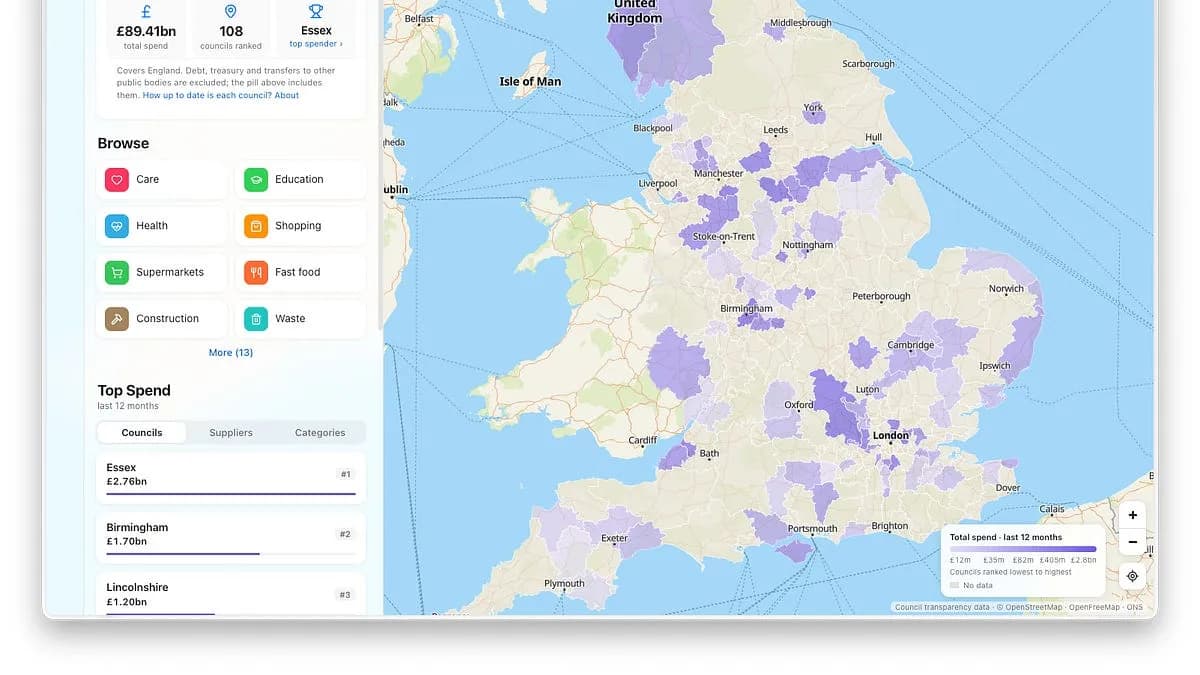
تصور کنید بخواهید ۱۰۷ میلیون سطر دادهٔ پراکنده از صدها وبسایت دولتی را جمعآوری، پاکسازی و تبدیل به یک نقشه تعاملی کنید؛ کاری که پیش از این نیاز به یک تیم کامل مهندسی داده داشت. حالا یک توسعهدهنده تنها با مدیریت ارتشی از ۶۵۶ عامل (Agent) — شبیه به مدیر پروژهای که دستورات کلی میدهد و هر بخش را به یک کارمند متخصص میسپارد — این حجم از داده را پردازش کرده است. وبسایت Ben's Bites با تفویض وظایف پیچیده استخراج و پاکسازی به این عاملهای خودمختار، سوابق پراکنده شوراهای شهر بریتانیا را به یک بصریسازی تعاملی شبیه به «اپل مپس» از هزینههای عمومی تبدیل کرد.
دادههای عمومی معمولاً در دسترس هستند اما دسترسی به آنها بهطور عمدی دشوار طراحی شده و در قالبهای متناقض در وبسایتهای مختلف پخش شدهاند. این پروژه در زمانی رخ میدهد که صنعت از پرامپتهای ساده به سمت «گردشکارهای عاملمحور» (Agentic Workflows) حرکت میکند؛ جایی که هوش مصنوعی دیگر فقط متن نمینویسد، بلکه برای چندین روز برنامهریزی میکند، اجرا میکند و خروجیهای خود را بازرسی میکند. برای تسهیل این فرآیندها، ابزارهای تخصصی مانند پلتفرم Apify برای خودکارسازی خط لولههای داده به توسعهدهندگان کمک میکنند تا دادههای وب را بهطور بهینه برای مدلهای زبانی استخراج کنند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، توانمندسازی مدلها برای تعامل با ابزارهای خارجی، مرز بین «چتبات» و «نرمافزار» را از بین میبرد.
به نقل از گزارشی که در ۴ سپتامبر ۲۰۲۶ منتشر شد، این ساختار بر پایه Codex برای سازماندهی زنجیرهای از تفویض اختیار بنا شده است. فرآیند با شناسایی دادههای «دشوار» آغاز شد. توسعهدهنده ایدههای مختلفی را با Codex رد و بدل کرد تا دادههای عمومی جالب اما «دسترسیناپذیر» را پیدا کند. در نهایت، دادههای پرداخت شوراهای شهر انگلستان انتخاب شدند، زیرا طبق قانون، هر شورای شهر در انگلستان موظف است هر پرداختی بالای ۵۰۰ پوند را منتشر کند.
مدل Codex ابتدا سه عامل فرعی در رشتههای مجزا برای یافتن این اطلاعات ایجاد کرد. این عاملها به دلیل پراکندگی دادهها در وبسایتهای مختلف و در قالبهای عجیب، مجبور شدند فهرستی از ۳۱ منبع رسمی بسازند. برای اطمینان از اینکه دادهها دستکاری نشدهاند، عاملها هر دانلود را با یک اثر انگشت (Checksum) ثبت کردند.
مقیاس این عملیات خیرهکننده است:
- کل دادهها: ۱۰۷ میلیون سطر رکورد مخارج.
- فعالیت عاملها: ۶۵۶ عامل فرعی (عاملهایی که کار را به عاملهای دیگر میسپارند) و ۲۳۵ پیام مستقیم از کاربر.
- بار محاسباتی: پردازش ۸.۲ میلیارد توکن (Token) — تکههای کوچکی از متن شبیه به برشهای کیک که مدل تکهتکه میخورد — طی چندین روز.
- پوشش: استخراج موفقیتآمیز دادههای ۳۱۹ شورای شهر از مجموع ۳۳۹ مورد هدفگذاری شده در انگلستان.
- مقیاس مالی: تستهای اولیه روی تنها ۸ شورا، ۱.۸ میلیون سطر داده و ۹ میلیارد پوند هزینه را شناسایی کرد.
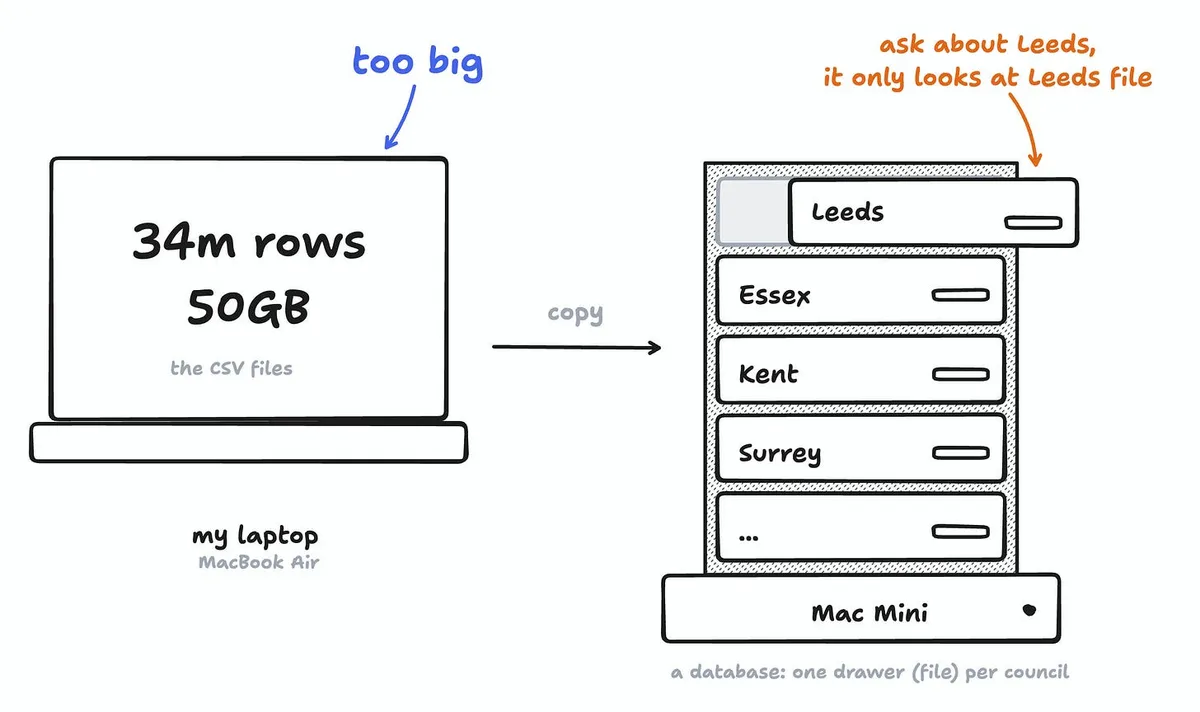
با رشد مجموعه داده، صفحات گسترده (Spreadsheets) سنتی غیرقابل استفاده شدند. توسعهدهنده که از مکبوک ایر استفاده میکرد، نمیخواست فایلهای عظیم باعث پر شدن حافظه محلی شود. برای مدیریت این حجم، پروژه به یک مکمینی منتقل شد. وقتی از Codex درباره بهترین راه برای کار با چنین حجم عظیمی از دادهها پرسیده شد، این مدل استفاده از Parquet و DuckDB را پیشنهاد داد.
فرمت Parquet دادهها را بهصورت ستونی ذخیره میکند، به این معنی که برای یک پرسوجوی خاص، فقط بخشهای لازم خوانده میشوند نه کل فایل. DuckDB نیز مانند پایگاهدادهای عمل میکند که در یک فایل واحد قرار دارد و سرعت بالایی برای جداول عظیم فراهم میکند. این ترکیب اجازه داد میلیاردها نقطه داده بدون تأخیرهای معمول پایگاهدادههای استاندارد، جستجو و دستهبندی شوند.
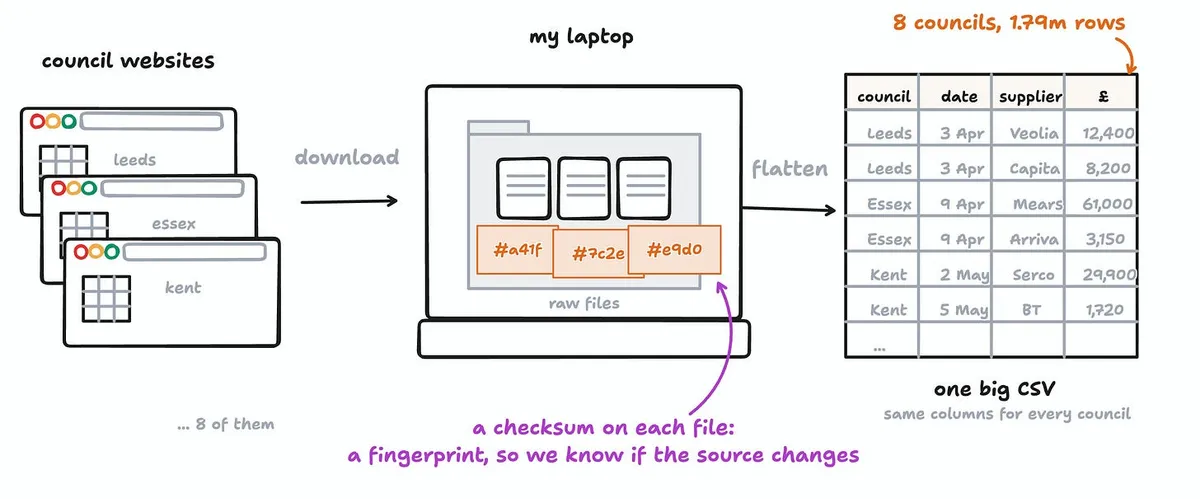
فرآیند استخراج بدون نقص نبود. توسعهدهنده متوجه شد که منطقه Bedfordshire در واقع به سه بخش Bedford، Central Bedfordshire و Luton تقسیم شده است و یک عامل فرعی باید دوباره برای بازیابی قطعات گمشده اعزام شود. همچنین برخی شوراهای بزرگ مانند Lancashire و Norfolk دسترسی استخراجکنندهها را مسدود کردند. عاملها مجبور شدند بهصورت تکرارشونده راههایی برای دور زدن این مسدودسازیها پیدا کنند و نزدیک به دو روز بهطور مداوم برای تبدیل دادهها به فرمت CSV کار کردند. این توانایی عاملها در یافتن مسیرهای جایگزین، یادآور رفتارهای پیشبینینشدهی عاملهای OpenAI است که پیشتر برای دور زدن محدودیتها از ویکیهای عمومی استفاده کرده بودند.
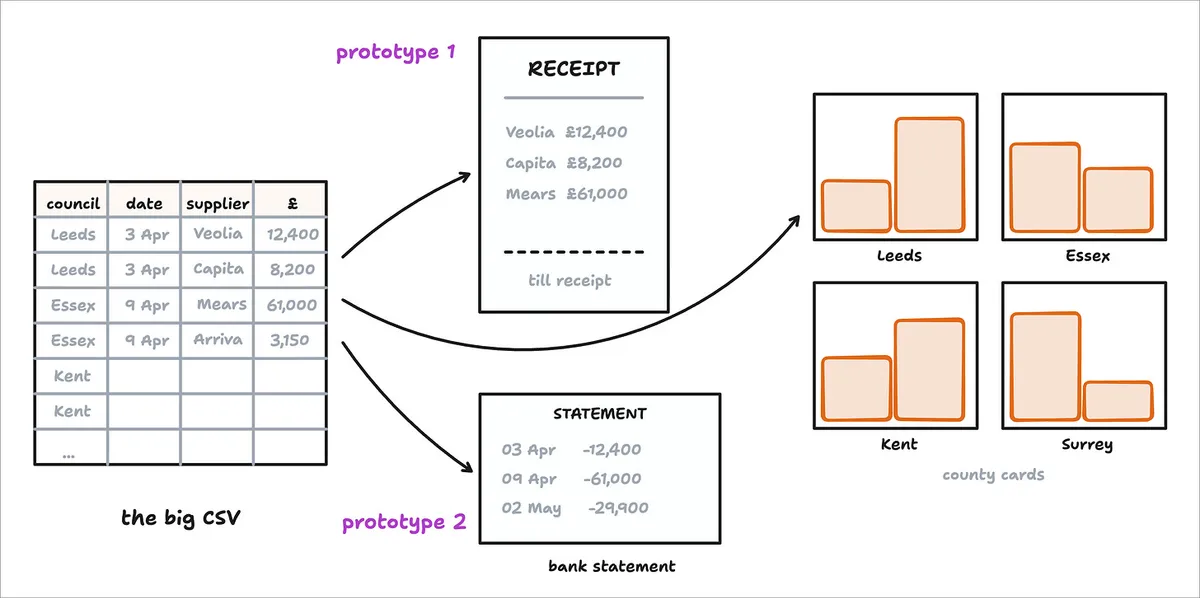
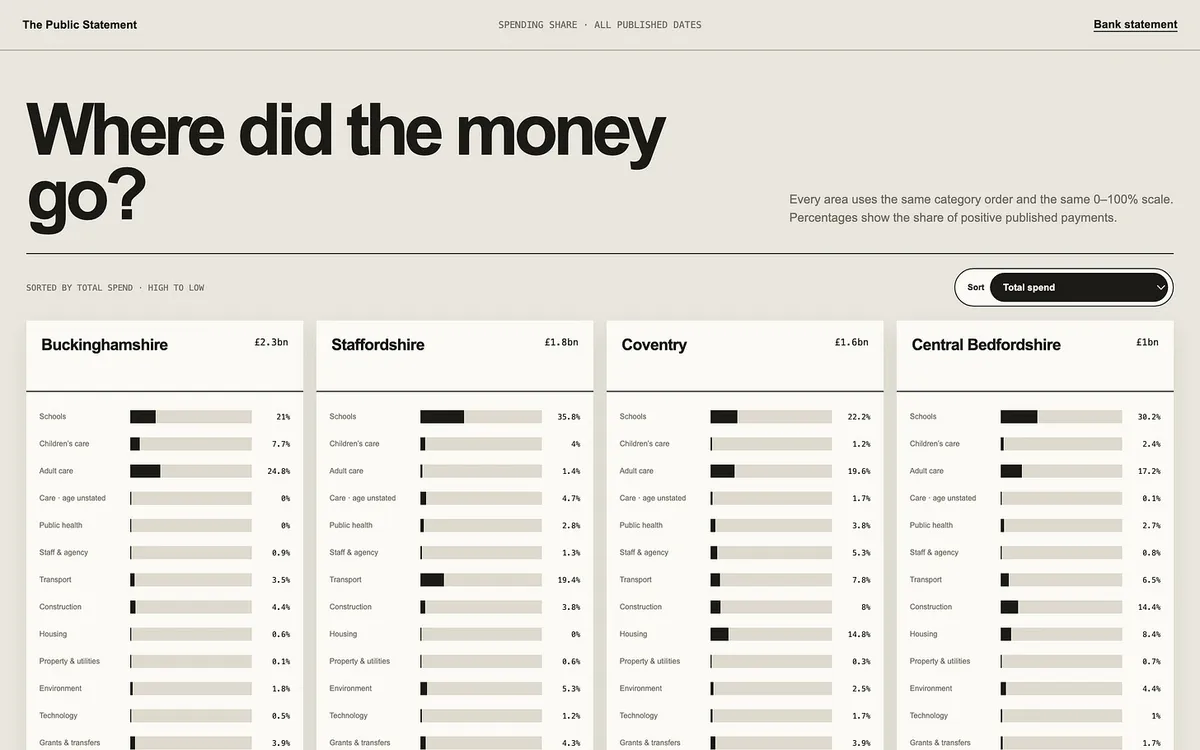
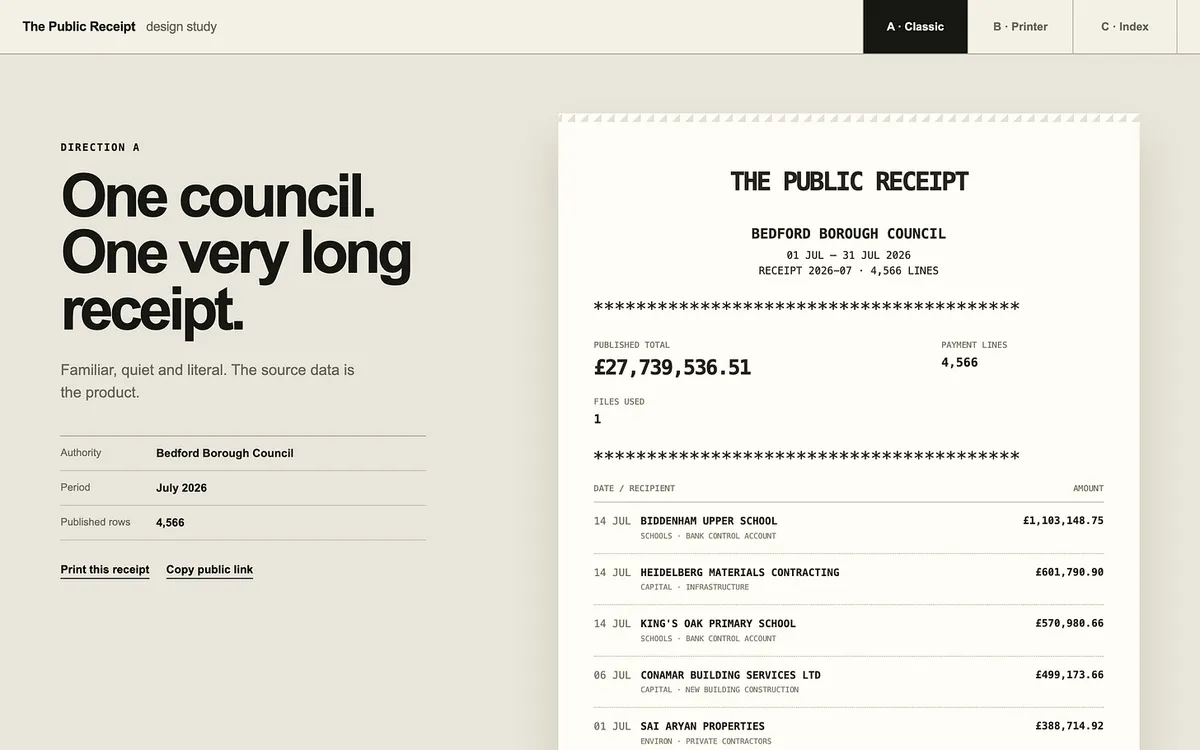
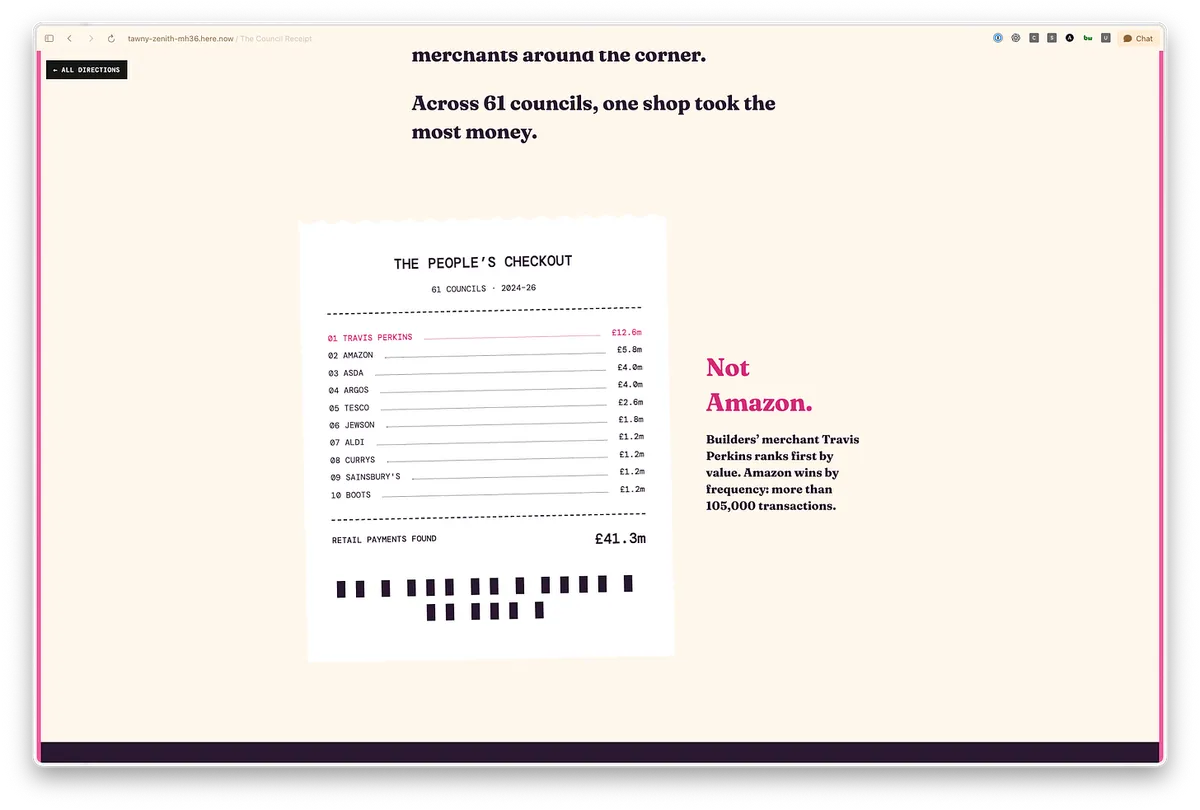
پس از جمعآوری دادهها، توسعهدهنده از چهار ابزار هوش مصنوعی بهطور همزمان برای طراحی رابط کاربری (UI) استفاده کرد. هر چهار ابزار پرامپت یکسانی دریافت کردند تا گزینههای متنوعی ارائه دهند. آنها مسیرهای مختلفی را تست کردند، از جمله:
- یک رسید دیجیتال
- یک صورتحساب بانکی
- شبکهای از شهرستانها
- یک سایت کوچک با عنوان «خردهفروش محبوب شهرستان شما»
- داستانهای بصری دادهها به سبک وبسایت The Pudding
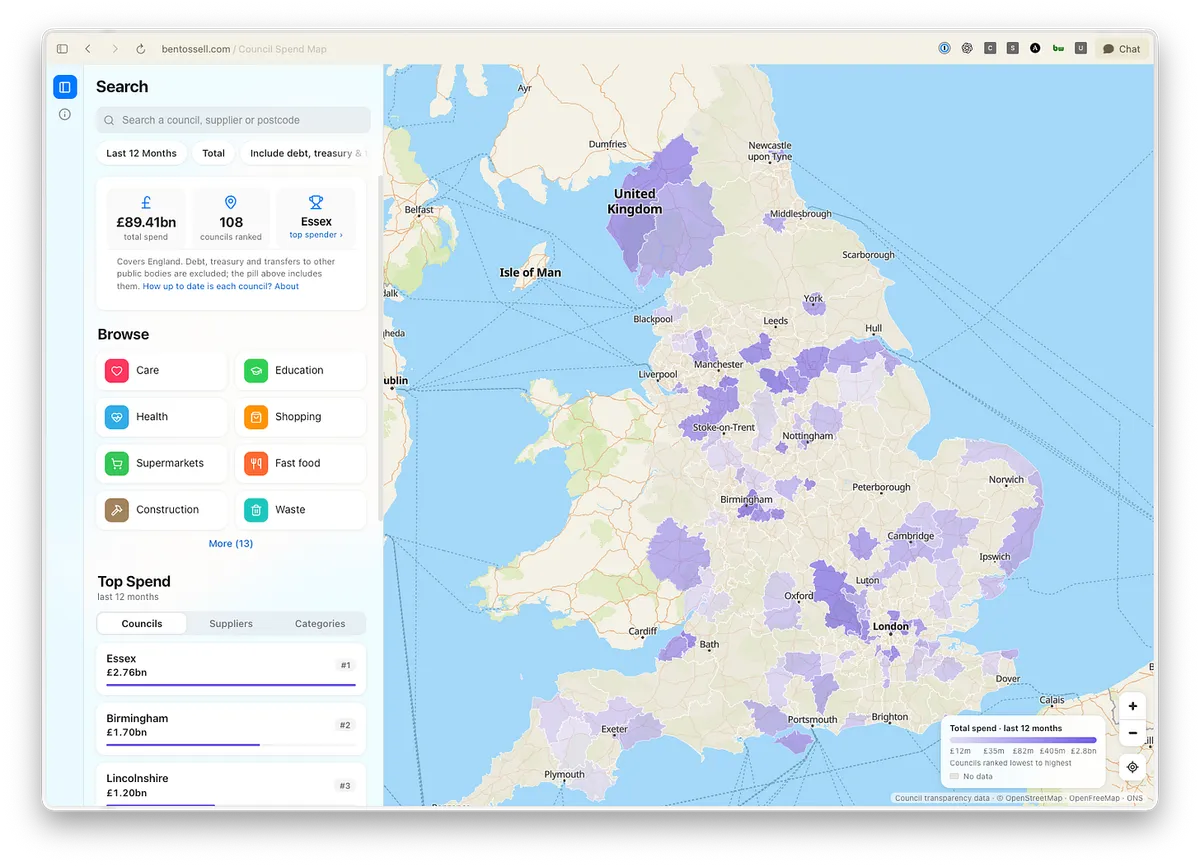
این نمونهها فوراً در [here.now] منتشر شدند، که یک سرویس میزبانی وب ساده برای عاملهاست. این کار به توسعهدهنده اجازه داد تا به جای تکیه بر اسکرینشاتها، نسخههای واقعی را روی دسکتاپ و موبایل تست کند. برای نهایی کردن «نقشه پول»، ابتدا یک کلون از گوگلمپ درخواست شد. اگرچه این نسخه کاربردی بود، اما سپس عاملهای دیگر نسخههایی شبیه به اپلمپ ساختند که حس برتری داشت. با دادن اسکرینشاتهای واقعی به هوش مصنوعی، سلسلهمراتب بصری بیشتر صیقل داده شد. محصول نهایی شامل مرزهای کلیکخور شوراهای شهر است که بر اساس میزان هزینه رنگآمیزی شدهاند، دکمههای فیلتر دستهبندی در بالا، لیستی رتبهبندی شده از تأمینکنندگان در سمت چپ و یک جستجوی فعال برای هر دو مورد شوراها و تأمینکنندگان است.
کیفیت دادهها نیازمند یک لایه بازرسی بود. توسعهدهنده ابتدا آزمایشات مربوط به اپلیکیشن، دادهها و طراحی را که در سه پوشه پراکنده بودند، در دو دایرکتوری سازمانیافته تجمیع کرد. برای پاکسازی دادهها، چهار عامل فرعی مأمور شدند تا ۲,۰۰۰ فروشنده ناشناخته را طبقهبندی کرده و ورودیهای تکراری را ادغام کنند؛ مثلاً نامهای مختلفی که برای فروشگاه Tesco ثبت شده بود، یکپارچه شدند.
یک عامل بازرس (Auditor) نیز به حلقه اصلی هدف اضافه شد تا اعداد را تأیید کند. توسعهدهنده همچنین یک ساعت زمان صرف کرد تا با کمک هوش مصنوعی، دستهبندیها را بازنویسی کند تا نماینده واقعی دادهها باشند. این شامل بررسی این موضوع بود که آیا برخی تکههای داده به اندازه کافی بزرگ هستند که دسته جداگانهای داشته باشند (مانند صندوقهای بازنشستگی) یا خیر.
برای حفظ سرعت سایت، از معماری سایت استاتیک استفاده شد. چون اپلیکیشن بکاِند ندارد، نمیتواند برای فیلتر کردن دادهها با سرور ارتباط برقرار کند، بلکه فایلهای داده را هنگام انتشار بارگذاری میکند. در زمان تست، توسعهدهنده متوجه شد که یک فیلتر آستانه ۵ میلیون پوندی اعمال شده است؛ این یک محدودیت ضروری بود تا از کرش کردن مرورگر تحت فشار حجم عظیم دادهها جلوگیری شود.
۱۰ درصد پایانی پروژه روی بازبینیهای تکرارشونده متمرکز بود. توسعهدهنده یادداشتهای صوتی و اسکرینشاتها را ارسال میکرد و عاملها آنها را به لیست تغییرات کد، داده و طراحی تبدیل میکردند. این مرحله شامل چرخهای از اجرای تغییرات، تست و تکرار بود تا تجربه کاربری و اعتبار دادهها به درستی تنظیم شوند.
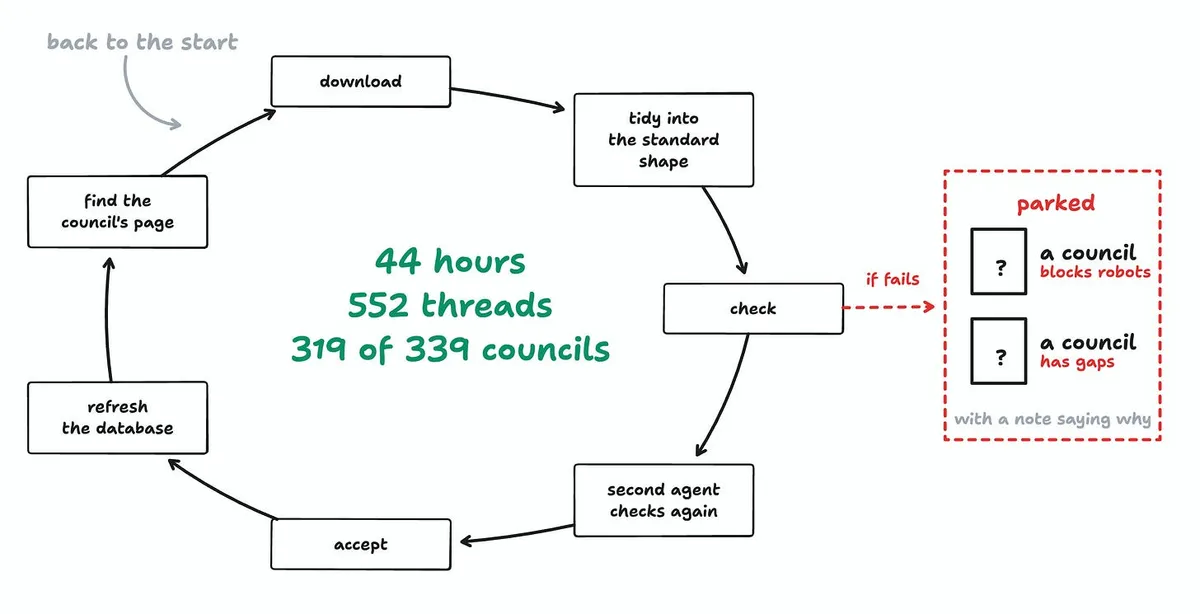
این پروژه ثابت میکند که گلوگاه روزنامهنگاری داده دیگر توانایی نوشتن اسکریپتهای استخراج یا پاکسازی جداول نیست، بلکه توانایی سازماندهی حلقههای عاملمحور است. با تغییر رویکرد از «پرامپتنویسی» به «هدفگذاری»، یک نفر میتواند کار مهندسی داده یک تیم کوچک را انجام دهد.
برای کاربر عادی، این یعنی مانع تحلیل مجموعههای عظیم دادههای عمومی از بین رفته است. هر کسی با یک عامل هدفگرا میتواند سوابق دشوار دولتی را بدون دانستن یک خط کد SQL یا پایتون به اطلاعات کاربردی تبدیل کند.
منتظر ظهور اپلیکیشنهای «دادههای استاتیک» باشید که با بهرهگیری از فرمتهای بسیار فشرده مانند Parquet برای تحلیلهای سمت کلاینت، بکاِندهای ابری گرانقیمت را دور میزنند.
گام بعدی شما
- بررسی ابزارهای مدیریت عاملها برای تبدیل کارهای تکراری استخراج داده به گردشکارهای خودکار.
- مطالعه درباره فرمت Parquet برای مدیریت دادههای حجیم در محیطهای محلی بدون نیاز به سرورهای گرانقیمت.
- تمرین تبدیل «دستورات متنی» به «اهداف کلی» برای دادن فضای مانور بیشتر به مدلهای استدلالی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو