
اگر امروز برای مدیریت حافظهٔ عاملهای هوش مصنوعی خود به ابزارهای پیچیده یا باتهای بستهٔ پلتفرمها تکیه میکنید، احتمالاً بخشی از کنترل روی خروجیها را از دست دادهاید. یک پوشهٔ ساده از فایلهای متنی میتواند از پیچیدهترین سامانههای حافظه پیشی بگیرد، بهشرطی که کاربر مالکیت کامل بر آنچه عامل به یاد میآورد داشته باشد.
بنبایتس (Ben's Bites) در ۲۱ اوت ۲۰۲۶ این معماری سبک را تشریح کرد و استدلال نمود که حافظهٔ خودکار اغلب منجر به پاسخهای «هدایتشده» میشود که خلاقیت را میکشد. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، شفافیت در لایهی داده، کلید دستیابی به نتایج قابلپیشبینی است.
بسیاری از کاربران با عاملهای هوش مصنوعی مانند جعبههای سیاه برخورد میکنند یا از باتهای بومی پلتفرمها استفاده میکنند که دستورالعملهای زیربنایی را پنهان میکنند. این وضعیت باعث وابستگی به رابط کاربری ارائهدهنده میشود، نه یک سیستم قابلحمل که کاربر واقعاً مالک آن باشد. برای کسانی که از کلود (Claude) یا چتجیپیتی (ChatGPT) استفاده میکنند، قدرت واقعی در متصل کردن مدل به یک دایرکتوری محلی از زمینههای منتخب است. به نقل از نویسنده، مکانیزم کار در هر دو پلتفرم یکسان است: همه چیز به فایلها، پوشهها، ابزارها و دستورالعملها برمیگردد.
ساختار هستهٔ فایلها
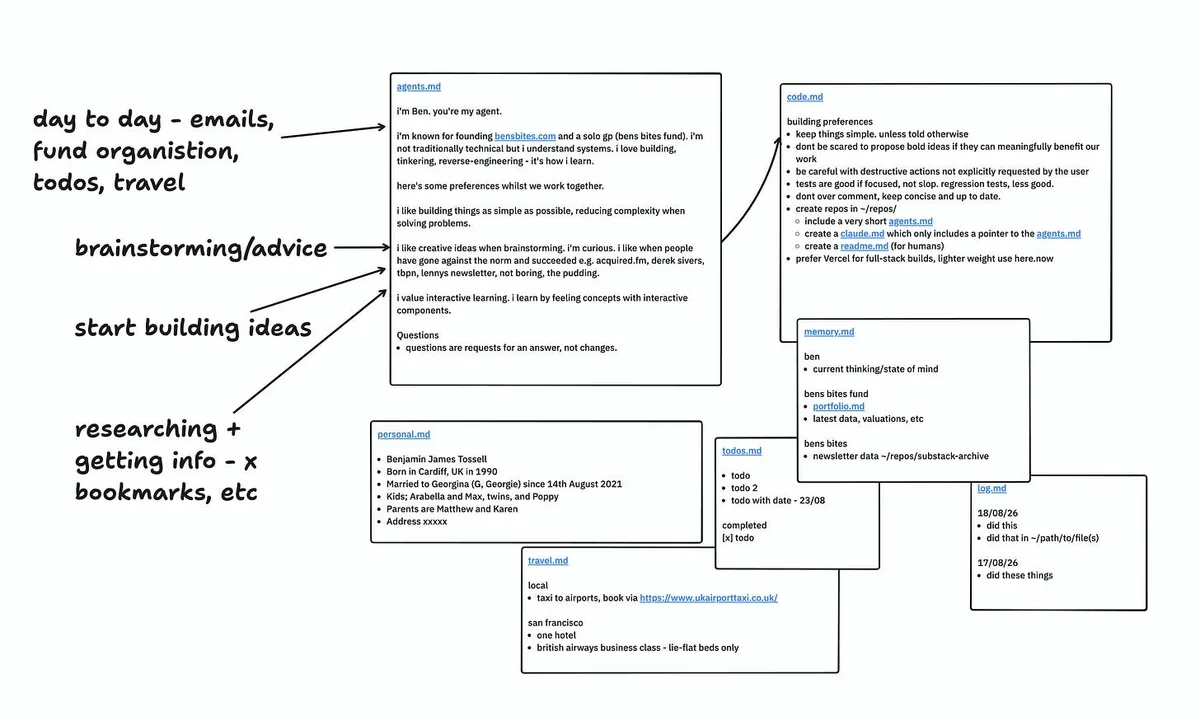
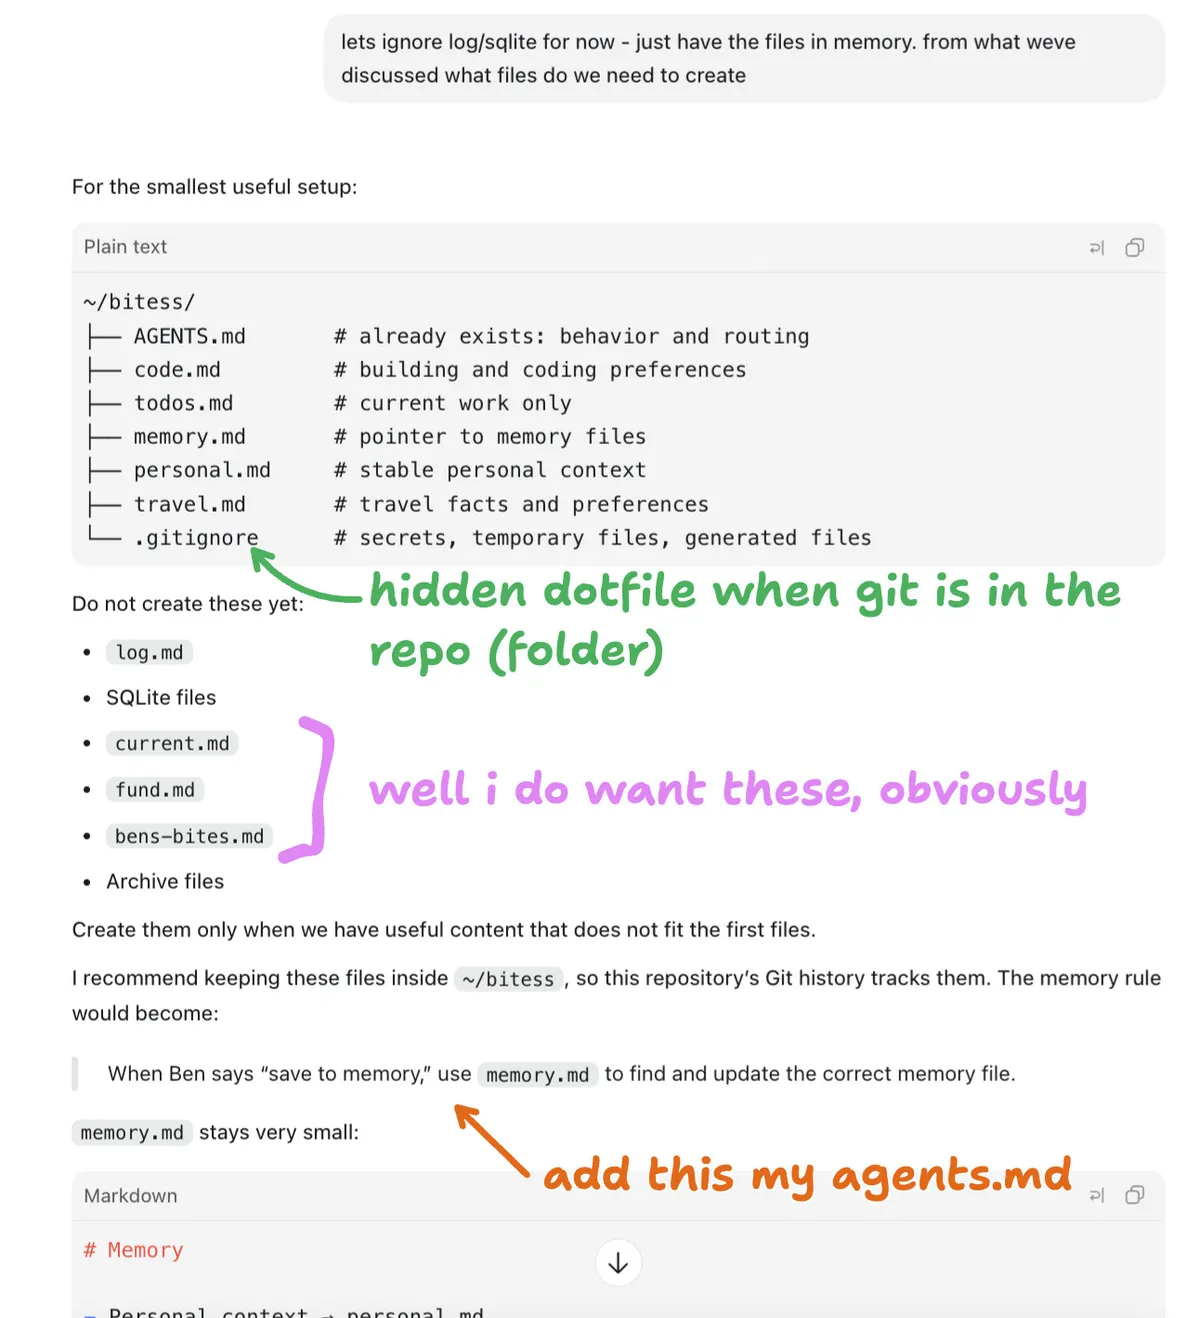
برای پیادهسازی این سیستم، نویسنده پوشهای اختصاصی شامل پنج فایل اصلی Markdown ایجاد کرد. این ساختار، هویت، ترجیحات فنی و وظایف فعال را از هم جدا میکند تا پنجرهٔ زمینه (Context Window) — که مثل میز کاری است که جا برای چند ورق دارد، نه برای کل کتابخانه — تمیز بماند:
- AGENTS.md: فایل دستورالعملهای اصلی. این فایل تعریف میکند کاربر کیست، عامل چگونه باید تعامل کند (مثلاً تضمین کند که سؤالات با پاسخ مواجه شوند، نه با تغییرات ناخواسته در متن) و به سایر فایلها اشاره میکند.
- code.md: فضایی اختصاصی برای ترجیحات ساخت و توسعه، مانند اولویت استفاده از ورسل (Vercel) و سوپابیس (Supabase).
- todos.md: سندی زنده برای کارهای جاری و وظایف فعال که بهطور مداوم بهروزرسانی میشود.
- memory.md: فایلی برای ارجاع به حافظههای خاص. این فایل مانند یک راهنما عمل میکند و عامل را به فایلهای حافظهٔ دیگر هدایت میکند؛ مواردی مثل ترجیحات سفر، جزئیات مربوط به ماهیت Ben's Bites یا اطلاعات مربوط به صندوق سرمایهگذاری نویسنده.
- log.md: در ابتدا برای ثبت جلسات طراحی شده بود، اما بعداً بهدلیل وجود تاریخچهٔ گیت، زائد تشخیص داده شد.
یکپارچگی با گیت (Git)
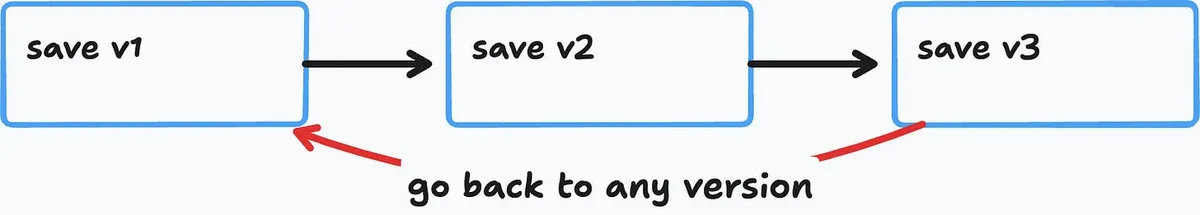
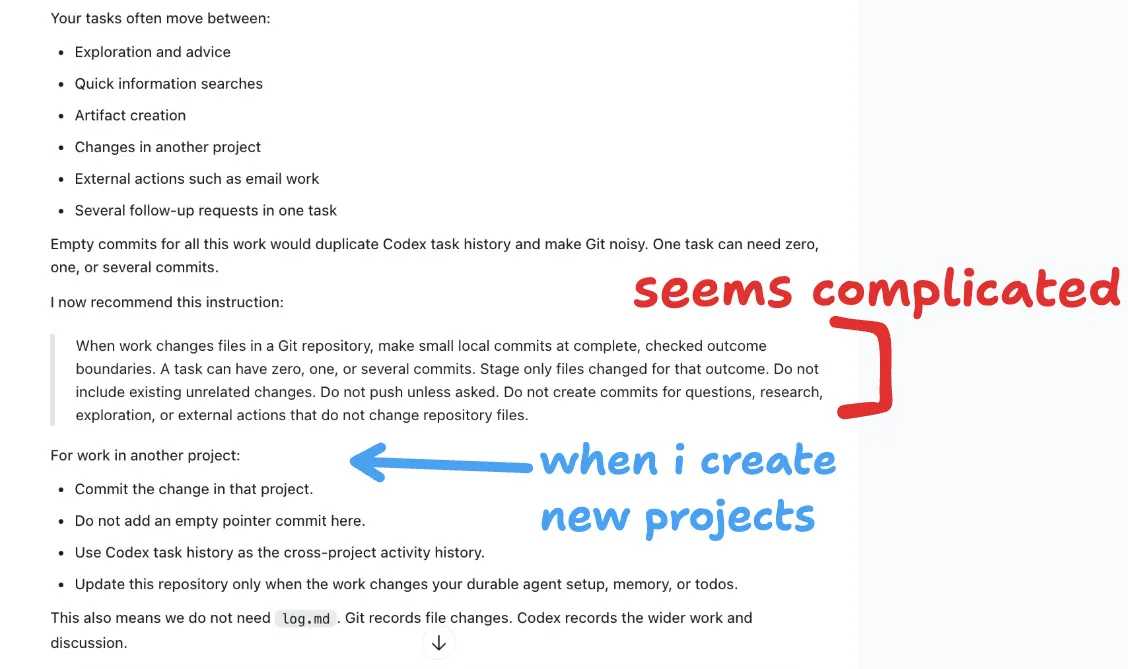
این سیستم بهجای استفاده از پایگاهدادههایی مثل اسکیلایت (SQLite) برای ردیابی تاریخچهٔ چت، از گیت (Git) بهره میبرد. با تبدیل پوشهٔ عامل به یک مخزن (Repo)، هر تغییر به یک «کامیت» تبدیل میشود.
این رویکرد به عامل اجازه میدهد تا از تاریخچهٔ گیت برای مشاهدهٔ دقیق تغییرات در یک فایل — یا همان diff (خطوط متنی که دقیقاً تغییر کردهاند) — استفاده کند، بدون اینکه به فایل لاگ جداگانه نیاز داشته باشد. طبق گزارش نویسنده، عاملها بهطور طبیعی در استفاده از گیت مهارت دارند و این روش برای مدیریت نسخهها بسیار کارآمدتر از ثبت دستی است. اگر تغییرات در فایلها و پوشهها کامیت شوند، تاریخچهٔ نسخههای قبلی از پیش موجود است و در نتیجه فایل log.md عملاً یک مورد تکراری و غیرضروری میشود.
تلهٔ حافظه
یکی از حیاتیترین یافتهها در این چیدمان، خطر «ذخیرهسازی خودکار» حافظه است. اگرچه ایدهٔ عاملی که هر روز با خواندن متن یاد میگیرد جذاب است، اما اغلب یک حلقهٔ بازخورد ایجاد میکند که در آن هوش مصنوعی بیش از حد به ترجیحات قبلی میچسبد.
وقتی به عامل گفته میشود زمینههای مهم را بهطور خودکار ثبت کند، شروع به تغییر مسیر جلسات طوفان فکری کاربر میکند. مدل ممکن است مسیرهایی را پیشنهاد دهد که «فکر میکند» کاربر دوست دارد، بهجای آنکه ایدههای جدید را بررسی کند. نویسنده این وضعیت را «گیر کردن در یک مسیر خاص» (Lane) توصیف میکند، زیرا عامل بر اساس ترجیحات ثبتشده عمل میکند. برای حل این مشکل، او به کوچکترین فایلهای ممکن با کمترین مقدار زمینه روی آورد که فقط در صورت نیاز یا هنگام تولید پاسخهای نامطلوب، بهصورت دستی بهروزرسانی میشوند.
مدیریت تاریخچهٔ جلسات
کاربران اغلب میپرسند چگونه به گفتگوهای قبلی ارجاع دهند، مثلاً بپرسند: «هفته پیش درباره [فلان موضوع] چه گفتیم؟». نویسنده توضیح میدهد که عاملها تمام جلسات چت را در فایلهایی روی کامپیوتر ذخیره میکنند که مستقیماً قابل جستوجو هستند.
این فایلها معمولاً بهصورت فایلهای پنهان (dot files) در دایرکتوریهایی مثل ~/.agents/ یا ~/.codex/ یا ~/.claude/ ذخیره میشوند. این فایلها در مک با فشردن cmd+shift+. در Finder قابل مشاهدهاند. چون عامل میتواند این جلسات قدیمی را جستوجو کند، دیگر نیازی به ذخیرهٔ دستی خلاصهها در یک فایل حافظهٔ مجزا نیست.
مدیریت شخصیتهای عامل
بسیاری از پلتفرمها ایجاد باتهای نامگذاریشده را تشویق میکنند (مثلاً «امیلی» برای ایمیلها یا «اندی» برای حسابها). نویسنده استدلال میکند که اینها صرفاً جلسات چتی با دستورالعملهای خاص هستند تا افراد غیرفنی احساس کنند همتیمی دارند. این رویکرد در تضاد با سیستمهای پیچیدهتری است که در طراحی اتوماسیون مدیریتی آریمورا با مدلهای GPT-5.6 مشاهده شد، جایی که از چندین عامل مجزا برای مدیریت وظایف استفاده شده است.
بهجای باتهای مجزا، این سیستم از «فایلهای مهارت» استفاده میکند. یک فایل skill.md در واقع یک شرح شغلی یا مجموعهای از دستورالعملها برای یک فرآیند تکرارپذیر است، مانند مدیریت کتابها یا آرشیو کردن ایمیلها. اگر کاربر به یک عامل ایمیل نیاز دارد، بهسادگی فایل مهارت ایمیل را به عامل میدهد. این کار معماری را تخت و قابلمدیریت نگه میدارد و نیاز به پلتفرمهای پیچیده مثل Grok Bot را از بین میبرد.
پیادهسازی در کلود و چتجیپیتی
در کلود، سیستم به یک ترفند کوچک نیاز دارد چون مدل بهطور خاص بهدنبال فایل CLAUDE.md میگردد. نویسنده این مشکل را با تبدیل CLAUDE.md به یک ارجاع ساده حل کرد که به مدل میگوید بهجای آن، فایل @AGENTS.md را بخواند.
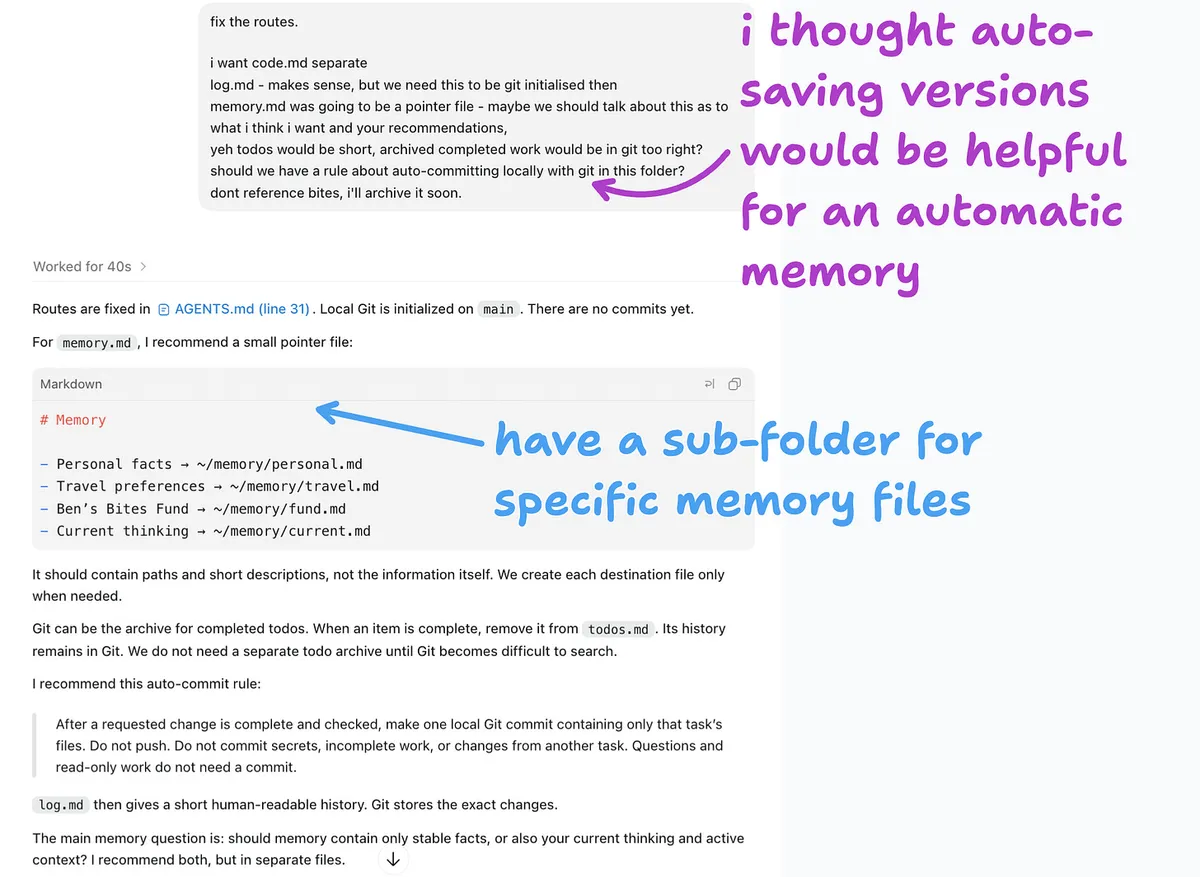
این ساختار در Claude Cowork و ChatGPT Work بهطور یکسان عمل میکند. با سازماندهی فایلهای حافظه در یک زیرپوشه، کاربر میتواند یک حافظهٔ مشترک کلی (کیست و چه میخواهد) داشته باشد و در عین حال به وظایف خاص، زمینهٔ ایزوله بدهد. برای مثال، عامل «امیلی» فقط متون مربوط به ایمیلها را میخواند، اما همچنان به پوشهٔ سطح بالاتر برای اطلاعات کلی کاربر دسترسی دارد. این تلاش برای بهینهسازی لایههای دسترسی، یادآور رقابتهای جاری برای کاهش هزینههای زیرساختی در اکوسیستمهای عاملمحور است تا بهرهوری مدلها افزایش یابد.
اجتناب از عامل «بلهقربانگو»
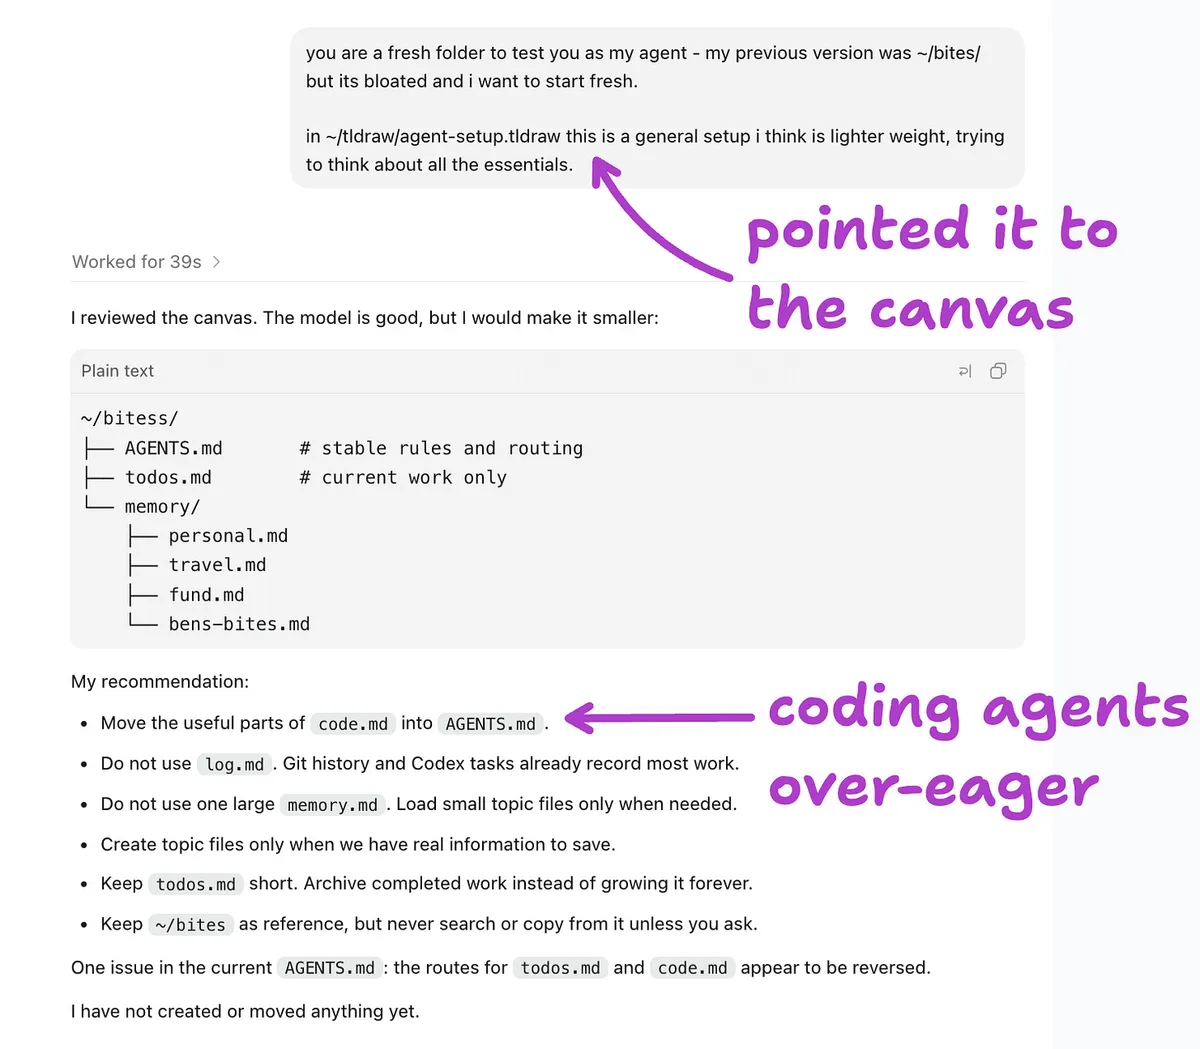
یک چالش تکرارشونده این است که عاملها بهطور طبیعی تمایل به موافقت دارند. وقتی نویسنده از Codex — نسخهٔ کدنویسی عامل — استفاده کرد، مدل مدام دستورالعملهای پیچیدهٔ auto-commit و یکپارچگی با پایگاهداده را پیشنهاد میداد، چون در دستورالعملهای سیستمیاش صراحتاً ذکر شده: «تو یک عامل کدنویسی هستی».
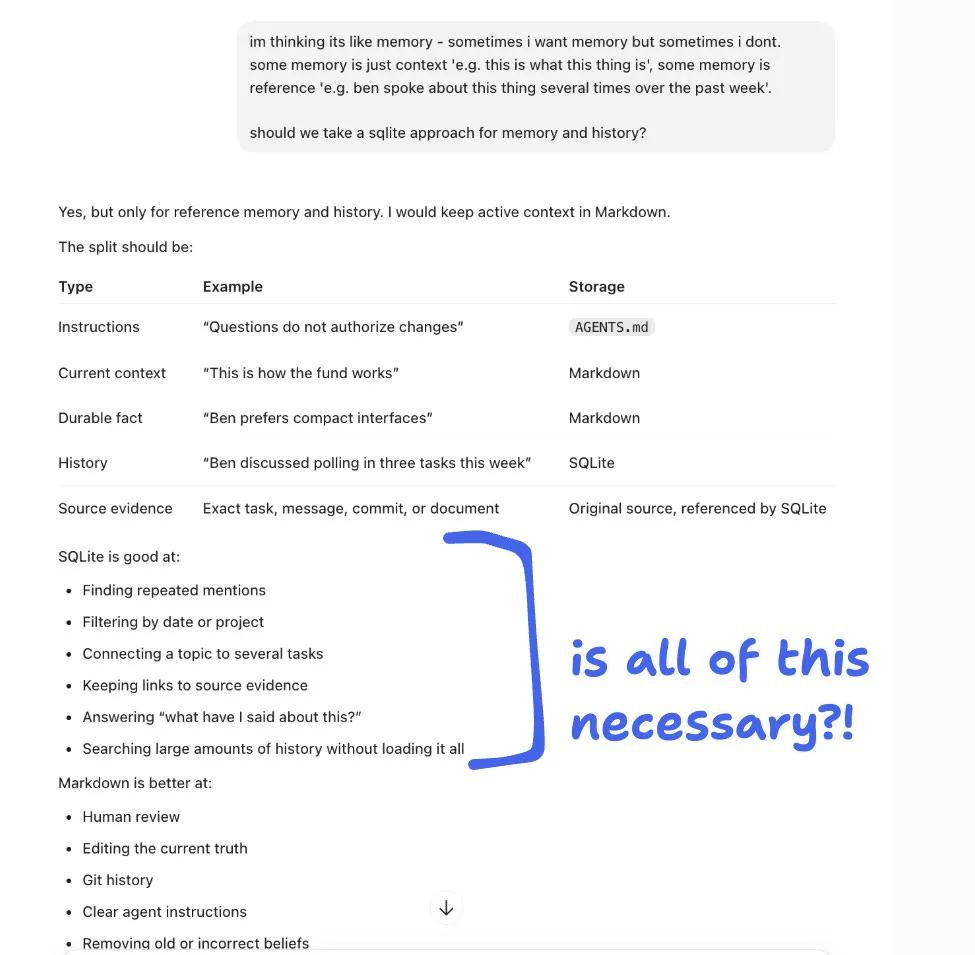
مدل Codex حتی پیشنهاد کرد از اسکیلایت (SQLite) — پایگاهدادهای که مثل یک صفحهٔ گسترده با جدولهایی از ردیفها (شامل شناسههای رشته و تاریخها) است — برای جستوجوی جلسات بهجای بارگذاری فایلها در زمینه استفاده شود. نویسنده به کاربران هشدار میدهد که تمایلات «کدنویس مشتاق» هوش مصنوعی را نادیده بگیرند. بهجای پذیرش هر پیشنهاد، باید دربارهٔ هزینهها و مزایا (trade-offs) سؤال کنید و خودتان تصمیم بگیرید چه چیزی برای گردشکار شما ضروری است.
زمینه و ظرافتهای فنی
برای بهینهسازی سیستم، نویسنده چتهای اخیر را تحلیل کرد تا الگوهای کلی وظایف را شناسایی کند. این تحلیل نشان داد که عامل تمایل دارد پیچیدگی فنی را بر سادگی ترجیح دهد. برای مثال، عامل پیشنهاد داد که ترجیحات ساخت را مستقیماً در فایل دستورالعمل اصلی ادغام کند. نویسنده این پیشنهاد را رد کرد، زیرا عامل شخصی او برای کارهایی فراتر از صرفاً کدنویسی استفاده میشود.
منطق جزئی سیستم
- مکانیزم ارجاع: بهدلیل اینکه کلود بهطور سختافزاری (hard-coded) بهدنبال
CLAUDE.mdمیگردد، نویسنده از یک اشارهگر استفاده میکند. تنها متن موجود درCLAUDE.mdدستوری است برای خواندن@AGENTS.md. - سلسلهمراتب حافظه: حافظه در یک زیرپوشه سازماندهی شده است. این اجازه میدهد «حافظه مشترک» (اطلاعات کلی کاربر) در سطح بالاتری از درخت پوشهها قرار گیرد، در حالی که عاملهای خاص (مثل بات ایمیل) فایلهای حافظه ایزوله خود را داشته باشند.
- سوگیری Codex: استفاده از نسخههای تخصصی کدنویسی مانند Codex بر پیشنهادات عامل تأثیر میگذارد. چون به او گفته شده «تو یک عامل کدنویسی هستی»، هر مشکلی را از دریچه فنی میبیند و منجر به پیشنهادات غیرضروری مثل استفاده از SQLite برای ردیابی ساده جلسات میشود.
- کامیتهای دستی: بهجای ذخیره خودکار، نویسنده فایلها را بهصورت دستی ویرایش کرده و سپس یک «کامیت» انجام میدهد تا کار در تاریخچه گیت ذخیره شود.
این رویکرد دستی و فایلمحور، هوش مصنوعی را از یک سرویس مرموز به ابزاری شفاف تبدیل میکند و تضمین میکند که انسان، ویراستار حافظهٔ دیجیتال خود باقی بماند. برای بهینهسازی عامل خود، با بررسی تاریخچه چتهای فعلی شروع کنید تا ببینید کدام وظایف تکراری را میتوان به یک فایل skill.md تبدیل کرد.
گام بعدی شما
- تاریخچهٔ چتهای فعلی خود را بررسی کنید تا متوجه شوید کدام وظایف تکراری را میتوان به یک فایل
skill.mdتبدیل کرد. - یک پوشهٔ محلی ایجاد کرده و دستورالعملهای اصلی خود را در فایل
AGENTS.mdبنویسید تا از وابستگی به حافظهٔ داخلی پلتفرمها رها شوید. - برای هر پروژه یا مهارت خاص، یک فایل Markdown مجزا بسازید تا پنجرهٔ زمینهٔ مدل با اطلاعات غیرضروری پر نشود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو