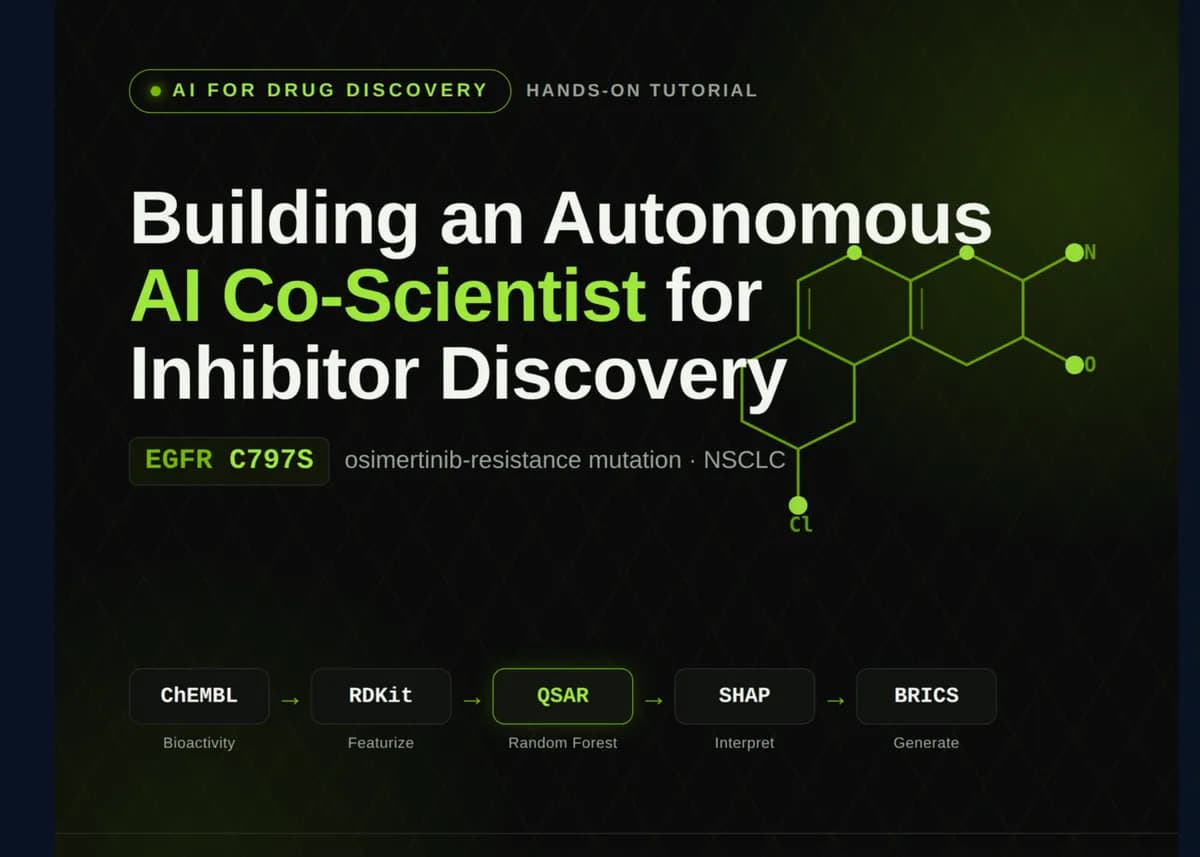
تصور کنید بتوانید قطعات یک پازل شیمیایی را جابهجا کنید تا کلیدی بسازید که قفلهای مقاومترین تومورهای سرطانی را باز کند. اگر در حال حاضر با محدودیتهای دارویی در درمان سرطان ریه مواجهید، باید بدانید که هوش مصنوعی اکنون از نقش یک «پیشبین» ساده به یک «طراح فعال» تغییر جایگاه داده است. در حالی که کشف سنتی داروها اغلب بر پیشبینیهای ساده متکی است، یک گردشکار جدید «همکار-دانشمند» (AI co-scientist) خودکار، پارادایم را به سمت طراحی مولد فعال تغییر داده است. این خط لوله با ترکیب مجدد قطعات مولکولی از داروهای قدرتمند شناخته شده، اکنون میتواند مهارکنندههای بالقوه نسل چهارم EGFR را طراحی کند که بهطور خاص جهش C797S را هدف قرار میدهند؛ جهشی که عامل اصلی مقاومت به داروی «اوسیمرتینیب» در سرطان ریه سلول غیرکوچک (NSCLC) است.
کشف دارو اغلب زمانی به بنبست میرسد که تومورها جهشهایی ایجاد کنند که لنگرهای کووالانسی مورد استفاده در درمانهای موجود را از بین ببرد. در این مورد خاص، جهش C797S لنگر سیستئین را حذف میکند و باعث میشود مهارکنندههای نسل سوم بیاثر شوند. این چارچوب محاسباتی که در یک آموزش فنی اخیر توسط Marktechpost با جزئیات شرح داده شده است، نقشهای راه برای دور زدن این مانع بیولوژیکی خاص با استفاده از ابزارهای متن-باز (open-source) ارائه میدهد. این رویکرد با استفاده از ابزارهای باز، مشابه گامهای تکمیلی است که در توسعه ابزارهای متنباز انویدیا برای کاهش نرخ خطای مدلهای زیستمولکولی مشاهده میکنیم تا دقت پیشبینی در سطح مولکولی افزایش یابد.
هوشمندی هدف و استخراج دادهها
فرآیند با شناسایی هدف از طریق ChEMBL (با استفاده از شناسه CHEMBL203) و UniProt برای جداسازی سوابق فعالیت بیولوژیکی IC50 مربوط به EGFR آغاز میشود. سیستم بهگونهای طراحی شده است که «گیرنده فاکتور رشد اپیدرمال» (EGFR) را بر اساس حجم دادهها بهطور خودکار شناسایی کند تا اطمینان حاصل شود که هدف با غنیترین دادهها انتخاب شده است. این سیستم بهطور خاص رکوردهایی را استخراج میکند که در آنها مقدار pchembl_value تهی (null) نباشد و از یک مکانیسم جایگزین (fallback) برای تضمین سازگاری دادهها استفاده میکند.
برای ایجاد زمینه بیولوژیکی، گردشکار با استفاده از شماره دسترسی UniProt استخراجشده، API مربوط به UniProtKB را فراخوانی میکند. این کار باعث بازیابی توصیف عملکردی پروتئین هدف میشود و به همکار-دانشمند AI اجازه میدهد هدف پژوهشی را تعریف کند: یادگیری شیمی مهارکنندههای شناخته شده برای پیشنهاد آنالوگهای جدید و دارو-مانند به عنوان نقاط شروع برای یک سری نسل چهارم فعال در برابر C797S.
سپس سیستم این رکوردهای خام را به یک مجموعه داده پاک از pIC50 تبدیل میکند. برای تضمین اعتبار علمی، فیلترهای کیفی سختگیرانهای اعمال میشود: تنها روابط استاندارد «=» (دقیق) نگه داشته میشوند و اندازهگیریها باید حتماً در واحدهای نانومولار (nM) باشند. این کار مانع از آن میشود که مدل روی مقادیر قدرت نامprecise یا ناسازگار آموزش ببیند. خط لوله برای استخراج تا ۹۰۰۰ رکورد خام (MAX_ACTIVITIES) پیکربندی شده است تا نمونهبرداری قدرتمندی از فضای شیمیایی صورت گیرد.
کیوریتوری و نمایش مولکولی
برای جلوگیری از اینکه مدل صرفاً مولکولهای مشابه را حفظ کند، گردشکار از RDKit برای استانداردسازی مولکولی استفاده میکند. این فرآیند شامل چندین مرحله پیشپردازش حیاتی است:
- انتخاب قطعه (Fragment Selection): از
LargestFragmentChooserوUnchargerبرای حذف نمکها و قطعات کوچکتر استفاده میشود تا اطمینان حاصل شود مدل هسته دارویی فعال را تحلیل میکند. - تجمیع (Aggregation): مولکولهای تکراری از طریق تجمیع اندازهگیریهای تکراری با استفاده از مقدار میانه pIC50 مدیریت میشوند.
- فیلتر اندازه: مولکولهایی با کمتر از ۶ اتم سنگین حذف میشوند تا قطعات کوچک غیرمرتبط از نظر بیولوژیکی کنار گذاشته شوند.
- مهندسی ویژگیها: هر مولکول به یک اثر انگشت مورگان ۲۰۴۸ بیتی باینری (با شعاع ۲) و ۱۰ توصیفگر فیزیکوشیمیایی خاص تبدیل میشود:
- وزن مولکولی (MolWt)
- ضریب تقسیم اکتان (LogP)
- سطح پلار توپولوژیک (TPSA)
- دهندهها (HBD) و پذیرندههای پیوند هیدروژنی (HBA)
- تعداد پیوندهای چرخشی (RotB)
- تعداد حلقههای آروماتیک
- کسر کربنهای sp3 (FracCSP3)
- تعداد اتمهای سنگین
- تعداد کل حلقهها
پس از کیوریتوری، مجموعه داده برای حفظ کارایی محاسباتی به ۴۰۰۰ مولکول منحصربهفرد (MAX_UNIQUE) محدود میشود. خط لوله «مواد فعال قدرتمند» را آنهایی تعریف میکند که pIC50 آنها ≥ ۷.۰ (معادل IC50 ≤ ۱۰۰ نانومولار) باشد. ماتریس ویژگی نهایی شامل این ۲۰۴۸ بیت ECFP است که با ۱۰ توصیفگر فیزیکوشیمیایی ترکیب شده و یک نمایش ابعاد-بالا برای مدل QSAR ایجاد میکند.
تحلیل فضای شیمیایی و داربست (Scaffold)
پیش از مدلسازی، گردشکار فضای شیمیایی را با استفاده از داربستهای مورکو (Murcko scaffolds) تحلیل میکند تا خانوادههای شیمیتایپ تکرارشونده را شناسایی کند. با استخراج داربست مورکو برای هر مولکول، سیستم ۱۰ داربست پرتکرار اول را شناسایی میکند که تصویری از خانوادههای شیمیایی غالب در چشمانداز مهارکنندههای EGFR ارائه میدهد.
با اعمال تحلیل مؤلفههای اصلی (PCA) روی بیتهای ECFP، سیستم اثر انگشتهای ابعادبالا را به دو مؤلفه کاهش میدهد. این امر به AI اجازه میدهد تا توزیع مهارکنندههای EGFR و نحوه تغییر قدرت (pIC50) را در این چشمانداز بصری کند. این تجسم کمک میکند تا تعیین شود آیا مجموعه داده متمرکز است یا اینکه ویژگیهای محرک قدرت در خوشههای شیمیایی متنوع پراکنده شدهاند.
مدلسازی با تقسیمبندی داربست (Scaffold-Split)
به جای تقسیم تصادفی استاندارد، خط لوله از روش Scaffold-split استفاده میکند. در این روش، مولکولهایی که داربست مورکوی یکسانی دارند، با هم در مجموعه آموزش یا تست قرار میگیرند. این کار تضمین میکند که مدل روی شیمیتایپهایی آزمایش شود که کاملاً دیده نشدهاند و معیاری واقعبینانه از توانایی مدل در تعمیم به خانوادههای شیمیایی جدید ارائه میدهد، به جای اینکه فقط آنالوگهای نزدیک را حفظ کند.
با استفاده از یک رگرسور جنگل تصادفی (Random Forest Regressor) با ۴۰۰ تخمینزن و تنظیم max_features="sqrt" ، سیستم قدرت دارو را ارزیابی میکند. عملکرد با چندین معیار کمیسازی میشود:
- R² و RMSE: برای اندازهگیری دقت پیشبینیهای pIC50 (ردیابی عملکرد روی مجموعه داربستهای کنار گذاشته شده).
- ضریب اسپیرمن (Spearman rho): برای ارزیابی همبستگی رتبهای بین قدرت پیشبینی شده و واقعی.
- ROC-AUC: برای تعیین توانایی مدل در تشخیص مواد فعال قدرتمند (pIC50 ≥ ۷.۰) از مهارکنندههای ضعیف.
تفسیرپذیری و طراحی مولد
برای اجتناب از مشکل «جعبه سیاه»، گردشکار ابزار SHAP (توضیحات افزودنی شپلی) را از طریق TreeExplainer ادغام میکند. اگر SHAP در دسترس نباشد، سیستم به اهمیت ویژگیهای استاندارد جنگل تصادفی بازمیگردد. با محاسبه میانگین مطلق مقادیر SHAP روی نمونهای تصادفی از مولکولهای کنار گذاشته شده، سیستم شناسایی میکند که کدام بیتهای ECFP و کدام توصیفگرها قویترین محرکهای قدرت پیشبینی شده هستند.
سپس گردشکار زیرساختهای مولکولی دقیقی را که با بیتهای ECFP دارای رتبه بالا مرتبط هستند، بصری میکند. این فرآیند شامل نگاشت اندیس بیت به اتمها و پیوندهای خاص در محیط مولکولی (شعاع ۲) است. این کار به AI اجازه میدهد تا «راه حل خود را نشان دهد» و موتیفهای شیمیایی — مانند حلقههای آروماتیک خاص یا هتروسیکلهای دارای نیتروژن — را که با مهار بالای EGFR مرتبط میداند، برجسته کند.
پس از آموزش مدل، سیستم وارد فاز تولید با استفاده از BRICS (سنتز مبتنی بر قطعات بروتمن-ریتر) میشود. فرآیند تولید از یک منطق خاص پیروی میکند:
- بذرپاشی (Seeding): تا ۶۰ مولکول والد قدرتمند و دارو-مانند (pIC50 ≥ ۷.۰، وزن مولکولی ۲۵۰-۵۰۰) را بر اساس بالاترین قدرت انتخاب میکند.
- تجزیه (Decomposition): این والدین با استفاده از قوانین سنتزی به مجموعهای از قطعات BRICS تجزیه میشوند.
- ترکیب مجدد (Recombination): قطعات با
scrambleReagents=Trueو حداکثر عمق ۲ برای ایجاد آنالوگهای مجازی (تا ۴۰۰۰ تلاش) دوباره ترکیب میشوند. - فیلتر نوآوری: هر مولکولی که قبلاً در مجموعه آموزش وجود داشته باشد، حذف میشود. علاوه بر این، مولکولهای تولید شده باید محدودیتهای اندازه (۸ تا ۴۵ اتم سنگین و وزن مولکولی بین ۲۵۰ تا ۶۰۰) را داشته باشند تا از نظر بیولوژیکی مرتبط باقی بمانند.
اولویتبندی چند-پارامتری
آنالوگهای تولید شده بهطور کورکورانه پذیرفته نمیشوند. آنها باید از یک «دروازه توسعهپذیری» سختگیرانه عبور کنند که قدرت پیشبینی شده را با واقعیتهای شیمی دارویی متعادل میکند. سیستم یک امتیاز ترکیبی وزندار را محاسبه میکند:
- قدرت (۴۰٪): بر اساس pIC50 پیشبینی شده از طریق یک تابع مطلوبیت (محدوده هدف ۷.۵ تا ۱۲)، با یک حد پایین سختگیرانه ۵.۵.
- دارو-مانند بودن (۲۰٪): اندازهگیری شده از طریق امتیاز تخمین کمی دارو-مانند بودن (QED).
- وزن مولکولی (۱۰٪): محدوده ایدهآل ۲۵۰-۵۰۰ دالتون، با محدودیتهای سخت بین ۱۵۰ و ۶۵۰.
- آبگریزی (۱۰٪): محدوده ایدهآل LogP بین ۱ تا ۴، با محدودیتهای سخت بین ۱- و ۶.
- قابلیت دسترسی سنتزی (۱۰٪): بر اساس SAscore (هدف ۳.۵- تا ۱-، حد پایین سخت ۶-).
- نوآوری (۱۰٪): بر اساس فاصله تانیموتو از مجموعه آموزش.
کاندیداها برای قرار گرفتن در لیست نهایی باید معیارهای سخت زیر را داشته باشند:
- قدرت: pIC50 پیشبینی شده باید ≥ ۶.۵ باشد.
- فیزیکال بودن: وزن مولکولی باید بین ۲۵۰ تا ۶۰۰ دالتون باشد.
- دارو-مانند بودن: باید با قوانین وبر (RotB ≤ ۱۰, TPSA ≤ ۱۴۰) مطابقت داشته و حداقل ۳ ویژگی مطابق با قوانین لیپینسکی (MW ≤ ۵۰۰, LogP ≤ ۵, HBD ≤ ۵, HBA ≤ ۱۰) داشته باشد.
- سنتزپذیری: امتیاز SAscore ≤ ۶ برای اطمینان از اینکه مولکول واقعاً قابل سنتز است، الزامی است.
- نوآوری: بررسی شباهت تانیموتو در برابر تمام مهارکنندههای شناخته شده EGFR باید امتیاز نوآوری ≥ ۰.۳۵ تولید کند.
تأیید نهایی و خلاصه پژوهشی
لیست نهایی (معمولاً ۱۲ کاندیدای برتر) با استفاده از جستجوی InChIKey در PubChem تطبیق داده میشود. این کار شناسایی میکند که آیا مولکولهای پیشنهادی واقعاً جدید هستند یا ترکیبات موجود میباشند و با بررسی عدم حضور کاندید در PubChem، یک «ممیزی نوآوری» نهایی ارائه میدهد.
خروجی نهایی شامل یک جدول رتبهبندی شده از pIC50، QED، SA و نوآوری به همراه شبکهای از ساختارهای مولکولی است. این بخش با یک «خلاصه پژوهشی خودکار» به پایان میرسد که هدف (EGFR C797S)، پایه شواهدی (تعداد مهارکنندههای کیوریت شده) و قابلیت تعمیم مدل (R² و ROC-AUC) را فهرست میکند.
این رویکرد، نقش AI را از یک ابزار غربالگری غیرفعال به یک همکار-دانشمند فعال تغییر میدهد. با جفت کردن یک مدل پیشبینیکننده QSAR با یک موتور تولیدی مبتنی بر قطعات، این گردشکار حلقه تکرارشونده فرضیه و طراحی را خودکار میکند.
برای متخصصان، این بدان معنای است که مانع ورود به کشف مهارکنندههای کیناز کاهش یافته است. کل خط لوله بهگونهای طراحی شده است که با CPU سازگار باشد و نیازی به API-key نداشته باشد، که این امر اجرای آن را در محیطهای استانداردی مانند Google Colab در حالی که سختگیریهای علمی حفظ شده است، ممکن میسازد.
با این حال، نویسندگان تأکید میکنند که این نتایج، فرضیات in-silico هستند. گامهای حیاتی بعدی شامل डॉکینگ (Docking) این کاندیداها در ساختار جهشیافته سهگانه EGFR(L858R/T790M/C797S)، اولویتبندی اتصالدهندههای آلوستریک و انجام آزمایشهای واقعی در آزمایشگاه (wet-lab) برای تأیید قدرت و گزینشپذیری نسبت به EGFR نوع وحشی (wild-type) است.
در نتیجه، این آموزش یک حلقه کامل کشف در محیط رایانهای (in silico) را ارائه میدهد که دادههای فعالیت بیولوژیکی عمومی را به کاندیداهای اولویتبندی شده تبدیل میکند. با ادغام هوشمندی هدف، مدلسازی QSAR با اعتبارسنجی Scaffold-split، تفسیرپذیری از طریق SHAP و تولید مبتنی بر قطعات از طریق BRICS، این گردشکار بازتابدهنده تبادلات واقعی در شیمی دارویی است. این تولیدکننده فرضیه آموزشی به محققان اجازه میدهد تا شکاف بین دادههای خام و یک خط لوله دارویی تأیید شده را پر کنند، به شرطی که کاندیداهای حاصل تحت डॉکینگ تجربی، برنامهریزی سنتز و پروفایلبندی گزینشپذیری قرار گیرند.



گفتگو