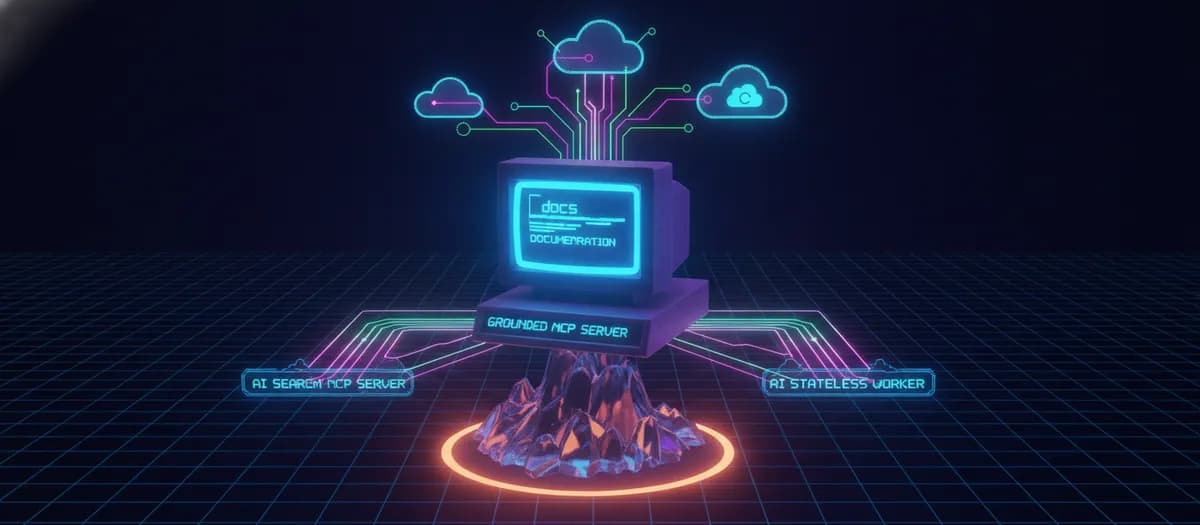
اگر برای استخراج قوانین پیچیدهٔ مجوزهای تجاری از مدلهای زبانی استفاده میکنید، احتمالاً با پاسخهایی مواجه شدهاید که با اطمینان کامل، اما کاملاً غلط هستند. این دقیقاً همان نقطهای است که ChinaReady برای حل آن وارد عمل شد تا جلوی توهم (Hallucination) — شبیه دوستی که خاطرهای را اشتباه تعریف میکند — در مورد سیاستهای فروشگاهها و مجوزهای چین را بگیرد.
به نقل از مستندات منتشر شده در ۱۳ اکتبر ۲۰۲۶، این تیم یک سرور عمومی مبتنی بر پروتکل زمینهٔ مدل (Model Context Protocol یا MCP) را مستقر کرد. این زیرساخت به عاملهای هوش مصنوعی مانند Cursor و OpenCode اجازه میدهد تا به جای حدس زدن، مستقیماً از یک مجموعه دادهٔ مبنیسازی شده (Grounded) با ارجاعات دقیق URL استفاده کنند. با این حال، گسترش سریع این پروتکل چالشهای جدیدی ایجاد کرده است؛ چنانکه گزارشهای اخیر از وجود هزاران سرور MCP بدون نظارت خبر میدهند که میتواند حفرههای امنیتی در دادههای سازمانی ایجاد کند.
بسیاری از مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در مواجهه با دادههای بسیار تخصصی شکست میخورند. برای example، در مورد آستانهٔ مجوز ICP B25، جستوجوی معنایی (Semantic Search) اغلب مقالاتی را برمیگرداند که از نظر معنایی شبیه هستند اما از نظر فنی غلطاند. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، دسترسی مستقیم به دادههای مرجع تنها راه کاهش خطای مدل در حوزههای حساس است. این رویکرد دسترسی به منابع معتبر، مشابه استراتژی پلتفرم ردپاین در لایسنس کردن میلیونها مقاله علمی برای تغذیه دقیقتر عاملهای هوش مصنوعی است.
برای حل این مشکل، معماری این سیستم بر Cloudflare AI Search و یک مدل بازیابی ترکیبی استوار است. این رویکرد، تطبیق کلیدواژهای BM25 را با جستوجوی برداری و ادغام RRF ترکیب میکند تا اطمینان حاصل شود که اصطلاحات دقیق در اولویت قرار میگیرند. طبق اعلام تیم توسعه، این سیستم حدود ۲۷۰۰ تکه (Chunk) از راهنمایهای منتشر شده را پردازش میکند و برای حفظ پاکیزگی دادهها، فرمهای قانونی را حذف کرده است.
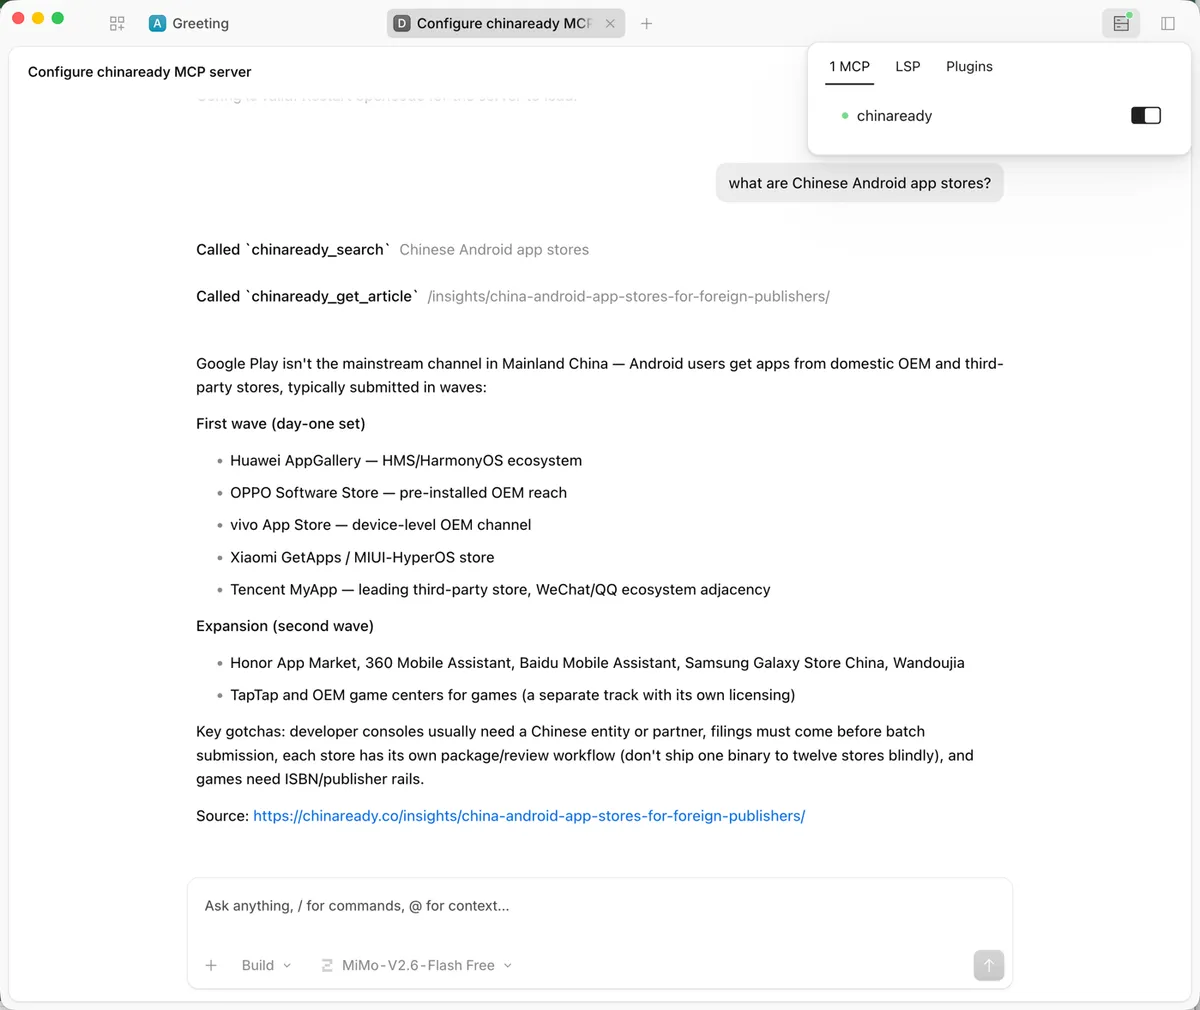
از آنجایی که نقطه انتهایی (Endpoint) پیشفرض کلودفلر فاقد حاشیهنویسی ابزارهای سفارشی بود، تیم ChinaReady یک لایه پوششی (Wrapper) با استفاده از Cloudflare Worker ساخت. این لایه بدون استفاده از SDK و تنها در ۳۰۰ خط کد، سه ابزار اصلی را در اختیار مدل قرار میدهد:
- search: ابزاری برای جستوجوی ترکیبی که گزیدههای رتبهبندی شده را همراه با URL منبع برمیگرداند.
- list_topics: فهرستی از موضوعات موجود به همراه نمونه پرسشها.
- get_article: ابزاری برای دریافت متن مقاله در قالب Markdown.
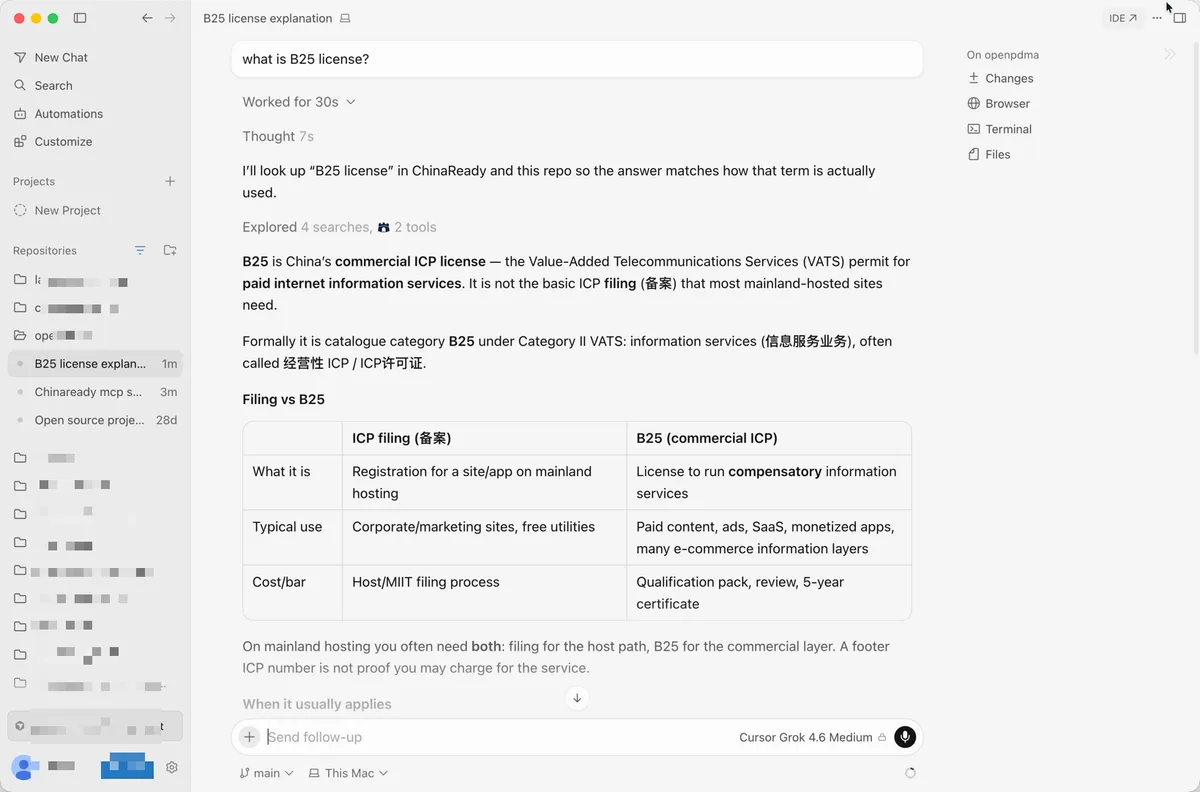
این تغییر رویکرد، مستندات را از فایلهای غیرفعال «Read-me» به نقاط انتهایی فعال و ماشینخوان تبدیل میکند. با ارائه فایل llms.txt و مشخصات OpenAPI 3.1، هم عاملهای سازگار با MCP و هم باتهای استاندارد REST میتوانند به یک حقیقت واحد دسترسی داشته باشند. این تحول در نحوه تعامل مدلها با متون تخصصی، ما را به یاد سیستم Paper2Agent در استنفورد میاندازد که مقالات پژوهشی را به قابلیتهای اجرایی برای عاملهای هوشمند تبدیل میکند.
برای توسعهدهندگان، درس اصلی این است که هنگام کار با کدهای محصول یا شماره سیاستها، استفاده از جستوجوی ترکیبی غیرقابل مذاکره است. همچنین یک محدودیت فنی مهم وجود دارد: هر تغییر در تنظیمات AI Search باعث بازسازی کامل شاخصها (Re-index) میشود؛ بنابراین بهروزرسانیها باید به صورت دستهای انجام شوند تا از توقف سرویس جلوگیری شود.
گام بعدی شما
- اگر مستندات فنی دارید، از قالب MIT این پروژه برای تبدیل آنها به سرور MCP استفاده کنید.
- نقطه انتهایی zنده را در mcp.chinaready.co/mcp تست کنید تا قدرت ارجاعات مبنیسازی شده را ببینید.
- برای کاهش توهمات مدل در دادههای عددی، ترکیب BM25 و Vector Search را جایگزین جستوجوی صرفاً برداری کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو