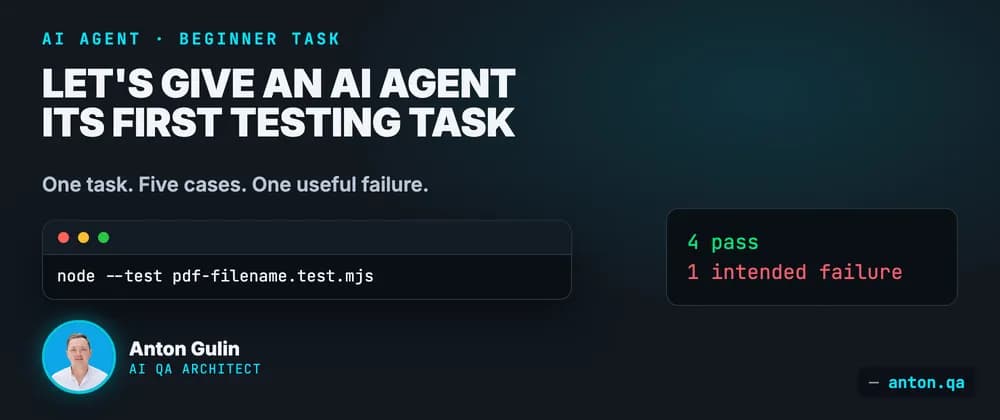
تصور کنید برنامهنویسی هستید که از هوش مصنوعی میخواهد یک باگ را رفع کند، اما هر بار مدل بدون توضیح علت، کدی را جایگزین میکند که شاید اتفاقی کار کند اما ریشه مشکل را حل نکرده باشد. در واقع، بسیاری از عاملهای هوش مصنوعی در حالی که به نظر میرسد شکافهای منطقی را درک میکنند، اغلب صرفاً در حال حدس زدن هستند. برای خروج از این چرخه، آنتون (Anton)، مهندس سابق اپل، متدی را با استفاده از Claude Code ابداع کرده است که از طریق یک وظیفه تست محدودشده، منطق نامگذاری فایلهای PDF را اعتبارسنجی میکند تا از اصلاح زودهنگام کد توسط عامل جلوگیری شود.
بسیاری از توسعهدهندگان به صورت غریزی به محض مشاهده خطا، از هوش مصنوعی میخواهند که «باگ را رفع کن». طبق گزارش منتشر شده در anton.qa، این رویکرد باعث میشود مشخص نشود که آیا عامل (Agent) — شبیه دستیاری که دستورات را اجرا میکند اما لزوماً منطق پشت آنها را نمیفهمد — واقعاً علت ریشهای را یافته یا صرفاً به یک راهکار تصادفی رسیده است. با تبدیل «تست» به خروجی اصلی و تحویلشدنی، شما یک محک اندازهگیری برای توانایی استدلال مدل ایجاد میکنید.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، شفافیت در فرآیند استنتاج، کلید اعتماد به خروجیهای خودکار است. در این متد، هدف این است که مدل قبل از دست زدن به کد، ثابت کند کجا و چرا کد شکست میخورد.
نیازمندیهای فنی
برای اجرای این متد، شما به یک ترمینال و Node.js نسخه ۲۴ نیاز دارید. میتوانید با اجرای دستور node --version محیط خود را تایید کنید. همچنین باید حساب Claude Code فعال داشته باشید که از طریق راهنمای سریع رسمی نصب شده و با دستور claude --version قابل تایید باشد. این ابزار در عین قدرت، گاهی با چالشهای پیکربندی روبروست؛ برای مثال، تداخل در فایلهای تنظیمات Claude Code پیشتر نشان داد که چگونه برخی دستورات برنامهنویسان ممکن است به طور ناخواسته نادیده گرفته شوند.
در این تمرین از یک تابع کمکی ساده به نام isPdfFilename استفاده شده است که در فایلی به نام pdf-filename.mjs ذخیره میشود. این تابع یک نقص عمدی دارد: از متد .endsWith('.pdf') استفاده میکند که پسوندهای بزرگ (مانند .PDF) را تشخیص نمیدهد. قانون مورد نظر این است که هر فایلی که به .pdf ختم میشود، بدون توجه به حروف بزرگ و کوچک پذیرفته شود و هر پسوند دیگری رد شود.
گردش کار وظایف محدودشده
بر اساس مستندات آنتون، این فرآیند برای جلوگیری از زیادهروی عامل و عبور از مرزهای تعیین شده، از یک توالی سختگیرانه پیروی میکند:
- آمادهسازی: ایجاد یک پوشه ایزوله با دستور
mkdir first-agent-taskو سپس ورود به آن باcd first-agent-task. تابع کمکی باید در این دایرکتوری مجزا ذخیره شود. - پرامپت: دستور به عامل برای خواندن فایل و نوشتن یک مجموعه تست با استفاده از رانر داخلی
node:test. پرامپت باید صراحتاً پنج مورد تست را مشخص کند:invoice.pdf،report.PDF،notes.txt،report.pdf.exeو یک نام خالی. این رویکرد دقیق در طراحی پرامپت، تضاد مستقیمی با استفاده از پرامپتهای شکننده در مهندسی دانش کلود دارد که در آن اسکریپتهای قطعی جای خود را به دستورات غیرقابل پیشبینی میدهند. - محدودیتها: ممنوعیت صریح برای تغییر فایل کمکی اصلی یا نصب هرگونه بسته (Package) جدید. اگر عامل درخواست تغییر در فایل کمکی را داشت، شما باید نقطه توقف را دوباره یادآوری کنید.
- هدف: الزام عامل به اجرای دستور
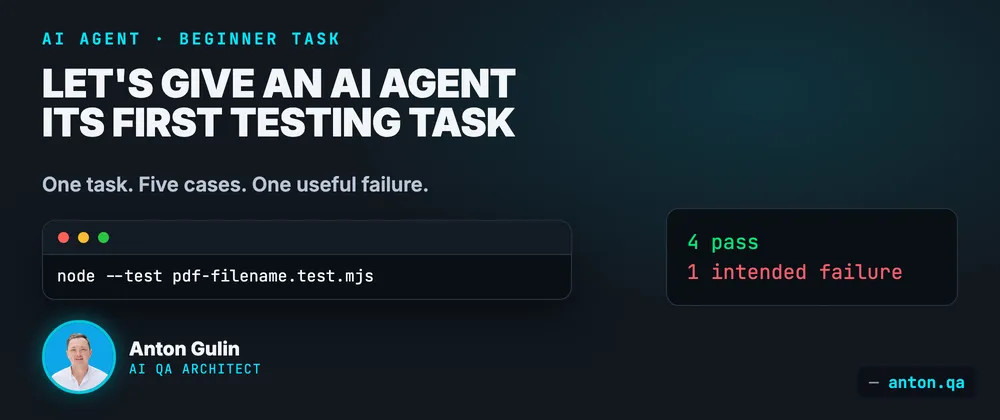
node --test pdf-filename.test.mjsو گزارش دقیق تعداد موارد موفق/ناموفق و شناسایی مورد خاصی که شکست خورده است.
جزئیات اجرا
در یک اجرای نمونه با Node 24.18.0، مجموعه تست به درستی تشخیص داد که چهار مورد پاس شده و یک مورد شکست خورده است. مورد شکست دقیقاً مربوط به report.PDF بود که انتظار مقدار true داشت اما مقدار false دریافت کرد. در نهایت، Node با کد خروجی ۱ (Error) بسته شد.
- موارد موفق:
invoice.pdf(حروف کوچک)،notes.txt(پسوند غلط)،report.pdf.exe(وجود پسوند بعد از .pdf) و نام خالی. - مورد شکست:
report.PDF(پسوند با حروف بزرگ).
این نتیجه ثابت میکند که تست قادر به شناسایی خطای مورد نظر است. لازم به ذکر است که تابع کمکی تنها نام فایل را بررسی میکند و فایل PDF را باز نکرده یا محتویات آن را اعتبارسنجی نمیکند.
این تفکیک وظایف، نقش توسعهدهنده را از یک «بازبین کد» به یک «ممیز کیفیت» تغییر میدهد. وقتی عامل را قبل از اصلاح متوقف میکنید، او را مجبور میکنید نتیجهای قابل مشاهده ارائه دهد که بتوانید آن را دستی بررسی کنید. این کار از اثر «جعبه سیاه» جلوگیری میکند؛ وضعیتی که در آن هوش مصنوعی باگی را رفع میکند اما یک رگرسیون (Regression) پنهان و جدید ایجاد میکند. این سطح از دقت در اعتبارسنجی، مشابه رویکردی است که در سیستم Paper2Agent برای بازتولید نتایج پژوهشی به کار گرفته شده تا خروجیهای مدل را به نتایج اجرایی و قابل تایید تبدیل کند.
برای شما به عنوان کاربر، این یعنی گردش کار باید به سمت حلقههای «ابتدا تست» (test-first) تغییر کند. به جای درخواست یک قابلیت، ابتدا تستی بخواهید که ثابت کند آن قابلیت وجود ندارد. تنها پس از مستند شدن شکست، اجازه تغییر کد را بدهید.
اگر متوجه شدید که با وجود وجود باگ، تمام تستها پاس شدهاند، این نشاندهنده شکست در منطق تولید تست توسط عامل است، نه لزوماً نقص در خودِ کد. این تمایز برای حفظ پایداری کد در مقیاس بزرگ، زمانی که مشارکتهای تولید شده توسط هوش مصنوعی افزایش مییابد، حیاتی است.
گام بعدی شما
- این منطق «وظیفه محدودشده» را روی یک ماژول قدیمی (Legacy) بزرگتر در پروژه خودتان امتحان کنید.
- ابتدا تمام نقاط شکست را مستند کنید و سپس در یک جلسه (Session) مجزا، اجازه تعمیر را بدهید.
- بررسی کنید آیا مدل در تولید تستهای لبهای (Edge Cases) دچار توهم میشود یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو