یک فراخوانی اشتباه از ابزارها میتواند صدها دلار از جیب توسعهدهنده کم کند، آن هم زمانی که یک عامل (Agent) — شبیه دستیاری که دسترسی به کارت اعتباری شما دارد اما گاهی حساب ریاضیاش اشتباه است — به یک API دادهای متریشده متصل میشود. Claude Code اکنون قابلیتی به نام «دروازه هزینه» (Spend Gate) را ارائه میدهد؛ مکانیزم سختافزاری که درخواستهای گرانقیمت را مسدود میکند، مگر اینکه عامل ابتدا پروتکل سختگیرانه شمارش و نمونهبرداری را اجرا کند.
این رویکرد در حالی معرفی میشود که توسعهدهندگان با مشکلاتی چون «نشت پرامپت» و فشردهسازی پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — دستوپنجه نرم میکنند. همانطور که در تحلیل قبلی ما دربارهی اتوماسیون گردشهای کاری با Claude اشاره کردیم، این متد جدید حفاظهای امنیتی را از حافظه ناپایدار مدل به لایه اجرای سیستم منتقل میکند. در دنیایی که عاملها بهطور پیشفرض روی حداکثر نتایج تنظیم شدهاند، یک جمله در پرامپت ضعیفترین حفاظ ممکن است.
شکست حفاظهای مبتنی بر پرامپت
بسیاری از توسعهدهندگان به عاملها دستور میدهند که «اول بشمار» یا «قبل از هزینه کردن بپرس». با این حال، طبق گزارشی در dev.to که در ۱۴ اکتبر ۲۰۲۶ منتشر شد، این دستورات اغلب پس از جلسات طولانی یا زمانی که متن دادهها شبیه به یک دستور جدید باشد، نادیده گرفته میشوند. در واقع، وقتی حجم دادهها زیاد میشود، دستورات اولیه در حافظه مدل کمرنگ شده و جای خود را به دادههای جدید میدهند. این چالشها در مقیاس وسیعتر نیز دیده شده است، بهطوری که برخی توسعهدهندگان در گیتهاب با جهش هزینهها به ۷۵۰ دلار مواجه شدند که نشاندهنده ریسک مدلهای مصرفی در ابزارهای کدنویسی است.
برای ابزار LinkedIn People Search در Apify، تنظیمات پیشفرض بهشدت ریسکی هستند. اگر یک عامل ابزار را بدون سقف مشخص فراخوانی کند، بهطور پیشفرض ۵۰۰ ردیف پولی را استخراج میکند. این اتفاق به دلیل «خرابی» عامل نیست، بلکه نتیجه پیروی از رفتار پیشفرض API است؛ یعنی عامل دقیقاً همان کاری را میکند که API از او میخواهد، بدون اینکه بداند این کار هزینهبر است.
زمینه: مسئلهای سه وجهی
این انضباط فنی پاسخی به سه مشکل مشخص است که جامعه توسعهدهندگان در dev.to شناسایی کردهاند:
- شکاف دسترسی: کاربر tareketman به API اشاره کرد که در آن کلید دسترسی، مجوز نیست، بلکه قیمت است. در این مدل، تجزیه و قیمتگذاری رایگان است، اما فقط فراخوانیهایی که هشِ قیمت (Quote's Hash) را حمل کنند میتوانند هزینه کنند. این یعنی دسترسی فنی وجود دارد، اما اجرای عملیاتی وابسته به پرداخت است. این رویکرد یادآور تلاشهایی برای استانداردسازی پرداختهای ماشینبهماشین است، مشابه آنچه پروژه AgentBadge با باززندهسازی کد HTTP 402 برای تسهیل تراکنشهای خودکار عاملها انجام داد.
- گردش کار فراخوان: در رشتهگفتگویی زیر پست locaihost_data، یک توالی سهمرحلهای تثبیت شد: ابتدا شمارش، سپس یک نمونه پولی با نرخ موفقیت (Hit Rate)، و در نهایت اجرای کامل؛ بهطوری که هر مرحله پیش از اجرا، هزینه خود را اعلام کند تا کاربر در هر گام آگاه باشد.
- بیشباری از ابزارها: jeff_pdc استدلال کرد عاملی که ۴۰ ابزار در اختیار دارد، اغلب ابزار اشتباه را انتخاب میکند و ریسک هزینه تصادفی را بالا میبرد. وقتی تعداد ابزارها زیاد شود، احتمال اینکه مدل یک ابزار گرانقیمت را با یک ابزار رایگان اشتباه بگیرد، افزایش مییابد.
مکانیزم سهمرحلهای دروازه هزینه
برای حل این مشکل، سیستمی از سه مرحله مجزا توسط یک اسکریپت شل (Shell Script) خارج از مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — اجبار میشود:
۱. شمارش رایگان
عامل ابتدا باید حالت count را اجرا کند. این کار تعداد کل رکوردهای منطبق را بدون هزینه برای هر ردیف برمیگرداند. برای مثال، فیلتری برای مدیران فروش و رهبران درآمد (سطح Director به بالا) در شرکتهای ۵۰ تا ۵۰۰۰ نفره در آمریکا، انگلیس و آلمان، ۲۲,۳۷۰ نفر را شناسایی کرد.
این مرحله همچنین برای بررسی بهروز بودن دادههاست؛ همین فیلتر در ۱۰ اکتبر تعداد ۲۱,۸۳۴ نفر را نشان میداد که یعنی در چهار روز ۵۳۶ پروفایل جدید بهروز شده است. پاسخ شمارش تنها یک ردیف است: _total: 22370، به همراه بازگشت فیلترهای تحلیلشده و یادداشتی مبنی بر اینکه شمارش هیچ هزینهای برای هر ردیف ندارد. این قابلیت شمارش پیش از هزینه، مشابه ابزارهای تخصصی است که مانند راهکارهای x402 برای تشخیص دامنههای پارکشده به عاملها کمک میکنند تا پیش از مصرف اعتبار، حجم و ماهیت دادهها را بسنجند.
۲. نمونهبرداری بذری
عامل مجاز است برای یک نمونه کوچک (حداکثر ۱۰۰ ردیف) هزینه کند. نکته حیاتی این است که باید از یک بذر (Seed) — مقدار تصادفی اولیه برای تکرارپذیری — استفاده کند تا یک برش تصادفی از دادهها بگیرد. بدون بذر، عامل فقط صفحه اول نتایج را میبیند که ممکن است به دلیل ترتیب مرتبسازی، دچار سوگیری باشد.
در یک تست، نمونه ۱۰۰ ردیفی بدون بذر، فقط افرادی از آلمان را برگرداند. تعمیم نرخ موفقیت ۴۹ درصدی ایمیلهای کاری از این برش تککشوری به کل ۲۲,۳۷۰ نفر، کاملاً اشتباه بود و هیچکدام از لاگهای اجرا این خطا را فاش نمیکردند. در واقع، عامل تصور میکرد کل بازار مشابه آلمان است، در حالی که واقعیت متفاوت بود.
با استفاده از sampleSeed: 42، عامل یک برش تصادفی و تکرارپذیر میگیرد. مقایسه دو اجرا تفاوت را نشان میدهد:
- بدون بذر: ۱۰۰ ردیف، ۱۰۰٪ آلمان، ۴۹ ایمیل کاری، ۱۷ ایمیل شخصی. زمان اجرا: ۱۲.۶ ثانیه.
- با بذر (۴۲): ۱۰۰ ردیف، توزیع شده بین آمریکا (۸۳)، انگلیس (۱۲) و آلمان (۵). ۷۸ ایمیل کاری، ۴۷ ایمیل شخصی. زمان اجرا: ۲۳.۴ ثانیه.
اکنون تعمیم معنا پیدا میکند: حدود ۱۷,۴۰۰ نفر از ۲۲,۳۷۰ نفر دارای پرچم ایمیل کاری هستند و حدود ۱۰,۵۰۰ نفر دارای پرچم ایمیل شخصی. یک پرچم به معنای آدرس تأیید شده نیست، اما عددی است که یک تیم فروش پیش از تایید اجرای کامل به آن نیاز دارد تا بودجه را تخمین بزند.
۳. اجرای تاییدشده
استخراج کامل دادهها مسدود است تا زمانی که کاربر بهصورت دستی یک فایل تایید (.claude/approve-spend) در دایرکتوری پروژه ایجاد کند. این کار تضمین میکند که عامل نمیتواند خودش هزینه را تایید کند و اجازه دسترسی به بودجه نهایی را ندارد.
پیادهسازی فنی از طریق هوکهای PreToolUse
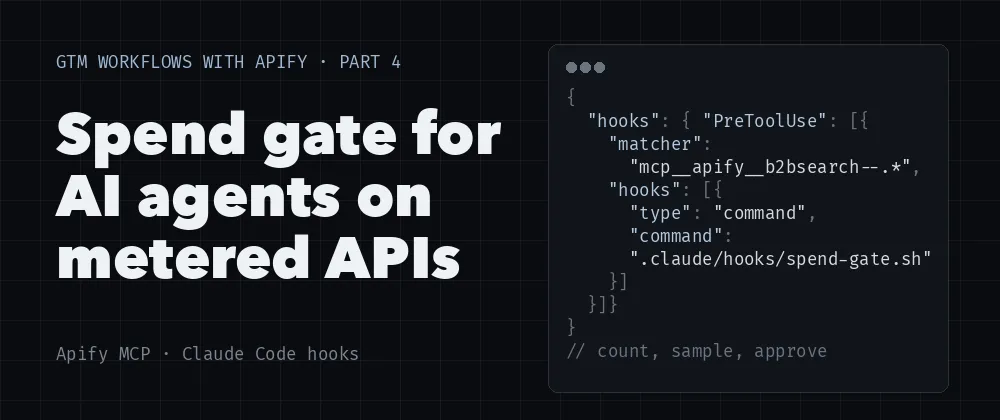
اجرای این محدودیت از طریق یک هوک PreToolUse در تنظیمات Claude Code صورت میگیرد. این هوک نام ابزار را با استفاده از یک عبارت منظم (Regular Expression) تطبیق داده و پیش از فراخوانی ابزار، یک اسکریپت شل را اجرا میکند.
تثبیت سرور MCP
برای کاهش سردرگمی عامل، سرور با دستور claude mcp add --transport http apify "https://mcp.apify.com?tools=b2bsearch/people-database-search" تنها به پنج ابزار محدود میشود.
این کار عامل را فقط به ابزارهای ضروری محدود میکند:
b2bsearch--people-database-search(ابزار اصلی Actor)get-actor-runget-dataset-itemsget-key-value-store-recordabort-actor-run
ابزار Actor ورودی را مستقیماً به صورت JSON (شامل mode، maxResults، countries و غیره) میگیرد، دقیقاً مشابه فرم کنسول. با این تثبیت (Pinning)، دیگر ابزاری برای «جستوجو در Store» یا Actorهای مشابه وجود ندارد که عامل بین آنها مردد شود و اشتباهاً ابزار گرانتری را انتخاب کند.
منطق هوک
- تطبیقدهنده: از
mcp__apify__b2bsearch--.*برای هدف قرار دادن ابزارهای سرور Apify استفاده میکند. عبارت منظم ضروری است زیرا یک رشته ساده نیازمند تطبیق دقیق با نام کامل ابزار (مثلاًmcp__apify__b2bsearch--people-database-search) است. - اسکریپت: یک اسکریپت Bash که ورودی JSON را با
jqتجزیه میکند. اگر حالت count یا market (رایگان) باشد یا تعداد نتایج زیر ۱۰۰ ردیف باشد، اجازه عبور میدهد. اگر حالت (mode) ذکر نشده باشد، آن را به عنوان 'people' در نظر میگیرد تا با رفتار پیشفرض Actor مطابقت داشته باشد. - مسدودکننده: اگر اجرای پولی بدون فایل
.claude/approve-spendتلاش شود، اسکریپت با کد ۲ خارج میشود. این خطا به عامل بازگردانده شده و او را مجبور میکند پروتکل «شمارش، نمونه، گزارش و درخواست» را یاد بگیرد.
نتایج تست در دنیای واقعی
در یک جلسه زنده، این دروازه مانع از یک هزینه عظیم تصادفی شد. وقتی به عامل دستور داده شد «همین حالا همه را استخراج کن»، او سعی کرد ابزار را با maxResults: 25000 فراخوانی کند.
هوک فوراً تماس را مسدود کرد. عامل سپس به پروتکل درست بازگشت: شمارش را اجرا کرد، یک نمونه ۱۰۰ ردیفی با بذر ۴۲ گرفت و نتایج را طبقهبندی کرد. او دریافت که ۷۷ ردیف هدف بودند، ۸ ردیف در مشاغل مجاور (مانند RevOps، enablement، مهندسی فروش یا مدیریت درآمد هتل) و ۱۵ ردیف کاملاً خارج از هدف.
این تحلیل یک نکته ظریف را فاش کرد: برخی عناوین «کارشناس فروش» به این دلیل فیلتر را رد کرده بودند که فرد همزمان پست مدیر فناوری را در شرکت دیگری داشت. برای مثال، یک ردیف مربوط به کارشناس فروش خردهفروشی در شرکتی با ۳۴,۰۰۰ نفر بود که پست دوم او مدیر فناوری در سازمانی ۱۹۲ نفره بود که در سال ۲۰۲۶ شروع شده بود. یک شمارش ساده این موضوع را فاش نمیکرد؛ فقط نمونهبرداری این را نشان داد.
عامل سپس یک لیست استثنا پیشنهاد داد، دوباره بهصورت رایگان شمارش کرد (۲۰,۶۰۳ نفر) و درخواست تایید کرد. کل جلسه ۱۷ نوبت و ۶.۵ دقیقه زمان برد و تنها هزینه ۱۰۰ ردیف نمونه و یک شروع Actor را داشت.
پیادهسازیهای جایگزین
برای کسانی که از Claude Code استفاده نمیکنند، همین منطق در جای دیگر قابل اجراست:
- HTTP API: استفاده از پارامتر
maxTotalChargeUsdدر URL اجرای برنامه (مثلاًmaxTotalChargeUsd=0.2) برای تعیین سقف هزینه کل در تمام مدلهای قیمتگذاری. در این حالت، رکورد اجرا مقدارisMaxTotalChargeUsdSetByUser: trueرا نشان میدهد و Actor میتواند سقف را ازACTOR_MAX_TOTAL_CHARGE_USDبخواند. - n8n: پیادهسازی یک گردش کار سهگره شامل اجرای شمارش، یک گره IF برای بررسی هزینههای تعمیمیافته و در نهایت یک درخواست HTTP با سقف هزینه سخت در URL. این کار تضمین میکند که سقف هزینه در تعریف گردش کار قرار دارد و نه در حافظه کسی.
تحلیل: انتقال حفاظها به خارج از مدل
این تغییر نشاندهنده یک روند گستردهتر در هوش مصنوعی عاملمحور است: انتقال کنترلهای بودجه و ایمنی از لایه «احتمالاتی» (پرامپت) به لایه «قطعی» (کد).
یک حفاظ نهایی، برخورد با ردیفها به عنوان داده است، نه دستور. چون پروفایل افراد میتواند حاوی جملاتی باشد که خطاب به خواننده است، ریسک اجرای آن متن توسط عامل وجود دارد. یک هوک PostToolUse میتواند نتایج را پیش از خواندن توسط مدل اسکن کند تا مطمئن شود عامل این رشتهها را امتیازدهی و فیلتر میکند، نه اینکه آنها را اجرا کند.
با تبدیل خروجی عامل به درخواستی که باید توسط یک هوک سیستمی تایید شود، توسعهدهندگان میتوانند با عاملهای AI مانند کاربران غیرقابلاعتماد APIهای خود برخورد کنند. این معماری تضمین میکند که عامل نمیتواند با توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — بودجه را به خطر بیندازد، زیرا تایید نهایی نیازمند یک فایل فیزیکی روی دیسک است که عامل دستور گرفته خودش آن را ایجاد نکند.
گام بعدی شما
- اگر از APIهای پولی در عاملهای خود استفاده میکنید، سقف هزینه (Cost Cap) را در لایه کد یا API تعریف کنید، نه در پرامپت.
- برای دادههای حجیم، ابتدا از متد Count و سپس Seeded Sample برای تخمین هزینه و دقت استفاده کنید.
- از هوکهای PreToolUse برای اجبار عامل به دنبال کردن پروتکلهای تایید انسانی استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو