یک افزایش کوچک در چرخههای پردازشی میتواند پتابایتها ظرفیت ذخیرهسازی مؤثر آزاد کند. کلاودفلر (Cloudflare) طبق گزارش مهندسی مورخ ۱ سپتامبر ۲۰۲۶، نمونهای اولیه از سامانهای به نام «تبدیل کد کش» (Cache Transcoding) را توسعه داده است که حجم داراییهای ذخیرهشده در کش را بهطور متوسط به یکسوم اندازه اصلی آنها روی دیسک کاهش میدهد.
هزینههای حافظه برای RAM و دیسکهای سخت در سال گذشته بهشدت افزایش یافته است. برای یک شبکه توزیع محتوا (CDN) در مقیاس جهانی، این جهش قیمتی باعث شده تا بهرهوری حافظه از یک انتخاب لوکس به یک ضرورت برای بقا تبدیل شود. مهندسان کلاودفلر برای مقابله با این وضعیت، فشردهسازی Zstandard (zstd) را مستقیماً در پینگورا (Pingora) — پروکسی ترافیکی این شرکت — ادغام کردند. این پروژه در قالب برنامه کارآموزی 1.1.1.1 توسعه یافته است.
تصور کنید کش شما مانند یک انبار کالا است؛ در حالت سنتی، اگر وبسایتی فایلی فشردهنشده بفرستد، انبار آن را دقیقاً به همان شکل ذخیره میکند. تبدیل کد کش مانند یک دستگاه «خلاهکن» عمل میکند: فایل را لحظه ورود به انبار فشرده کرده و تنها در لحظه خروج برای مشتری، آن را باز میکند. این معماری، مقدار اندکی فشار بیشتر به CPU را با صرفهجویی عظیم در فضای ذخیرهسازی و پهنای باند بین مراکز داده معاوضه میکند. همانطور که در تحلیلهای قبلی ما درباره بهینهسازی لبه (Edge Optimization) اشاره کردیم، جابهجایی بار از حافظه به پردازش، کلید مقیاسپذیری در زیرساختهای مدرن است.
درک سازوکار Zstandard (zstd)
Zstandard یک الگوریتم فشردهسازی بدون اتلاف (Lossless) است که توسط یان کولت در فیسبوک توسعه یافت و در سال ۲۰۱۶ متنباز شد. چون این روش بدون اتلاف است، هر بایت داده پس از رمزگشایی دقیقاً با نسخه اصلی یکسان است. این ویژگی به کلاودفلر اجازه میدهد نحوه نمایش یک دارایی روی دیسک را تغییر دهد بدون اینکه خودِ دارایی دستکاری شود.
Zstd بهطور خاص برای ایجاد تعادل میان نرخ فشردهسازی و سرعت طراحی شده است. طبق گزارش کلاودفلر، در تستهای فشردهسازی مرورگر، zstd دادهها را ۴۲٪ سریعتر از Brotli فشرده کرده در حالی که اندازه فایل نهایی تقریباً یکسان بود. همچنین فایلهایی ۱۱.۳٪ کوچکتر از gzip در سرعتی مشابه تولید کرد. این تعادل حیاتی است زیرا تبدیل کد کش با حجم عظیمی از ترافیک در تماس است و هر دو مرحله کدگذاری و رمزگشایی باید سریع باشند تا به گلوگاه تبدیل نشوند.
مکانیسم تبدیل کد کش
این سامانه داراییهای خاص و باارزش را هدف قرار میدهد؛ زیرا هر دادهای ارزش صرف توان CPU برای فشردهسازی را ندارد. تصاویر، ویدیوها و فونتها معمولاً از پیش فشرده شدهاند؛ در نمونه ترافیک کلاودفلر، این موارد ۶۳.۳٪ از بایتها اما تنها ۲۱.۴٪ از درخواستها را تشکیل میدادند. فشردهسازی مجدد اینها، صرف CPU بدون هیچ سودی است.
در مقابل، سامانه بر متون قابلفشرده مانند HTML، JSON، CSS و JavaScript تمرکز میکند. اینها ۶۷.۳٪ از درخواستها و ۲۲.۳٪ از بایتها را شامل میشوند. در این بخش، حدود ۷۱٪ از داراییها بدون فشردهسازی (بدون برچسب Content-Encoding) وارد میشوند و اهداف ایدهآلی برای zstd هستند.
برای حفظ عملکرد، این نمونه اولیه قوانین سختگیرانهای دارد:
- پاسخ باید وضعیت '200 OK' داشته باشد.
- برچسب Content-Encoding نباید تنظیم شده باشد.
- نوع محتوا (Content-Type) باید متن قابلفشرده باشد.
- دارایی باید طول محتوای مشخصی حداقل ۴ کیلوبایت داشته باشد.
داراییهایی که این معیارها را ندارند — مانند درخواستهای Range، پاسخهایی که از فشردهسازی فعال در منبع (Upstream) استفاده میکنند، درخواستهای تکهای (Slice subrequests)، پاسخهای از پیش فشردهشده، بدنه با طول نامشخص و محتوای باینری — بدون تغییر باقی میمانند. آستانه ۴ کیلوبایت بسیار مهم است؛ زیرا تعداد زیادی از درخواستهای بسیار کوچک را حذف میکند در حالی که تنها ۱٪ از بایتهای واجد شرایط را از دست میدهد. کاهش این آستانه، سربار هر شیء را افزایش میداد بدون اینکه صرفهجویی قابلتوجهی در فضای ذخیرهسازی ایجاد کند.
عملکرد و موازنه (Trade-offs)
کلاودفلر از سطح ۳ (level 3) در zstd برای تعادل میان سرعت و نرخ فشردهسازی استفاده کرد. در تستهای کنترلشده، نرخ فشردهسازی به ۲.۸۳۴ برابر رسید. هزینه این کار بر دوش CPU است:
- هزینه کدگذاری: ۴.۳۱ نانوثانیه به ازای هر بایت (حدود ۲۳۲ مگابایت بر ثانیه)، که فقط یکبار هنگام پر شدن کش پرداخت میشود.
- هزینه رمزگشایی: ۱.۵۶ نانوثانیه به ازای هر بایت (حدود ۶۴۱ مگابایت بر ثانیه)، که در هر بار ارائه به کاربر پرداخت میشود.
از آنجا که داراییها بسیار بیشتر از تعداد دفعات پر شدنشان، سرویس داده میشوند، هزینه رمزگشایی هزینه جاری اصلی است. با این حال، مدلها نشان میدهند که این سربار CPU در محدوده چند درصد از کل بودجه پردازشی باقی میماند (تحت مفروضات ترافیکی تست شده). تیم مهندسی ابتدا قصد داشت این قابلیت را فقط برای محتوای «داغ» (پرطرفدار) محدود کند، اما دریافت که این کار کمکی نمیکند؛ زیرا رمزگشایی در هر صورت برای هر درخواست رخ میدهد و محدود کردن آن، صرفهجویی در فضای ذخیرهسازی را کم میکرد بدون اینکه فشار CPU را بهطور متناسب کاهش دهد. در نهایت، یک سیاست سادهتر مبنی بر تبدیل کد تمام متون واجد شرایط بالای ۴ کیلوبایت، عملکرد بهتری داشت.
بهرهوری در کش لایهای (Tiered Cache)
مزایای این سیستم فراتر از یک سرور واحد است. در ساختار کش لایهای، داراییها بین مراکز داده جابهجا میشوند. با این سامانه، شیء فشردهشده با zstd در همان حالت کوچکشده از طریق شبکه داخلی (Backbone) منتقل میشود و مصرف پهنای باند بین مراکز داده کلاودفلر را بهینه میکند.
جریان کاری بسته به وضعیت کش متفاوت است:
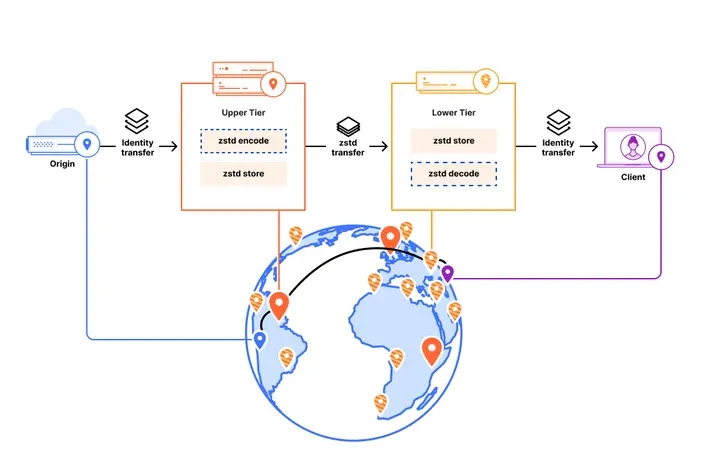
- در حالت Cache Miss: پروکسی مبتنی بر پینگورا، بدنه را با zstd کدگذاری کرده و روی دیسک مینویسد. متادادهها ثبت میکنند که نمایش داده فشرده است اما طول اصلی محتوا حفظ میشود. دادهها درست قبل از خروج از پروکسی رمزگشایی میشوند.
- در حالت Cache Hit: شیء zstd ذخیرهشده از دیسک خوانده و رمزگشایی میشود.
- در حالت Full Cache Miss: لایه بالایی بایتهای اصلی (Identity bytes) را از منبع میگیرد، یکبار کدگذاری میکند و در حالت فشرده به لایه پایینتر میفرستد. لایه پایینتر نسخه zstd را ذخیره کرده و برای مسیر درخواست رمزگشایی میکند.
- در حالت Upper-tier hit / Lower-tier miss: شیء فشرده مستقیماً بین لایهها جابهجا میشود. این شیء روی شبکه و دیسک فشرده میماند و تنها یکبار در لایه پایین رمزگشایی میشود.
- در حالت Lower-tier hit: هیچ انتقال شبکهای یا کدگذاری نیاز نیست؛ لایه پایین بایتهای zstd را از دیسک خوانده و رمزگشایی میکند.
یک نشانگر کدگذاری ذخیرهسازی (Storage encoding marker) مانع از این میشود که یک شیء بیش از یکبار کدگذاری شود. اگر یک لایه کش شیئی را دریافت کند که قبلاً با zstd ذخیره شده است، آن را در همان حالت حفظ میکند.
اعتبارسنجی در مقیاس واقعی
برای تایید این معماری، تیم یک کمپین با بیش از یک میلیون درخواست روی ۱۰ سرور کش اجرا کرد. آنها هر درخواست را با لاگهای سیستم، معیارهای Prometheus و ردیابیهای Jaeger تطبیق دادند. این کمپین تمام حالتهای Cache Miss، Cache Hit، پر شدنهای تکمرحلهای (Single-hop fills) و پر شدنهای لایهای (Tiered Cache fills) را پوشش داد.
در یک کمپین عملکردی، ترافیک به دو دسته تقسیم شد: نیمی با کش لایهای غیرفعال و نیمی با آن فعال. این کار اجازه داد رفتار کش محلی را جدا از انتقال بین لایهها بسنجند. آنها دو دارایی خاص (۱۹۵ و ۲۷۲ کیلوبایت) را تست کردند که هر دو تقریباً ۲.۸ برابر فشرده شدند. اگرچه این یک مجموعه داده بهطور عمدی قابلفشرده بود تا معماری اعتبارسنجی شود، اما تیم اشاره کرد که برای تعمیم این عدد به کل شبکه، بررسی مجموعه دادههای گستردهتری لازم است.
این تغییر، فرض بنیادی درباره تراکم کش را عوض میکند. با کاهش ردپای روی دیسک، سرورها میتوانند اشیاء بیشتری را نگه دارند و این امر مستقیماً احتمال حذف محتوای مفید (Eviction) برای باز کردن جا برای دادههای فشردهنشده را کاهش میدهد.
برای کاربر نهایی، این به معنای نرخ Hit بالاتر در کش و احتمالاً زمان بارگذاری سریعتر است. برای کلاودفلر، این یعنی به تعویق انداختن توسعههای سختافزاری گرانقیمت از طریق به حداکثر رساندن بهرهوری دیسکهای موجود.
در ادامه، تیم قصد دارد سطوح بالاتر zstd را ارزیابی کرده و طیف گستردهتری از انواع محتوا و اندازههای اشیاء را تست کند. کارهای آینده شامل بررسی درخواستهای Range، پاسخهای از پیش فشردهشده منبع و انتقال مستقیم اشیاء فشرده به مؤلفههای پاییندستی (Downstream) خواهد بود که از پیش از این قابلیت را دارند و نیازی به مرحله رمزگشایی ندارند.
گام بعدی شما
- اگر از زیرساختهای CDN استفاده میکنید، بررسی کنید که آیا محتوای متنی شما (JSON/HTML) بهطور بهینه فشرده میشود یا خیر.
- برای بهینهسازی ذخیرهسازی در لبه، الگوریتم Zstandard را به عنوان جایگزینی سریعتر و کارآمدتر برای gzip در لایههای میانی بررسی کنید.
- روی کاهش نرخ Eviction در کشهای خود تمرکز کنید تا نرخ پاسخدهی (Latency) را بهبود ببخشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell و اثر آنها بر پردازش لبه مراجعه کنید.



گفتگو