
تصور کنید یک عامل هوش مصنوعی بهدلیل حجم بیش از حد پرامپتها، دچار اختلال در پردازش شده و پاسخهای نامرتبط میدهد. برای حل این مشکل، توسعهدهندگان در OpenAI Codex اکنون میتوانند از Codex Skills استفاده کنند؛ مکانیزمی که تصمیمگیریهای تکراری را حذف کرده و بارگذاری اطلاعات را به صورت مرحلهبهمرحله انجام میدهد. در این مدل، بهجای استفاده از پرامپتهای دائمی و حجیم، از یک معماری بارگذاری پیشرونده استفاده میشود تا عامل تنها زمانی دستورالعملهای کامل را دریافت کند که یک محرک (Trigger) خاص برای تسک فعال شده باشد.
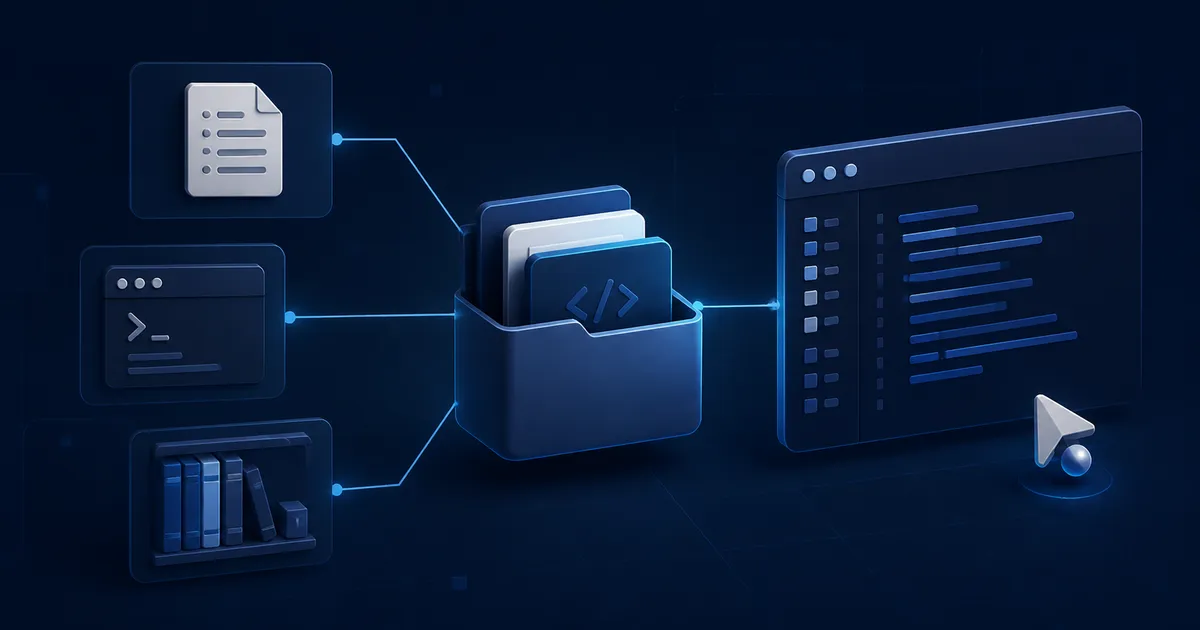
این رویکرد در زمانی ارائه شده که تیمهای فنی با پدیدهای به نام «تورم زمینه» (Context Inflation) دستوپنجه نرم میکنند. در این وضعیت، افزودن راهنماییهای بیشتر به عامل — برخلاف انتظار — باعث تضعیف استدلال آن میشود. در بسیاری از محیطهای عملیاتی، توسعهدهندگان بهاشتباه حافظه دائمی عامل را به مخزنی برای تمام سیاستهای شرکتی و دفترچههای راهنمای فنی تبدیل میکنند. این اتفاق باعث ایجاد نویز زیاد در مقابل سیگنالهای مفید شده و در نهایت منجر به توهم (Hallucination) — شبیه دوستی که با اطمینان خاطری خاطرهای کاملاً اشتباه را تعریف میکند — یا نادیده گرفتن دستورات حیاتی میشود. این چالش دقیقاً همان نقطهای است که استفاده از گیتهای اعتبارسنجی سخت به جای دستورالعملهای طولانی برای جلوگیری از خطاهای استدلالی پیشنهاد میشود.
این فلسفه شبیه کتابخانهای است که در آن کتابدار تمام کتابها را حفظ نمیکند، بلکه دقیقاً میداند برای هر پرسش خاص باید به کدام قفسه مراجعه کند. در Codex Skill، عامل ابتدا نام و شرح مهارت را میشناسد و تنها زمانی که تسک مربوطه فعال شود، فایل SKILL.md را میخواند. این استراتژی باعث میشود مراجع طولانی در پرامپت دائمی باقی نمانند و فضای پنجره زمینه (Context Window) — مثل میز کاری که فقط جای چند ورق کاغذ دارد و نه کل کتابخانه — برای کدهای واقعی آزاد بماند و از پارادوکسی که در آن «کمک بیشتر» منجر به «استدلال ضعیفتر» میشود، جلوگیری کند.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، جداسازی لایههای دسترسی و داده، کلید پایداری در سیستمهای پیچیده است.
به نقل از یک راهنمای فنی منتشر شده در ۳۰ اوت ۲۰۲۶، ساختار یک Codex Skill شامل یک دایرکتوری است که فایل اجباری SKILL.md در آن قرار دارد. این فایل در واقع قراردادی بین توسعهدهنده و عامل است. برای سبک نگه داشتن پنجره زمینه، این معماری وظایف را به چهار بخش مجزا تقسیم میکند:
- SKILL.md: تعریف رویه، ورودیهای مورد انتظار و شرایط توقف. این فایل به عنوان قرارداد اصلی عمل میکند.
- scripts/: کپسولهسازی عملیات مکانیکی یا شکننده (مثل جمعآوری لاگها) برای جلوگیری از خطاهای بازنویسی توسط مدل زبانی بزرگ (LLM). این اسکریپتها باید مانند کدهای تولیدی (Production) مدیریت شوند: قابل بازبینی، دارای محدوده مشخص و Idempotent (تکرارپذیر بدون تغییر در نتیجه).
- references/: ذخیره مستندات طولانی که فقط در شاخههای خاصی از گردشکار بارگذاری میشوند. این کار مانع از آن میشود که عامل هنگام انجام یک تسک SQLite، قوانین مربوط به Postgres را بخواند.
- assets/: شامل قالبهای (Templates) مورد نیاز برای خروجی نهایی.
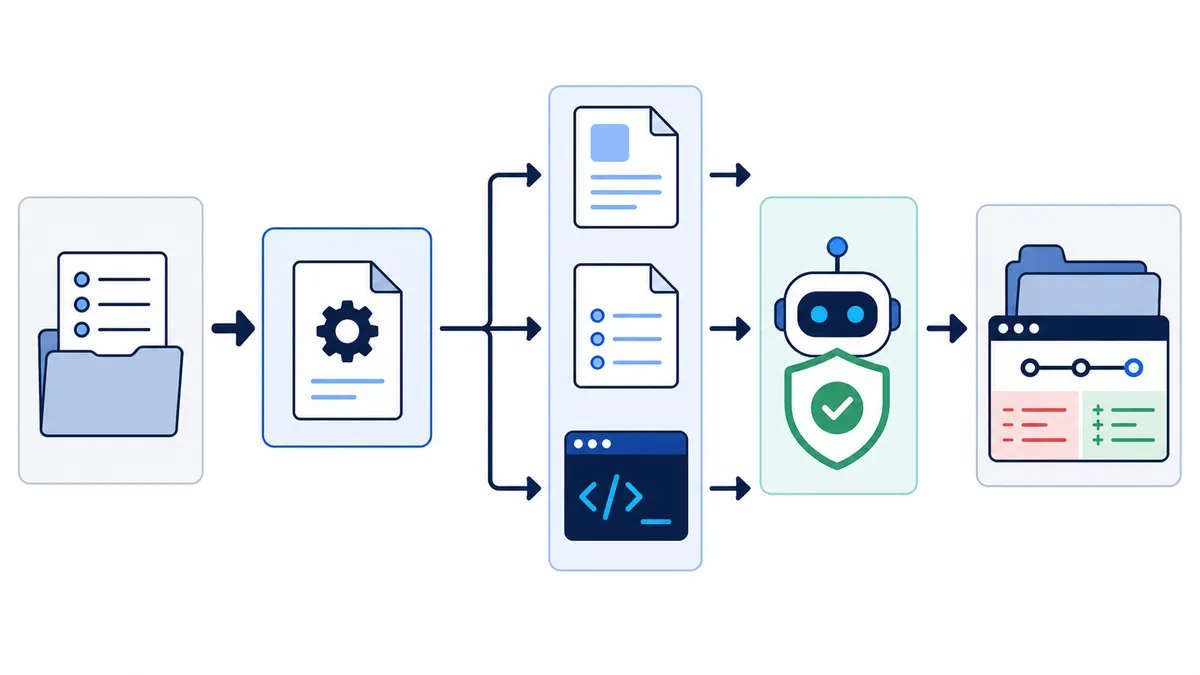
برای مقیاسپذیری این ساختار، توسعهدهندگان باید SKILL.md را کوتاه و اجرایی نگه دارند. اگر فرآیندی به ۲۰ صفحه زمینه نیاز دارد، توسعهدهنده باید شاخههای فرآیند را تفکیک کرده و جزئیات را در پوشه references/ قرار دهد. دستورات پیچیده نیز باید به پوشه scripts/ منتقل شوند و پارامترهای صریحی داشته باشند تا عامل بهجای تلاش برای بازسازی دستورات قدیمی شل (Shell) از روی پاراگرافهای مبهم، صرفاً دستورالعملها را بخواند.
در مورد متادادهها، فایل agents/openai.yaml تنها باید برای وابستگیهای نمایشی یا متاداده استفاده شود و نباید بهعنوان مکانیزم احراز هویت به کار رود. سیاستهای مربوط به سیستم فایل، شبکه و تأییدیهها باید خارج از پکیج اعمال شوند. این جداسازی مانع از این خطای رایج میشود که تصور شود یک لیست توصیفی (Declarative List) میتواند از یک راز (Secret) یا یک سرویس خارجی محافظت کند.
بر اساس مستندات Codex، بارگذاری پیشرونده بهگونهای طراحی شده که لیست اولیه مهارتها، فضای کاری را اشغال نکند. توسعهدهندگان باید از این قابلیت برای لینک دادن به مراجع در SKILL.md تنها در لحظه ایجاد دوشاخگی واقعی (مثلاً انتخاب بین یک ارائهدهنده ابری خاص، یک فریمورک یا یک پروتکل امنیتی) استفاده کنند. بارگذاری پیشدستانه چندین SDK «برای احتیاط»، هدف این معماری را باطل میکند.
یک مهارت اثرگذار از الگوی «قرارداد در بالا، جزئیات در پایین» پیروی میکند:
- سطح بالا: ورودی/خروجی مورد انتظار، محدودیتها، دستورات اعتبارسنجی و شرایط توقف.
- سطح پایین: لینک به فایلهای خاص مثل
references/postgres.mdیاreferences/aws.mdو جداول سازگاری.
این ساختار تضمین میکند که تسکی مربوط به SQLite، قوانین تولیدی Postgres را بارگذاری نکند و فضای بیشتری برای بررسی کدهای محلی توسط عامل باقی بماند.
موفقیت این سیستم به «انتخابگر» (Selector) یا همان Frontmatter مهارت بستگی دارد. توصیفهای کلی مثل «کمک در توسعه» بیفایدهاند چون بیش از حد فعال میشوند. در مقابل، یک انتخابگر دقیق مثل «بازتولید خطاهای متناوب pytest و ذخیره شواهد بدون تغییر در محیط Production»، به عامل میگوید دقیقاً چه زمانی این گردشکار را فعال کند. توصیف مهارت با ذکر نتیجه مطلوب، سیگنالهای فعالسازی و مرزهای مشخص، به عنوان یک انتخابگر عمل میکند. این رویکرد در واقع پیادهسازی عملی از تبدیل پرامپتهای تکراری به گردشکارهای بازرسیپذیر است که قابلیت انتقال بین مدلهای مختلف را فراهم میکند.
پس از فعالسازی، SKILL.md باید از افعال امری مشاهدهپذیر استفاده کند. بهجای اینکه به عامل بگوییم «از بهترین قضاوت خود استفاده کن»، یک چکلیست سختگیرانه تعریف میکنیم: ابتدا بررسی کن، تغییرات موجود را حفظ کن، دستور بازتولید را اجرا کن و شواهد را گزارش بده. این کار تضمین میکند دو کاربر مختلف، فارغ از نحوه بیان درخواست، نتیجه یکسانی بگیرند.
برای یک مخزن پایتون، نمونهای از فایل .agents/skills/pytest-regresion/SKILL.md شامل موارد زیر است:
- نام:
pytest-regresion - توضیح: بازتولید و رفع خطای pytest در صورت وجود تست، Stack Trace یا دستور خطا. (نه برای بازسازی کد یا تغییرات زیرساختی).
- گامها:
۱. خواندنAGENTS.mdو حفظ تغییرات غیرمرتبط.
۲. اجرای تست؛ اگر دستور بازتولید وجود نداشت، توقف و درخواست دستور دقیق.
۳. افزودن یک تست رگرسیون حداقلی در ابتدا.
۴. تغییر تنها در ماژول مربوط به خطا.
۵. اجرای pytest روی تست اثرپذیر و مجموعه impacted.
۶. تحویل فایلهای تغییر یافته، دستور استفاده شده، نتایج و ریسکهای باقیمانده.
توسعهدهندگان نباید Codex Skills را با AGENTS.md اشتباه بگیرند. در حالی که AGENTS.md حاکم بر قوانین دائمی مخزن (مثل مرزهای امنیتی، دستورات تست، کنوانسیونها و مسیرهای حساس) است، یک Skill یک گردشکار تخصصی برای کلاسی خاص از تسکهاست. کپی کردن قوانین کلی در هر مهارت، باعث ایجاد سیاستهای متناقض و سردرگمی عامل میشود.
همچنین، مهارتها راهی برای دور زدن امنیت نیستند. سندباکس (Sandbox)، اعتبارنامههای نشست (Session Credentials) و سیاستهای تأیید، همچنان کنترلهای اصلی هستند. یک مهارت میتواند اسکریپتی را توصیه کند، اما محیط میزبان تصمیم میگیرد که آیا آن اسکریپت اجازه اجرا دارد یا خیر. مهارت روی «رویه» تصمیم میگیرد، اما کنترلهای نشست و اعتبارسنجی تصمیم میگیرند که آیا تغییر پذیرفته است یا خیر.
استفاده از اسکریپتها زمانی مناسب است که توالی عملیات مکانیکی و بازنویسی آنها خطرناک باشد (مثل مقداردهی Fixtureها، جمعآوری لاگهای سانسور شده یا اعتبارسنجی یک Manifest). یک اسکریپت خوب باید:
- آرگومانهای صریح بخواهد و کدهای خروجی (Exit Codes) مفیدی برگرداند.
- تصمیمات معماری، استقرارهای برگشتناپذیر یا پرامپتهای مبهم را در خود پنهان نکند.
- در برابر تلاشهای مجدد (Retries) ایمن باشد، پیشنیازها را بررسی کند و از مسیرهای نسبی مخزن استفاده کند.
- حالت
--dry-runرا برای تغییرات منابع خارجی ارائه دهد.
برای مثال، اسکریپتی مانند collect_failure.py --test tests/api/test_auth.py باید یک آرتیفکت محلی سانسور شده را ذخیره کند، اما نباید صرفاً چون نام یک تست شبیه به یک حادثه است، با محیط Production تماس بگیرد. هدف کاهش «شعاع تخریب» (Blast Radius) است، نه راحتتر کردن فرآیند به قیمت امنیت.
برای اینکه یک گردشکار عملی باشد، باید سه آزمون را پاس کند: «مسیر خوشبینانه» (Happy Path)، «ورودی ناقص» و «مخزن کثیف» (دارای تغییرات محلی). در مورد ورودی ناقص، عامل باید با یک پرسش مشخص متوقف شود؛ در مورد مخزن کثیف، باید کارهای موجود حفظ شوند. اگر رویه در این سناریوها خروجی امنی نداشته باشد، شایسته خودکارسازی نیست.
پس از پایداری و اعتبارسنجی یک مهارت، میتوان آن را به یک پلاگین تبدیل کرد. پلاگینها اجازه توزیع مهارتها، کانکتورها و هوکهای MCP (پروتکل زمینه مدل) را در چندین پروژه میدهند. با این حال، راهنما هشدار میدهد که توزیع زودهنگام یک رابط ناپایدار، منجر به بدهی فنی میشود. توزیع مهارتها تهدیدات امنیتی را حذف نمیکند؛ هوکها و سرورهای MCP میتوانند دسترسی به سیستمهای خارجی ایجاد کنند. کاربران باید بتوانند بخشهای Read-only را بدون دادن مجوزهای تغییر (Mutant Permissions) نصب کنند.
توسعهدهندگان باید توجه کنند که مخزن openai/skills اکنون نمونههای فعلی را به مخزن پلاگینها و راهنمای «ساخت پلاگینها» ارجاع میدهد. حفظ تستهای مهارت پیش از تغییر کانال توزیع بسیار حیاتی است.
برخی از رایجترین خطاهای تبدیل یک مهارت به یک نقطه ضعف عبارتاند از:
- توصیفات کلی: فعال شدن برای تسکهای ناسازگار.
- تکرار سیاستها: کپی کردن
AGENTS.mdو ایجاد قوانین متضاد. - تخلیه زمینه: قرار دادن مستندات گسترده در
SKILL.mdبهجایreferences/. - اسرار ضمنی: فراخوانی اسکریپتها با مسیرهای مطلق، اسرار ضمنی یا اثرات خارجی اعلام نشده.
- سردرگمی در مجوزها: تلقی کردن متادادههای پلاگین به عنوان سد امنیتی.
- فقدان شرایط توقف: تعریف نکردن لحظه توقف در صورت نبود داده، مجوزها یا دستور بازتولید.
- توزیع زودهنگام: استقرار پیش از تست سناریوهای «مخزن کثیف» یا «شکست امن».
اعتبارسنجی نباید بر اساس جمله «عامل گفت کار میکند» باشد. یک مهارت موفق باید یک Diff قابل بازبینی، یک تست رگرسیون و دستور دقیق اجرا شده را تولید کند. «عامل گفت کار میکند» اعتبارسنجی نیست.
برای اندازهگیری شکست، به این سیگنالها توجه کنید:
- شکاف شفافیت: اگر عاملها مدام دستوراتی را میپرسند که در مستندات وجود دارد، قرارداد مهارت شفاف نیست.
- بارگذاری بیش از حد: اگر مراجعی را میخوانند که استفاده نمیکنند یا کدهای محلی را نادیده میگیرند، مهارت بیش از حد بارگذاری میشود.
راه حل بهندرت افزودن مستندات بیشتر است، بلکه جداسازی دو گردشکار است که هدف یکسانی ندارند.
این تغییر در طراحی عاملها نشان میدهد که آینده بهرهوری AI نه در پنجرههای زمینه بزرگتر، بلکه در ارکستراسیون هوشمندانه نحوه پر شدن این پنجرههاست. با تبدیل دستورالعملهای عامل به کدهای تولیدی (نسخهبندی شده، محدود و Idempotent)، تیمها میتوانند سیستمهای خودمختاری بسازند که با رشد پروژه، دچار افت کیفیت نشوند. این تحول در مدیریت زمینه، پیشنیاز رسیدن به اتوماسیون عاملمحور در SaaS است که در آن سامانهها بهجای اجرای دستورات ایستا، بهصورت پیشبین عمل میکنند.
برای شروع پیادهسازی، توسعهدهندگان باید یک تسک تکراری و قابل اعتبارسنجی (مثل بازتولید باگ CI یا آمادهسازی یک Migration) را شناسایی کنند و یک SKILL.md حداقلی بسازند تا رفتار بارگذاری پیشرونده را تست کنند. بهجای تلاش برای تبدیل عامل به یک «متخصص همهفنحریف» برای شرکت، بر کاهش ابهام برای یک فرآیند واحد و قابل اعتبارسنجی تمرکز کنید.
گام بعدی شما
- یک تسک تکراری و قابل اعتبارسنجی (مثل بازتولید باگ CI) را شناسایی کنید.
- یک
SKILL.mdحداقلی بسازید تا رفتار بارگذاری پیشرونده را تست کنید. - از تعریف توصیفات بسیار دقیق برای Selectorها استفاده کنید تا از فعالسازیهای اشتباه جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو