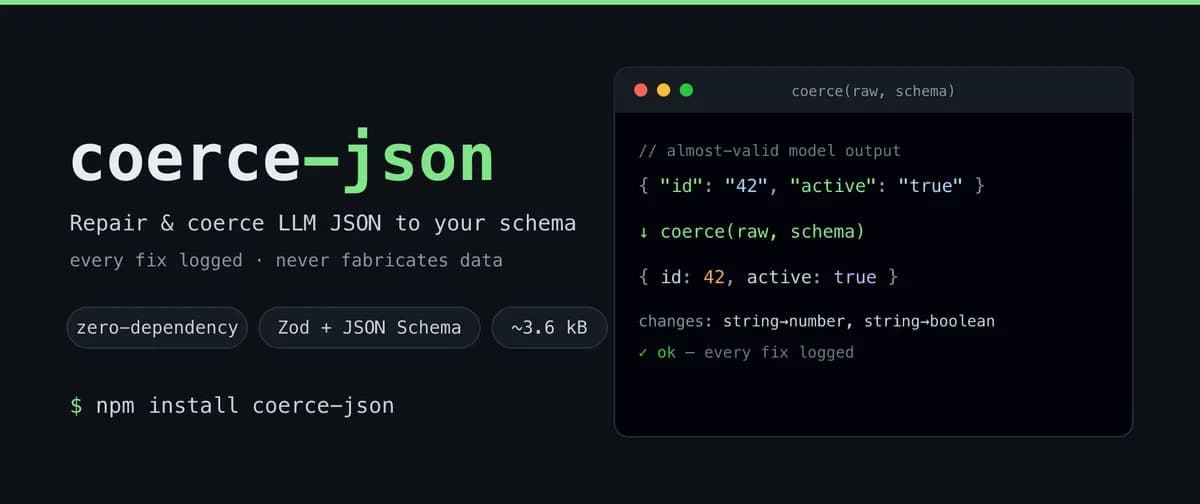
تصور کنید یک خطای کوچک در قرارگیری علامتهای Markdown یا تبدیل یک عدد به رشته، کل خط لوله تولیدی هوش مصنوعی شما را به طور کامل متوقف کند. برای حل این مشکل، در ۸ اکتبر ۲۰۲۶ کتابخانه coerce-json منتشر شد؛ ابزاری که خروجیهای مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — را بدون نیاز به فراخوانی مجدد مدل، با یک طرحواره (Schema) پیشفرض همراستا میکند.
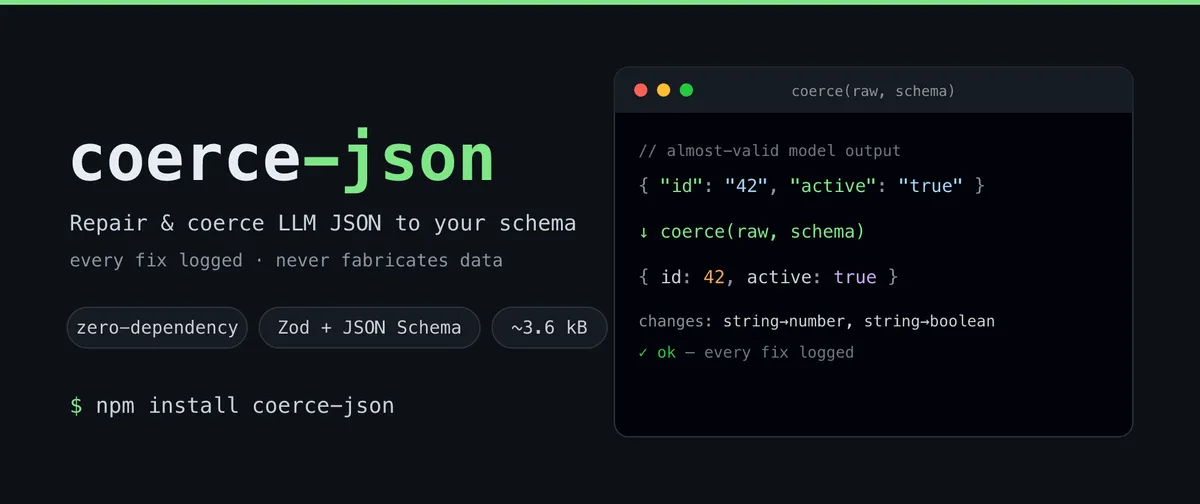
ادغام مدلهای زبانی در نرمافزارها معمولاً نیازمند دادههای ساختاریافته است، اما مدلها اغلب خروجیهایی «تقریباً معتبر» برمیگردانند. آنها ممکن است شیء JSON را در میان متون توضیحی قرار دهند، بهجای مقدار true از کلمه "yes" استفاده کنند یا عدد را بهصورت رشته برگردانند. برای مثال، درخواستی برای { id: number, active: boolean } ممکن است خروجی {"id": "42", "active": "true", "role": "admin"} را در یک بلوک کد Markdown برگرداند. این اتفاق باعث میشود تابع JSON.parse روی علامتهای Markdown و کتابخانه Zod روی نوع دادهها خطا دهد. همانطور که در تحلیل قبلی ما دربارهی مهندسی یکپارچهسازی و کاهش ۴۰ درصدی هزینههای عملیاتی اشاره کردیم، صنعت اکنون از پرامپتنویسی ساده به سمت خط لولههای پردازش پساز-تولید (Post-processing) حرکت میکند تا پایداری سیستمها تضمین شود.
شکست روشهای سنتی
به نقل از مستندات پروژه، توسعهدهندگان در حال حاضر از سه روش ناقص برای مدیریت JSONهای معیوب استفاده میکنند:
- اجبار Zod (Zod Coercion): اگرچه
z.coerceوجود دارد، اما فیلد به فیلد عمل میکند و نمیتواند متون توضیحی یا بلوکهای Markdown را حذف کند. همچنین در مورد مقادیر بولی شکست میخورد؛ زیراz.coerce.boolean()صرفاً تابعBoolean(x)را فراخوانی میکند، به این معنی که رشته "false" به مقدار true تبدیل میشود. علاوه بر این، این تبدیلها بهصورت خاموش اتفاق میافتند و هیچ گزارشی از تغییرات باقی نمیگذارند. - ابزارهای ترمیم نحو (Syntax Repair): کتابخانههایی مثل
json-repairخطاهای نحوی مثل پرانتزهای بسته نشده، نقلقولهای گمشده یا کاماهای اضافی در انتهای شیء را اصلاح میکنند، اما نسبت به طرحواره (Schema) کور هستند. اگر ورودی{"id":"42"}باشد، همان را برمیگرداند چون از نظر نحوی درست است، حتی اگر طرحواره عدد بخواهد. - پرامپت مجدد (Re-prompting): ابزارهایی مانند instructor-js خروجی را اعتبارسنجی کرده و در صورت خطا، پیام خطا را به مدل میفرستند تا دوباره تلاش کند. این کار یک تبدیل محلی در حد میکروثانیه را به یک درخواست شبکه هزینهبر با مصرف توکن بیشتر و نتایج غیرقطعی تبدیل میکند.
سازوکار عملکرد coerce-json
کتابخانه coerce-json مانند یک پل آگاه از طرحواره عمل میکند. این ابزار طرحواره Zod یا JSON را میخواند و مقدار را به سمت آن سوق میدهد و همزمان یک گزارش بازرسی (Audit Log) دقیق از هر تغییر ثبت میکند.
مکانیزمهای اصلی
- استخراج خودکار: بلوکهای کد Markdown (مانند
```json) و متون پیرامونی را حذف میکند. اگر مدل پاسخ دهد: «حتماً! بفرمایید:{"a":"1"}»، کتابخانه ابتدا JSON را استخراج و سپس انواع دادهها را اصلاح میکند. - همراستاسازی نوع: اگر طرحواره عدد بخواهد، رشته "42" را به عدد ۴۲ تبدیل میکند. همچنین مقادیر بولی را بر اساس نحوه بیان واقعی مدلها مدیریت میکند و کلماتی مثل "yes" یا "on" را به true نگاشت میکند.
- Enumهای غیرحساس به حروف: بهصورت پیشفرض، حروف بزرگ و کوچک را اصلاح میکند (مثلاً تبدیل "ACTIVE" به "active") تا با تعاریف طرحواره مطابقت یابد. این قابلیت بهصورت پیشفرض فعال است.
- تزریق مقادیر پیشفرض: فیلدهای اختیاری گمشده را با استفاده از مقادیر پیشفرض مستند شده در طرحواره پر میکند. برای مثال، اگر فیلد
roleگمشده باشد اما مقدار پیشفرض آن "user" باشد، کتابخانه آن را پر کرده و این اقدام را ثبت مینماید.
اجبار پیشرفته (Advanced Coercion)
برای انعطاف بیشتر، این کتابخانه حالت { fuzzy: true } را ارائه میدهد. این حالت حدسهای «کمدقتتر» یا دارای تلفات را مدیریت میکند که پتانسیل تغییر معنا را دارند، مانند:
- خطاهای نزدیک در Enum: تبدیل "activ" به "active".
- اصلاح کلیدها: نگاشت
first_nameبهfirstName.
برای جلوگیری از تخریب دادهها، تطبیقهای مبهم بهجای حدس زدن، رد میشوند تا از فساد دادهها جلوگیری شود.
عملکرد و اعتماد
بر اساس یک محک (Benchmark) روی ۳۷ خطای رایج مدلهای زبانی — شامل اعداد رشتهای، مقادیر بولی "yes" و اشیاء محصور در متن — اعتبارسنجی ساده Zod تنها در ۱۳.۵٪ موارد موفق بود. استفاده از coerce-json با تنظیمات پیشفرض، نرخ موفقیت را به ۸۶.۵٪ رساند و فعالسازی تطبیق fuzzy این عدد را به ۱۰۰٪ تغییر داد. (این نتایج بر اساس یک مجموعه داده نمونه است که جزئیات آن در فایل BENCHMARKS.md پروژه آمده است). این رویکرد در واقع پاسخی به چالشهای ارزیابی است که در تحلیل ما درباره ضرورت جایگزینی تستهای سنتی با ارزیابیهای معنایی مورد بحث قرار گرفت.
برای تضمین ایمنی در محیط تولید، این کتابخانه چهار اصل تغییرناپذیر را رعایت میکند که توسط تستهای ویژگی (Property Tests) بررسی میشوند:
۱. عدم جعل: هرگز دادهای خارج از مقادیر پیشفرض مستند شده در طرحواره اختراع نمیکند.
۲. قابلیت بازرسی کامل: هر تغییر در یک آرایه changes ثبت میشود. این آرایه تنها زمانی خالی است که خروجی دقیقاً برابر با ورودی باشد.
۳. تکرارپذیری (Idempotency): اصلاح یک مقدارِ از قبل معتبر، هیچ تغییری ایجاد نمیکند (no-op). اجرای مجدد عملیات اصلاح روی هر خروجی، چیزی را تغییر نمیدهد و به یک نقطه ثابت (Fixpoint) میرسد.
۴. امنیت: در برابر حملات Prototype Pollution ایمن است؛ کلیدهایی مثل __proto__ ، constructor و prototype حذف و در گزارش ثبت میشوند.
خط لوله استریمینگ
این ابزار برای کار در کنار trickle-json (یک تجزیهکننده JSON جزئی و افزایشی) طراحی شده است. این ترکیب یک جریان کامل استریمینگ ایجاد میکند: سیستم دادهها را از طریق SSE دریافت میکند، از StreamingJsonParser برای ارائه بهترین مقدار موجود در هر تکه (Chunk) بدون ایجاد خطا استفاده میکند و در نهایت coerce-json را برای ترمیم و اعتبارسنجی شیء نهایی پیش از ذخیره در پایگاهداده به کار میگیرد.
این رویکرد شکافی را پر میکند که خروجیهای ساختاریافته (Structured Outputs) ارائهدهندگان ایجاد کردهاند. در حالی که OpenAI با معماری جدید خود برای حذف خطاهای تجزیه JSON محدودیتهای داخلی ایجاد کرده است، این ویژگیها از مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که دستور پختشان علناً منتشر شده — یا نقاط انتهایی قدیمی API و همچنین بخشهای استریم شدهای که در متن محصور شدهاند، پشتیبانی نمیکنند.
پیادهسازی و سازگاری
برای توسعهدهندگانی که از Zod استفاده نمیکنند، این کتابخانه از طریق یک هوک Ajv اختیاری از JSON Schema برای اعتبارسنجی مرجع پشتیبانی میکند. این ابزار یک کتابخانه بدون وابستگی (Zero-dependency) است (با Zod و Ajv بهعنوان وابستگیهای اختیاری) که از هر دو استاندارد ESM و CJS همراه با تعاریف کامل تایپ (Type Definitions) و منشأ (Provenance) پشتیبانی میکند.
با نگاه به خروجی مدلهای زبانی بهعنوان یک سیگنال خام که نیاز به اصلاح دارد (و نه یک سند بینقص)، تیمها میتوانند نرخ خطای گردشکارهای عاملمحور (Agentic) خود را بهشدت کاهش دهند. این تبدیل خروجیهای ساختاریافته به دادههای قابل اعتماد، در واقع همان گامی است که ابزارهایی مانند Jev برای تبدیل خروجیها به موتورهای تصمیمگیری کالیبرهشده دنبال میکنند. برای پیادهسازی این مورد، توسعهدهندگان میتوانند کتابخانه را از طریق npm نصب کرده و آن را بهعنوان آخرین مرحله از مدیریت پاسخ LLM پیش از اعتبارسنجی نهایی ادغام کنند.
گام بعدی شما
- اگر از مدلهای متنباز (Local LLMs) استفاده میکنید، این کتابخانه را جایگزین تلاشهای مکرر برای اصلاح پرامپت کنید.
- برای سیستمهای حساس، آرایه
changesرا مانیتور کنید تا بفهمید مدل در کدام فیلدها بیشترین خطا را دارد. - ترکیب این ابزار با
trickle-jsonرا برای کاهش تأخیر در رابط کاربری (UI) امتحان کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو