تصور کنید گزارش یک جلسه ذکر میکند که عرضه محصول روز جمعه است، اما اصلاحیهای که بعداً اعمال میشود، تاریخ را به دوشنبه تغییر میدهد. اگر دستیار هوش مصنوعی شما نسخه اول را بازیابی کند، سیستم کرش نکرده است، اما «هوش» آن کاملاً اشتباه است. برای حل این مشکل، یک اتصالدهنده (Connector) جدید برای Cognee در جریان رویداد WeMakeDevs × Cognee Mergetober توسعه یافته است تا بهطور خاص ماهیت سیال گزارشهای Read.ai را مدیریت کند.
اکثر خط لولههای داده فرض میکنند که یک سند پس از وارد شدن، ایستا میماند. با این حال، خلاصههای جلسات اغلب پس از پایان تماس ویرایش میشوند تا تصمیمات نهایی را منعکس کنند. در یک ساختار استاندارد تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — این تغییرات بازنگرانه نادیده گرفته میشوند چون تاریخ جلسه تغییر نکرده است و در نتیجه هوش مصنوعی با زمینهای قدیمی و منقضیشده باقی میماند. همانطور که در تحلیلهای قبلی ما دربارهی مدیریت حافظه در عاملهای هوش مصنوعی اشاره کردیم، نبودِ مکانیزم بهروزرسانی منجر به ایجاد توهمات مبتنی بر دادههای قدیمی میشود.
زمینه و ضرورت همگامسازی
طبق مستندات، فیلترهای تاریخ Read.ai از زمان شروع جلسه استفاده میکنند، نه زمان ویرایش گزارش. بنابراین یک نشانگر (Cursor) ساده که فقط بر اساس تاریخ عمل میکند، اصلاحاتی که ماه پیش در یک خلاصه صورت گرفته را نمیبیند. این موضوع شکافی ایجاد میکند که در آن فرآیند وارد کردن داده (Import) با موفقیت انجام شده، اما نسخهی موجود در سیستم صرفاً قدیمی است.
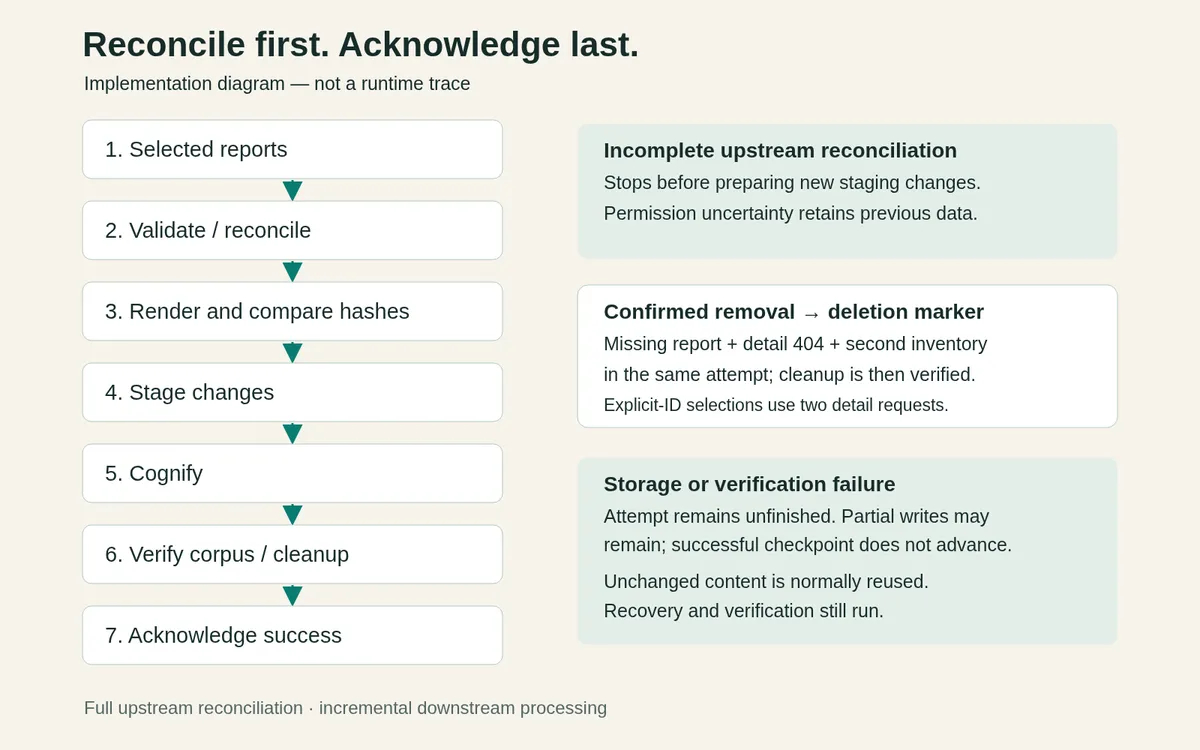
این اتصالدهنده از طریق تابع sync_read_ai(...) یک گردشکار پیچیده برای همگامسازی را اجرا میکند. بهجای تکیه بر فیلترهای ساده تاریخ، این ابزار از «تطبیق کامل بالادستی» (Full Upstream Reconciliation) استفاده میکند. سیستم گزارشهای منتخب را مجدداً بررسی کرده، محتوا را بهطور سازگار رندر میکند و با مقایسه هشها (Hashes)، تغییرات را شناسایی میکند. این سازوکار تضمین میکند که تنها محتوای جدید یا تغییریافته به مراحل بعدی ارسال شود و از تکرار عملیات استخراج و تبدیل به بردار (Embedding) برای اسنادی که تغییری نکردهاند، جلوگیری شود. این رویکرد بهینهسازی در پردازش دادهها، مشابه راهکارهایی است که Infrai برای تسهیل اتوماسیون خلاصهسازیهای چندزبانه به کار گرفته است تا جریان دادهها را با دقت بیشتری مدیریت کند.
جزئیات فنی پیادهسازی
- احراز هویت: سیستم بهجای کلیدهای API ساده، از پروتکل OAuth 2.1 استفاده میکند. دستور
read-ai-connectتنظیمات اولیه را مدیریت میکند. همچنین، فرآیند نوسازی توکنها (Token Refresh) بهصورت «قفلشده» (Process-locked) طراحی شده است تا در صورت اجراهای همزمان، چندین فرآیند بهطور همزمان یک اعتبارنامه واحد را نوسازی نکنند. - جریان داده: کاربران میتوانند شناسههای جلسه (Meeting IDs) یا یک بازه زمانی خاص را انتخاب کنند و تعیین کنند که آیا خلاصهها، متن کامل گفتگوها (Transcripts) و معیارهای تحلیلی (Metrics) گنجانده شوند یا خیر. هر گزارش به یک سند تبدیل میشود که در آن ابتدا خلاصه و در انتها متن کامل قرار میگیرد. نام شرکتکنندگان، برچسبهای زمانی و لینکهای گزارش برای حفظ زمینه (Context) محیطی حفظ میشوند.
- پردازش افزایشی: گردشکار شامل مراحل وارد کردن، بازیابی، پردازش در Cognee و تأیید پاکسازی است. تنها محتوای تغییریافته پردازش میشود که بار محاسباتی روی خط لوله بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است تا همسایگان معناییاش را بشناسد — بهشدت کاهش میدهد.
- تأییدیه: یک نقطه بازرسی (Checkpoint) موفق تنها زمانی ثبت میشود که مراحل وارد کردن، پردازش در Cognee و تأیید نهایی بهطور کامل به پایان رسیده باشند. صرفاً بارگذاری دادهها در محیط Stage به معنای اتمام همگامسازی نیست.
شواهد و نمایش عملی
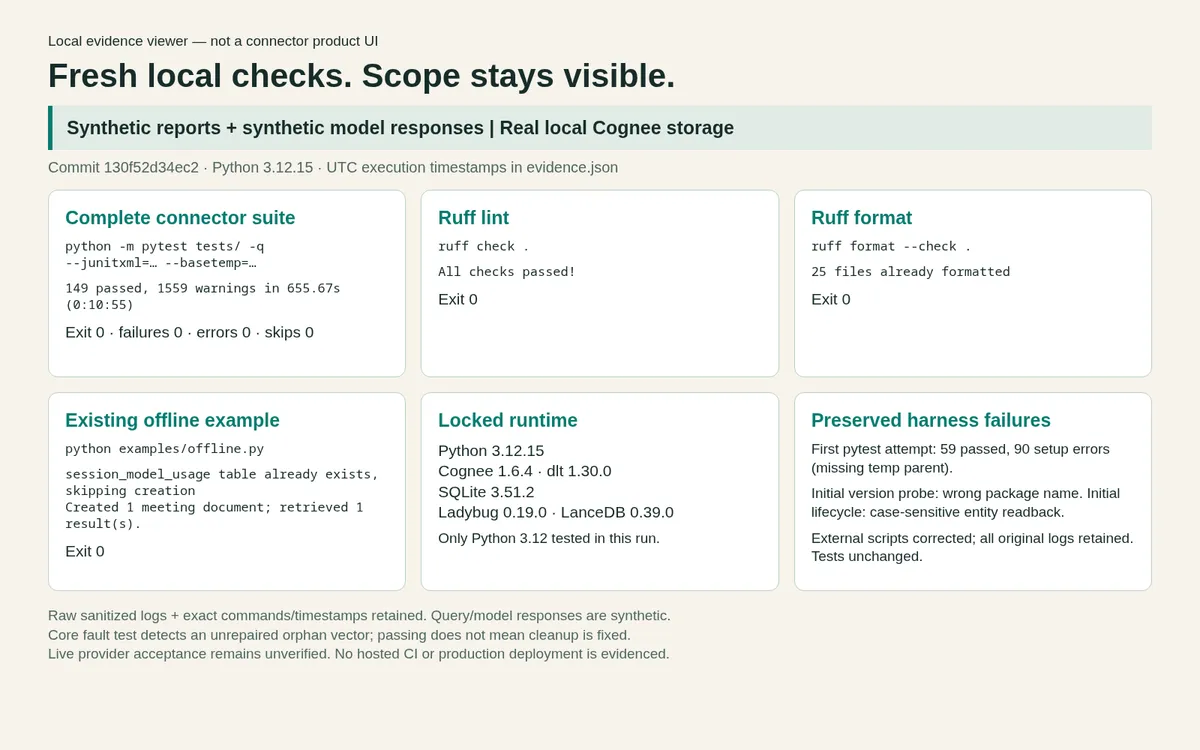
در یک نمایش محلی با استفاده از Python 3.12.15، این کانکتور در برابر گزارشهای مصنوعی و پاسخهای مدل با استفاده از ذخیرهسازهای محلی واقعی تست شد. این آزمایش از Cognee 1.6.4, dlt 1.30.0, SQLite, Ladybug و LanceDB استفاده میکرد.
دمو با دو گزارش تخیلی شروع شد: یک برنامه عرضه محصول برای روز جمعه و یک گزارش تحویل پشتیبانی. وقتی گزارش عرضه محصول به دوشنبه تغییر یافت، سیستم با موفقیت ارجاعات سند قدیمی و بردارهای تکهبندی شده (Chunk Vectors) را حذف کرد. در نتیجه، تکه بازیابی شده بهدرستی حاوی این عبارت بود: «Alphacorp و Sharedcorp پس از بررسی امنیتی، عرضه را به دوشنبه منتقل کردند.»
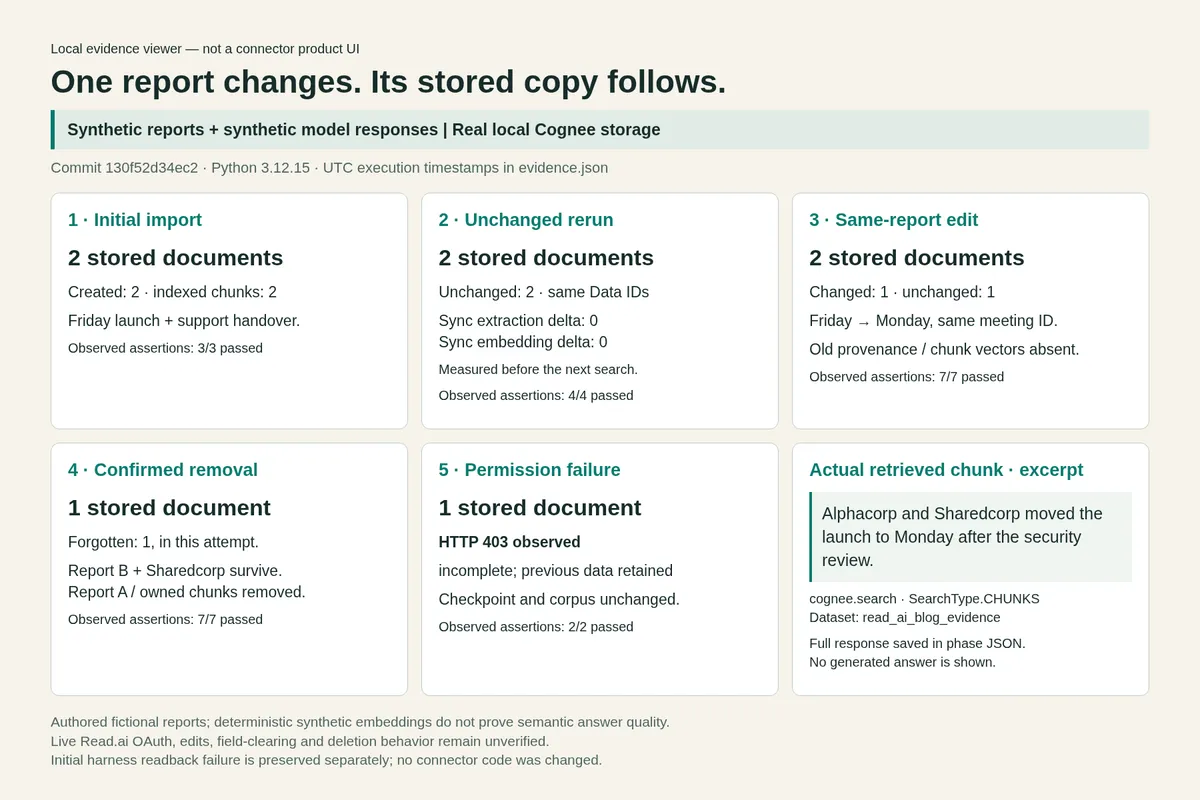
مجموعه تستها ۱۴۹ مورد موفقیتآمیز را بدون هیچگونه شکست، خطا یا نادیده گرفتن (Skip) گزارش کردند، هرچند ۱۵۵۹ هشدار (Warning) ثبت شد. همچنین وقتی گزارشی از منبع مصنوعی حذف شد، سند مربوطه و تکههای متعلق به آن در طول همگامسازی ناپدید شدند، در حالی که گزارش تحویل پشتیبانی و موجودیتهای مشترک آن باقی ماندند.
مدیریت حذفها و شکستها
یک مورد بحرانی (Edge Case)، حذف دادهها است. برای جلوگیری از حذف تصادفی دادهها به دلیل خطاهای موقت شبکه یا صفحات خراب، یک گزارش تنها در صورتی حذف میشود که سه شرط زیر در یک تلاش همگامسازی برقرار باشد:
۱. گزارش در فهرست کامل موجودات (Inventory) غایب باشد.
۲. هنگام تلاش برای بازیابی، خطای ۴۰۴ بازگرداند.
۳. در یک فهرست کامل دوم نیز همچنان غایب باشد.
این رویکرد تمرکز را از «وارد کردن ساده داده» به «همگامسازی وضعیت» تغییر میدهد. برای توسعهدهندگان، این بدان معناست که پایگاه دانش هوش مصنوعی همگام با گفتگوهای انسانی تکامل مییابد. این امر بار دستیِ خروجی گرفتن و آپلود مجدد گزارشها را هر بار که یک مدیر پروژه یادداشتهای جلسه را اصلاح میکند، از بین میبرد. چنین اتوماسیونهایی در واقع همان هدفی را دنبال میکنند که متخصصان غیرفنی در طراحی ابزارهای داخلی سفارشی برای حذف فرآیندهای تکراری دستی به دنبالش هستند.
با این حال، پیادهسازی این ابزار یک محدودیت را در Cognee 1.6.4 آشکار کرد. یک بردار از نوع «رابطه» (Relationship-type vector) ممکن است پس از حذف گره گراف مربوطه، در صورت شکست در حذف بردار، باقی بماند. کانکتور این بقایای داده را شناسایی کرده و یک VerificationError صادر میکند و از پیشروی نقطه بازرسی موفق جلوگیری میکند. در حال حاضر، رفع این مشکل نیازمند تغییر در هسته سیستم یا مداخله اپراتور است.
این ابزار ثابت میکند که چالش اصلی در هوش مصنوعی سازمانی، صرفاً بازیابی دادهها نیست، بلکه مدیریت چرخه حیات آن دادههاست. از آنجایی که هوش جلسات به بخشی از زیرساخت AI تبدیل میشود، توانایی مدیریت «بهروزرسانیهای خاموش»، تفاوت بین دستیارهای قابل اعتماد و دستیارهایی را که بر اساس حقایق قدیمی توهم میزنند، مشخص خواهد کرد.
گام بعدی شما
- اگر از Read.ai برای مستندسازی جلسات استفاده میکنید، این کانکتور را برای جلوگیری از توهمات مدل در مورد تصمیمات تغییریافته تست کنید.
- بررسی کنید که آیا پایگاه دانش شما مکانیزمی برای شناسایی «بهروزرسانیهای خاموش» در اسناد دارد یا خیر.
- برای کاهش هزینه استنتاج، از متدهای پردازش افزایشی (Incremental) بهجای بازسازی کامل ایندکسها استفاده کنید.
اما مدیریت چرخه حیات دادهها تنها بخشی از ماجراست؛ برای درک چگونگی اتصال این دادهها به حافظه بلندمدت عاملها، تحلیل ما درباره پروتکل MCP را بخوانید.



گفتگو