۲۹۰ هزار توکن؛ این مبلغی است که یک عامل کدنویس برای رفع یک باگ ساده در ۱۰ دور ارتباطی میسوزاند، اگر کورکورانه تمام نتایج ابزارها در هر مرحله بازخوانی کند. این ناکارآمدی تنها یک مسئله مالی نیست، بلکه یک شکست در قابلیت اطمینان است که منجر به کرشهای ناشی از سرریز زمینه (Context-overflow crashes) میشود. این موضوع یادآور هزینههای پنهان اتوماسیون است که در آن عاملهای زمانبندیشده با بازخوانی مداوم دادهها، توکنهای توسعهدهندگان را میسوزانند. طبق تحلیلهای وبسایت dev.to، راز مقیاسپذیری عاملها نه در پنجرههای زمینه بزرگتر، بلکه در یک «فشردهساز زمینه» (Context Compactor) نهفته است که تصمیم میگیرد مدل واقعاً اجازه دیدن چه بخشهایی از دادهها را داشته باشد.
بسیاری از حلقههای عملیاتی عاملها یک عادت خاموش و گرانقیمت دارند: آنها در هر دور، تمام تاریخچه گفتگو — شامل پرامپتهای سیستمی، وظایف محول شده و تکتک خروجیهای ابزارها — را دوباره به مدل میفرستند. تصور کنید یک لاگ تست با ۲۰ هزار توکن دارید؛ شما هزینه آن را یکبار نمیپردازید، بلکه هر بار که عامل برای گام بعدی تصمیم میگیرد، دوباره بابت همان ۲۰ هزار توکن هزینه میکنید. این وضعیت باعث انفجار خطی هزینهها میشود تا جایی که مدل در نهایت به سقف سخت پنجره زمینه (Context Window) میرسد. پنجره زمینه شبیه میز کاری است که فقط جای چند ورق کاغذ دارد، نه کل کتابخانه؛ وقتی میز پر شود، مدل یا دادههای قدیمی را فراموش میکند یا به طور کامل از کار میافتد.
این مشکل در اواخر سال ۲۰۲۶ به نقطه تمرکز پژوهشگران حوزه عاملهای هوشمند تبدیل شد. در ۱۷ سپتامبر ۲۰۲۶، مطالعهای با عنوان «بررسی تجربی طراحی هارنس برای عاملهای کدنویسی» (An Empirical Study of Harness Design for Coding Agents) منتشر شد که ۱۷۶ تنظیمات جفتشده را تحلیل کرده بود. پژوهشگران دریافتند که با تنگتر شدن پنجرههای زمینه، مدیریت زمینه حیاتی میشود و بیشترین سود این مدیریت، جلوگیری از شکستهای ناشی از سرریز است. به طور مشخص، آنها دریافتند که «حذف قاعدهمند» (Rule-based elision) — یعنی حذف دادهها بر اساس قوانین سختگیرانه پیش از آنکه سراغ خلاصهسازی توسط LLM بروند — بهترین بهرهوری کلی را فراهم میکند.
چرخش صنعت به سمت فشردهسازی قاعدهمند
چندین بازیگر اصلی اخیراً این یافتهها را برای بهینهسازی ساختارهای هارنس (Harness) خود پیاده کردهاند:
- Strands Agents: در ۲۱ سپتامبر ۲۰۲۶، این تیم Strands harness را معرفی کرد و گزارش داد که با استفاده از مدلهای Claude و GPT، هزینههای توکن را در ۶ بنچمارک مختلف ۲۸٪ کاهش داده است. استراتژی آنها شامل برش (Truncating) نتایج ابزارهایی است که بیش از ۱,۵۰۰ توکن دارند و فعال کردن فشردهسازی زمانی که پنجره به ۸۵٪ ظرفیت میرسد. آنها در گزارش خود ذکر کردند: «مدیریت پیشفرض زمینه ما، عامل اصلی بهرهوری توکن و دقت سیستم بود.»
- CliffCompaction: در ۲۲ سپتامبر ۲۰۲۶، این پروژه گزارش داد که در بسترهای محدود، هزینهها تا ۵۰٪ کاهش یافته است. قانون سختگیرانه آنها این است: محتوا را فقط برش بزن یا حذف کن، هرگز آن را بازنویسی (Rephrase) نکن و هرگز بخشی را که قبلاً فشرده شده است، دوباره فشرده نکن. این رویکرد با راهکار انویدیا برای بهینهسازی عاملهای AI همسو است که با اتوماسیون منطق کنترل، مصرف توکنها را تا ۴۹٪ کاهش داد.
- DeepSeek: در ۳ اکتبر ۲۰۲۶، شرکت DeepSeek نسخه Harness v0.2.1-alpha.1 را منتشر کرد که آخرین بیلد از هارنس متنباز آنهاست (رویکردی که در آن هر چیزی یک پلاگین است). در بنچمارکهای Strands، هارنس DeepSeek بیشترین بهرهوری توکن را در کل داشت، هرچند معمولاً کمترین میزان صحت (Accuracy) را ثبت کرد.
ساخت یک فشردهساز زمینه کوچک
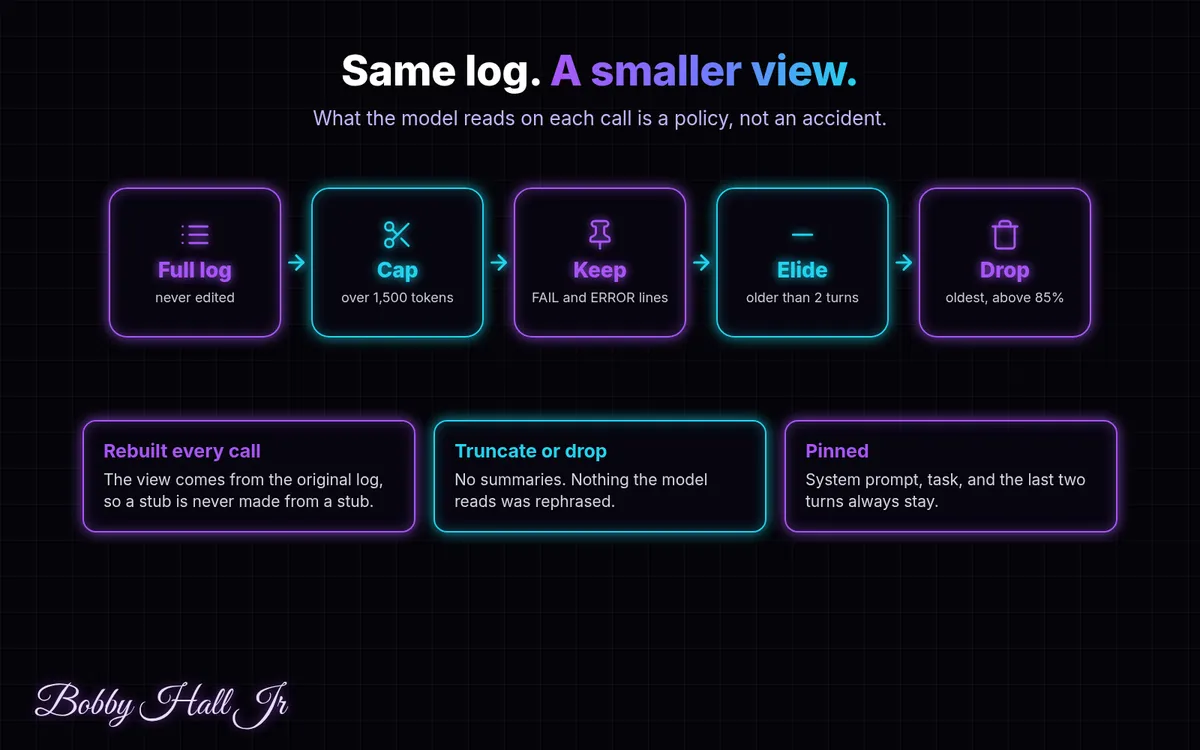
برای توقف «خونریزی توکن»، توسعهدهندگان میتوانند سیستمی چهارقاعدهای در TypeScript پیاده کنند که «نمای» (View) — یعنی برشی از لاگ که مدل در هر لحظه میخواند — را مدیریت کند، بدون اینکه «لاگ کامل» (Full Log) که منبع حقیقت (Ground Truth) است تغییر دهد. در این معماری، لاگ کامل دستنخورده باقی میماند و نما یک تصویر پویا و متغیر از آن است.
چهار قانون مدیریت نما
- سقف (Cap): نتایج حجیم ابزارها به یک پیشنمایش بههمراه یک ارجاع تبدیل میشوند.
- حفظ (Keep): خطوط مربوط به خطاها همیشه از حذف نجات مییابند و باقی میمانند.
- حذف تدریجی (Elide): نتایج قدیمی ابزارها به یک عبارت تکخطی (Stub) تبدیل میشوند.
- دور ریختن (Drop): وقتی اشغال پنجره از ۸۵٪ گذشت، قدیمیترین پیامهای کامل حذف میشوند.
در مرحله اول، سیستم سقفگذاری (Capping) را اجرا میکند. وقتی خروجی یک ابزار از یک حد آستانه (مثلاً ۱,۵۰۰ توکن) فراتر رود، سیستم متن کامل را به یک حافظه خارجی منتقل کرده و فقط یک پیشنمایش به مدل ارائه میدهد. یک نکته بسیار ظریف در اینجا منطق errorsFirst() است؛ سیستم به جای برش سادهی ابتدا و انتهای متن (Head-and-tail truncation) که فقط شروع و پایان لاگ را نگه میدارد، از Regex استفاده میکند تا هر خطی که شامل کلمات «FAIL» یا «ERROR» است را در پیشنمایش پین کند. این کار تضمین میکند که مدل آن یک خط حیاتی را که دلیل شکست تست را توضیح میدهد، گم نکند؛ چرا که خطاها به ندرت در ابتدای لاگ یا انتهای آن قرار دارند.
دوم، حذف تدریجی (Elision) است. وقتی نتیجه یک ابزار بیش از چند دور (مثلاً دو دور) قدیمی شود، با یک عبارت تکخطی جایگزین میشود. این عبارت شامل نام ابزار استفاده شده، شماره دور، تعداد توکنهای نتیجه اصلی و یک ارجاع به محل ذخیره متن کامل است (مثلاً offload://turn-2). با این روش، مدل میداند که دادهای وجود داشته است، اما دیگر در هر دور بابت انتقال آن هزینه نمیکند.
سوم، قانون حذف ۸۵٪ (85% Drop Rule) است. اگر مجموع «نما» همچنان بیش از ۸۵٪ پنجره زمینه را اشغال کرده باشد، سیستم قدیمیترین پیامهای کامل را حذف میکند. برای جلوگیری از اینکه عامل «عقلش را از دست بدهد»، پرامپت سیستمی، وظیفه اولیه و آخرین دورهای گفتگو «پین» شدهاند و هرگز حذف نمیشوند. این قانون به عنوان یک تور ایمنی عمل میکند، زمانی که سقفگذاری و حذف تدریجی کافی نباشند.
در نهایت، سیستم تضمین میکند که نما در هر فراخوانی مجدداً از روی لاگ اصلی بازسازی شود. این کار از «انحراف فشردهسازی» (Compaction Drift) جلوگیری میکند؛ وضعیتی که در آن خلاصهای از یک خلاصه، در نهایت دیگر با حقیقت مطابقت ندارد. با بازسازی از روی لاگ اصلی، هرگز یک عبارت تکخطی (Stub) از روی یک عبارت تکخطی دیگر ساخته نمیشود. قانون طلایی این است: برش بزن یا حذف کن، اما هرگز بازنویسی نکن.
محکهای عملکردی
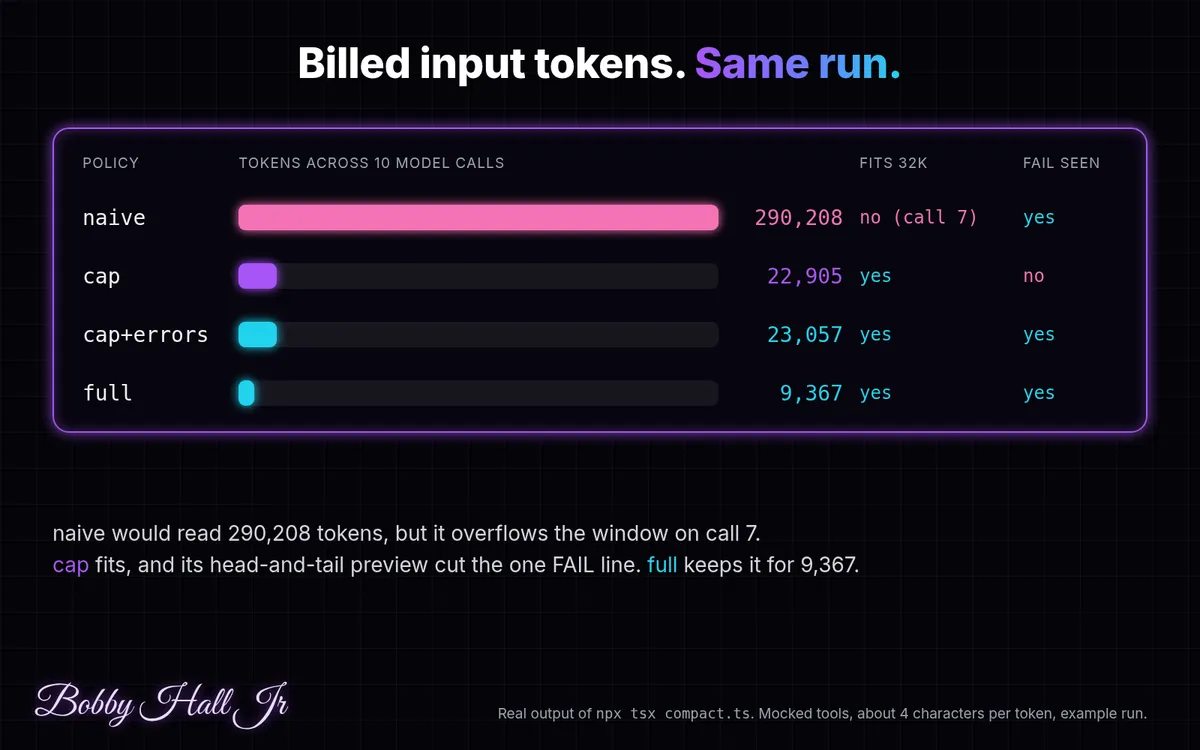
در یک اجرای اسکریپتشده برای یک عامل کدنویس که در حال رفع باگ یک تست پرداخت (Checkout Test) بود — شامل ۹ فراخوانی ابزار، دو لاگ تست ۱,۸۰۰ خطی و یک فایل CHANGELOG با ۹۰۰ خط — تفاوت بین رویکرد «ساده» و سیاست «فشردهسازی کامل» خیرهکننده است. در این شبیهسازی از یک معیار تقریبی (۴ کاراکتر برای هر توکن) استفاده شده است:
- سیاست ساده (Naive Policy): در ۱۰ فراخوانی، ۲۹۰,۲۰۸ توکن هزینه داشت و در فراخوانی هفتم به دلیل سرریز زمینه شکست خورد. این اتفاق دقیقاً زمانی رخ داد که خواندن فایل CHANGELOG روی اولین لاگ تست قرار گرفت و ظرفیت را پر کرد.
- سیاست سقفگذاری (Cap Policy): هزینه را به ۲۲,۹۰۵ توکن کاهش داد، اما چون از برش ساده ابتدا و انتها استفاده کرد، خط حیاتی «FAIL» را گم کرد. در فراخوانی بعدی، مدل نتوانست بفهمد چرا تست شکست خورده است.
- سقف + خطاها (Cap + Errors Policy): ۲۳,۰۵۷ توکن هزینه داشت (تنها ۱۵۲ توکن بیشتر از سقف ساده) و با موفقیت سیگنال شکست را حفظ کرد.
- سیاست کامل (سقف + خطاها + حذف تدریجی): هزینه را به تنها ۹,۳۶۷ توکن کاهش داد و بیشترین میزان استفاده از پنجره در لحظه را به ۱,۶۳۷ توکن رساند. در این اجرا، قانون حذف ۸۵٪ حتی نیاز به فعال شدن پیدا نکرد چون سقفگذاری و حذف تدریجی نما را کوچک نگه داشته بودند. این نتیجه دقیقاً با مطالعه هارنس همسو است: ابتدا قوانین ارزان، و در نهایت ابزارهای پیچیده به عنوان تور ایمنی.
موازنه و چالشهای فنی
اگرچه این قوانین در هزینهها صرفهجویی میکنند، اما چالشهای فنی جدیدی ایجاد میکنند. یکی از مسائل اصلی کش پرامپت (Prompt Caching) است. اکثر ارائهدهندگان، پیشوند تکراری درخواستها را کش میکنند. وقتی یک نتیجه به یک عبارت تکخطی تبدیل میشود، تمام توکنهای بعدی در پرامپت تغییر میکنند و این باعث میشود کش دوباره «گرم» شود. در بررسی ساختار Claude Code نیز مشاهده شد که چگونه ترکیب Prompt Caching و منطق مدیریت نشستها میتواند هزینههای عملیاتی را به شدت کاهش دهد. Strands هر دو قابلیت کش پرامپت و مدیریت زمینه را به صورت پیشفرض ارائه میدهد، اما این دو در تضاد با یکدیگرند. برای کاهش این اثر، حذف تدریجی باید در مرزهای پایدار رخ دهد، نه در هر دور ارتباطی.
همچنین ریسک دادههای «بازیابیپذیر در مقابل بازیابیشده» وجود دارد. در حالی که یک ابزار retrieve() میتواند دادههای حذف شده را از حافظه بازگرداند، مطالعه هارنس نشان داد که ساخت ابزاری برای بازیابی محتوای حذف شده، «پیچیدگیهایی را اضافه میکند که مدلها به ندرت از آن استفاده میکنند و هیچ افزایشی در دقت ایجاد نمیکند.» یک ارجاع تنها زمانی مفید است که مدل به فکر دنبال کردن آن بیفتد. سیگنال باید در همان پیشنمایش باشد، وگرنه مدل به سادگی شواهد را نادیده میگیرد.
موانع پیادهسازی
- محدودیت Regex: عبارت
FAIL|ERRORبرای برخی اجراکنندههای تست کار میکند، اما یک Stack Trace، یک هشدار که منجر به قطعی میشود، یا یک فیلد JSON به نامstatusبا این الگو مطابقت ندارد. هر ابزار نیاز به قانون پیشنمایش خاص خود دارد. - محدودیت API: APIهای چت واقعی انتظار دارند هر نتیجه ابزار بلافاصله پس از فراخوانی آن بیاید. حذف یک نتیجه بدون حذف فراخوانی مربوطه میتواند باعث شکست درخواست شود.
- تخمین توکن: شمارندههای ساده (مثل ۴ کاراکتر برای هر توکن) تنها تخمین هستند. توسعهدهندگان باید پیش از اعتماد به یک حد آستانه، از توکنسازهای (Tokenizers) اختصاصی هر ارائهدهنده استفاده کنند.
- انحراف خلاصهسازی: خلاصهسازی توسط LLM در فشردهسازی سختگیرانه avoided میشود، زیرا خلاصهای از یک خلاصه به مرور زمان حقیقت را تغییر میدهد. به همین دلیل است که CliffCompaction بازنویسی را ممنوع کرده است.
تحلیل: هارنس به عنوان محصول
این تغییر نشان میدهد که «هارنس» — یعنی نرمافزاری که دور مدل زبانی است — به اندازه خود مدل اهمیت یافته است. دو عامل که از یک مدل GPT-4o استفاده میکنند، بر اساس سیاست فشردهسازیشان رفتارهای کاملاً متفاوتی دارند. عاملی که «ارزان» است چون خطای تست را فراموش کرده، در واقع کارآمد نیست؛ بلکه فقط با تخفیف اشتباه میکند.
برای توسعهدهندگان، این بدان معناست که پنجره زمینه باید مانند یک بودجه سختگیرانه مدیریت شود. هدف این است که بودجه روی شواهد (خطوط خاص کد یا لاگهایی که اهمیت دارند) هزینه شود، نه روی نویز یک لاگ ۱,۸۰۰ خطی که همه چیز در آن PASS شده است. صنعت از رویکرد «پنجرههای بزرگتر» به سمت «فیلترهای هوشمندتر» حرکت میکند.
اگر در حال ساخت گردشکارهای عاملمحور هستید، هزینه توکنهای فعلی خود را ارزیابی کنید. اگر هزینههای شما با افزایش تعداد دورها به صورت خطی رشد میکند، احتمالاً دارید بابت دادههای تکراری چندین بار پول میپردازید. پیادهسازی یک فشردهساز قاعدهمند، فوریترین راه برای جداسازی پیچیدگی عامل از هزینه استنتاج است.
در آینده منتظر ادغام این قوانین فشردهسازی مستقیماً در APIهای مدلها باشید، که میتواند مدیریت «نما» را خودکار کرده و کش پرامپت را در سطح ارائهدهنده بهینه کند.



گفتگو