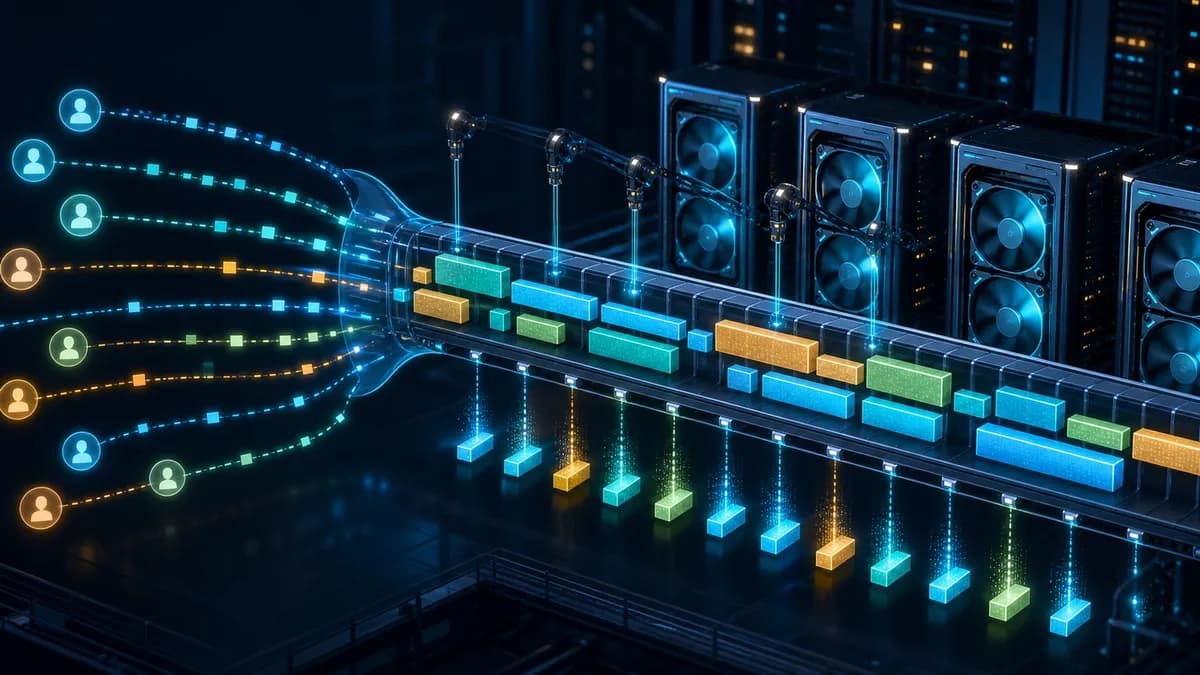
اگر امروز یک سرویس هوش مصنوعی را مدیریت میکنید، احتمالاً با این واقعیت تلخ روبهرو هستید که یک پاسخ طولانی میتواند تمام صف پردازش شما را متوقف کند. اینجاست که دستهبندی پیوسته (Continuous Batching) وارد میشود تا از اتلاف منابع گرانقیمت GPU جلوگیری کند. سروری که از دستهبندی پیوسته استفاده میکند، میتواند یک پاسخ کوتاه تمامشده را بلافاصله با یک درخواست منتظر جایگزین کند، در حالی که تولید پاسخهای طولانیتر همچنان ادامه دارد. این تغییر عملیاتی تضمین میکند که شتابدهندههای هوش مصنوعی همیشه مشغول باشند؛ چرا که درخواستهای استنتاج را به جای انتظار برای یک دستهی ایستا و کامل، به صورت تکتک و به محض پایان هر توالی، وارد یا خارج میکند. این رویکرد مستقیماً ناکارآمدی دستهبندی ایستا (Static Batching) را هدف قرار میدهد.
اکثر سیستمهای استنتاج هوش مصنوعی امروزه با مشکل «کندترین درخواست» دستوپنجه نرم میکنند. در یک دستهی ایستا، سیستم باید منتظر بماند تا طولانیترین توالی به پایان برسد تا بتواند کارهای جدید را بپذیرد. این وضعیت یک گلوگاه ایجاد میکند که در آن درخواستهای سریع، گروگانِ درخواستهای کند میشوند و در نتیجه چرخههای محاسباتی هدر رفته و زمان انتظار برای کاربر نهایی افزایش مییابد.
به نقل از راهنمای فنی unite.ai که در سال ۲۰۲۴ منتشر شد، ارزش اصلی دستهبندی پیوسته تنها در «سرعت بیشتر هوش مصنوعی» نیست، بلکه در یک تغییر مشخص در نحوه جریان دادهها در سیستم است. این روش، رفتار آموختهشدهی مدل را از تصمیمات زمانبندی محصول جدا میکند. این جداسازی به اپراتورها اجازه میدهد تا تأخیر (Latency) و عدالت در توزیع منابع را بدون تغییر در وزنهای مدل مدیریت کنند.
مرزهای عملیاتی و سیستمی
عملکرد استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند و شبیه به خودِ آشپزی است، نه دورهی آموزش آشپز — یک ویژگی سیستمی است. این عملکرد طیف گستردهای از موارد را در بر میگیرد: از معماری مدل و دقت عددی گرفته تا جابهجایی حافظه، زمانبندی، شبکهسازی، سختافزار و شکل توزیع حجم کاری (Workload Shape). در دستهبندی پیوسته، این دیدگاه سیستمی حیاتی است؛ زیرا عملکرد میتواند توسط دادههای محیطی، رابطها، سختافزار، مجوزها و حتی افراد تعیین شود، حتی زمانی که مدل زیربنایی هیچ تغییری نکرده باشد. این پیچیدگیها در واقع بخشی از چرخهٔ ۷ مرحلهای استقرار هوش مصنوعی هستند که مسیر تبدیل دادههای خام به یک محصول عملیاتی را ترسیم میکنند.
دستهبندی پیوسته توسط سه تعهد عملی تعریف میشود: یک ورودی قابل شناسایی، یک ویژگی تبدیل یا تصمیم که مشخصهی این مکانیزم است، و یک نتیجه که بتوان آن را در برابر یک هدف اعلامشده ارزیابی کرد. اگر هر یک از این عناصر غایب باشد، برچسب «دستهبندی پیوسته» بیشتر توصیف یک آرزو است تا یک مکانیزم پیادهسازی شده.
این تفکیک اکنون حیاتی است زیرا سیستمهای هوش مصنوعی اکنون با زمینههای (Contexts) بزرگتر، مودالیتههای بیشتر، محاسبات زمان اجرای بیشتر و ارتباطات عمیقتر با تصمیمات سازمانی مواجه هستند. آنچه زمانی یک جزئیات پژوهشی به نظر میرسید، اکنون تعیینکنندهی تأخیر، امنیت، دسترسیپذیری، هزینههای محیطی، کیفیت محصول یا مسئولیتهای قانونی است.
مرزهای عملیاتی
مرز دستهبندی پیوسته بیشتر عملیاتی است تا اصطلاحی. تلقی کردن آن به عنوان مترادفی برای «هوش مصنوعی پیشرفته»، ادعاها را غیرقابل آزمایش میکند. یک توضیح دقیق مورد نیاز است زیرا این نام، یک جریان اطلاعاتی خاص، یک انتخاب در آموزش، یک مکانیزم زمان اجرا یا یک مرز حاکمیتی را شناسایی میکند.
هنگام مقایسه سیستمها، واحد تحلیل اهمیت دارد. یک مقاله پژوهشی ممکن است یک مدل یا الگوریتم را ایزوله کند، اما یک سرویس مستقر (Deployed)، لایههایی از بازیابی (Retrieval)، مسیریابی (Routing)، حافظه پنهان (Caching)، سیاستها، شناسایی، رابطهای کاربری و مانیتورینگ را اضافه میکند. دو محصول میتوانند از یک اصطلاح کلی استفاده کنند در حالی که بخشهای متفاوتی از این پشته (Stack) را پیادهسازی کردهاند. اپراتورها باید بپرسند کدام جزء تبدیل تعریفکننده را انجام میدهد و کدام اجزای دیگر برای رسیدن به نتیجه گزارششده ضروری هستند. در واقع، درک این لایهها به ما کمک میکند تا پیوند ریاضیات مدلها با هزینههای استقرار را بهتر درک کنیم و بدانیم هر تغییر در معماری چگونه بر بودجه عملیاتی اثر میگذارد.
نقشهی عملیاتی پنجمرحلهای
دستهبندی پیوسته ورودی را از طریق پنج عملیات مشاهدهپذیر به نتیجه تبدیل میکند. این نقشه به عنوان یک نقشه علی (Causal Map) عمل میکند؛ اگرچه برخی سیستمها مراحل را ترکیب کرده یا در یک حلقه تکرار میکنند، اما این نقشه اجبار میکند که هر تغییر در اطلاعات یا اختیار، یک مالک، یک ورودی، یک خروجی و یک تست داشته باشد.
۱. صفبندی درخواستها و ردیابی وضعیت توالی: سیستم درخواستهای ورودی را صف میکند و وضعیت هر توالی را میپاید. سؤال حیاتی در اینجا این است که چه اطلاعاتی مصرف میشود و چه شواهدی ثابت میکند که تغییر معتبر بوده است. این مرحله باید با نتیجهای پایان یابد که از تشکیل گروه اولیه توکنهای فعال پشتیبانی کند. تیمها باید عدم قطعیتها، جایگزینهای رد شده و میزان مصرف منابع را در این مرز ثبت کنند تا تشخیص دهند آیا بهرهبرداری تهاجمی باعث افزایش تأخیر انتهایی (Tail Latency) میشود یا خیر.
۲. تشکیل گروه اولیه از توکنهای فعال: سیستم گروهی از توکنها (Tokens) — تکههای کوچکی از متن که شبیه برشهای یک کیک طولانی هستند و مدل آنها را تکهتکه میخورد — را برای پردازش انتخاب میکند. این اولین نقطهای است که سیستم از دستهبندی ایستا فاصله میگیرد و خود را برای ورود و خروج پویا آماده میکند. این مرحله با وضعیت صفبندی شده شروع شده و با نتیجهای پایان مییابد که پیشبرد هر توالی را برای یک گام رمزگشایی ممکن میسازد. بازبینها باید بتوانند این مرحله را از دستهبندی ایستا تشخیص دهند و نتیجه را تحت همان شرایط اعلامشده بازتولید کنند.
۳. پیشبرد هر توالی برای یک گام رمزگشایی: هر توالی فعال یک توکن جلو میرود. این همان تبدیل متمایزی است که در آن استنتاج واقعی رخ میدهد. یک بازبین باید بتواند این مرحله را از دستهبندی ایستا تشخیص داده و نتیجه را بازتولید کند. تحویل به این مرحله با گروه اولیه توکنها شروع شده و با نتیجهای پایان مییابد که حذف توالیهای تکمیلشده یا متوقفشده را پشتیبانی کند.
۴. حذف توالیهای تکمیلشده یا متوقفشده: به محض اینکه یک توالی به توکن توقف (Stop Token) برسد یا متوقف شود، بلافاصله از دسته بیرون انداخته میشود. این کار یک جایگاه (Slot) را در شتابدهنده آزاد میکند. این مرحله به عنوان یک مرز محدودکننده و تأییدکننده عمل میکند و با نتیجهای پایان مییابد که پر کردن ظرفیت آزاد شده را ممکن میسازد.
۵. پر کردن ظرفیت آزاد با کارهای منتظر: سیستم بلافاصله یک درخواست جدید را از صف میکشد تا جای خالی را پر کند. این حلقه تکرار میشود تا سختافزار در اوج بهرهوری بماند. این مرحله نهایی از مانیتورینگ یا یک تصمیم نهایی پشتیبانی میکند. تحویل در این مرحله با حذف توالیها شروع شده و با نتیجهای پایان مییابد که یک تصمیم نهایی یا نظارت را پشتیبانی کند.
تحلیل و تشخیص خطا
این نقشهی پنجمرحلهای را میتوان در دو جهت خواند:
- تحلیل رو به جلو: برای درک تولید محصول به کار میرود و میپرسد که چگونه یک مرحله، مرحله بعدی را تغذیه میکند.
- تحلیل رو به عقب: برای تشخیص شکست به کار میرود. این تحلیل از یک نتیجه نادرست، کند، گران یا ناامن شروع شده و به عقب بازمیگردد تا ببیند کدام فرض اولیه اجازه وقوع این خطا را داده است. اغلب، خطای تعیینکننده پیش از آنکه مدل چیزی تولید کند، رخ میدهد.
دستهبندی پیوسته در برابر ایستا
صنعت اغلب دستهبندی پیوسته را با دستهبندی ایستای «پیشرفته» اشتباه میگیرد، اما تفاوت آنها عملیاتی است نه اصطلاحی. دستهبندی ایستا کندترین درخواست را پیش از پذیرش کارهای جدید به پایان میرساند، که این امر داستان علیِ موفقیت و هزینه را تغییر میدهد.
- دستهبندی پیوسته تعریفشده: یک تبدیل پویا و یک نتیجه قابل اندازهگیری را حفظ میکند. تمرکز آن بر مشغول نگه داشتن جایگاههای شتابدهنده است و از یک تبدیل هستهای برای دستیابی به نتیجهای اندازهگیری شده استفاده میکند.
- میانبر ایستا (Static Shortcut): مرز اصلی ورود پویا را نادیده میگیرد. این کاهش میتواند منجر شود خریداران محصولات نامتجانس را با هم مقایسه کنند، پژوهشگران نتایج آزمایشات را بیش از حد بیان کنند و اپراتورها پس از استقرار، سیگنالهای غلط را رصد کنند. در این میانبر، بهرهبرداری تهاجمی میتواند بدون وجود مرزهای مناسب، تأخیر انتهایی را افزایش دهد.
ریسکها و حالتهای شکست
«بهرهبرداری تهاجمی» ریسک اصلی این تکنیک است. اگرچه توان عملیاتی (Throughput) را افزایش میدهد، اما میتواند تأخیر انتهایی (Tail Latency) — یعنی تأخیری که درصد کمی از کندترین کاربران تجربه میکنند — را افزایش دهد. همچنین میتواند عدالت را پیچیده کند، زیرا سیستم ممکن است برخی شکلهای درخواست را بر برخی دیگر اولویت دهد. این شکست یک اتفاق جانبی نیست؛ بلکه باید از ابتدا بر جمعآوری دادهها، معماری، مجوزها، ارزیابی، گیتهای انتشار و مانیتورینگ تأثیر بگذارد.
برای جلوگیری از این شکستها، اپراتورها باید کنترلها را به ترتیب زیر اجرا کنند:
- ۰۱ پروفایل کردن درخواست
- ۰۲ زمانبندی محاسبات
- ۰۳ ارائه نتیجه
- ۰۴ اندازهگیری تأخیر انتهایی
- ۰۵ کنترل هزینه
یک کنترل مفید باید پیش از وقوع یک پیامد برگشتناپذیر عمل کند. اولین پیشنشان مشاهدهپذیر شکست را شناسایی کنید، یک آستانه یا قانون تعیین کنید، یک مالک مسئول مشخص کنید و بازیابی را تست کنید. بازیابی ممکن است شامل خودداری از پاسخ، بازگشت به یک سیستم سادهتر، درخواست شواهد بیشتر، ارجاع به انسان، بازگرداندن (Rollback) مدل یا توقف کامل یک اقدام باشد.
ارزیابی و پیادهسازی
ارزیابی دستهبندی پیوسته به چیزی بیش از یک دموی صیقلخورده نیاز دارد. یک تست سختگیرانه باید شامل موارد عادی، دشوار و عمداً گمراهکننده باشد. تیمها باید یک خط مبنا (Baseline) بدون این تکنیک حفظ کنند و هم عملکرد متوسط و هم شدت شکستهای فردی را ثبت کنند. اگر مکانیزمی تنها در یک نمایش Carefully arranged موفق شود، ثابت نکرده است که در محیط عملیاتی تعمیم مییابد.
محکهای کلیدی برای بنچمارک:
- زمان تا نخستین نتیجه (Time to First Result)
- سرعت حالت پایدار (Steady-state Speed)
- تأخیر انتهایی و توان عملیاتی
- کیفیت و میزان بهرهبرداری
- هزینه به ازای هر نتیجه مفید
تیمها باید توزیعها، دستههای شکست و زیرگروههای متأثر را گزارش کنند، به جای اینکه نتایج را در یک میانگین فشرده کنند. توزیع واقعی درخواستها را تحت همزمانی (Concurrency) واقعبینانه بنچمارک کنید. برای تضمین بازتولیدپذیری، باید نسخههای ورودیهای زیر را ثبت کنند:
- دادههای منبع و پیشپردازش
- توکنساز یا رمزگذار (Tokenizer/Encoder)
- وزنهای مدل و پیکربندی
- پرامپت یا سیاست (Prompt/Policy)
- اندیس بازیابی (Retrieval Index)
- مجموعه ارزیابی
- فرضهای سختافزاری و کد سرویسدهی
بدون این تبار (Lineage)، یک تیم نمیتواند تشخیص دهد که آیا تغییر در نتیجه ناشی از تکنیک است، محیط است یا یک ویرایش متوجهنشده در خط لوله. در نهایت، تیمها باید بپرسند چه یافتهای میتواند این ادعا را که دستهبندی پیوسته کمک میکند، رد کند. اگر هیچ نتیجهای نتواند تصمیم پذیرش را تغییر دهد، آن ارزیابی در واقع «بازاریابی» است.
پذیرش و مطالعه
پیش از پذیرش دستهبندی پیوسته، تیمها باید بپرسند:
- هدف: کدام گلوگاه اندازهگیری شده قرار است با این روش حل شود؟
- مکانیزم: کدام یک از پنج مرحله حاوی تبدیل متمایز است؟
- خط مبنا: این روش در مقایسه با دستهبندی ایستایی که کندترین درخواست را تمام میکند یا هر جایگزین سادهتر دیگر، چگونه است؟
- شواهد: کدام موارد عادی، دشوار، متخاصم (Adversarial) و زیرگروهها تست شدهاند؟
- عملیات: چه هزینههای تأخیر، حافظه، محاسبات، انرژی، نگهداری و بازبینی در مقیاس بالا ظاهر میشوند؟
- ریسک: تیم چگونه تشخیص میدهد که بهرهبرداری تهاجمی باعث افزایش تأخیر انتهایی یا پیچیدگی عدالت میشود؟
- بازیابی: آیا سیستم میتواند پیش از وقوع آسیب، خودداری کند، به حالت سادهتر بازگردد، رولبک کند یا ارجاع دهد؟
برای کسانی که این سیستمها را پیادهسازی میکنند، مطالعه منابع اولیه زیر توصیه میشود:
- مقاله FlashAttention: برای بهینهسازیهای بنیادی مکانیزم توجه.
- vLLM و PagedAttention: برای مدیریت بهینه حافظه.
- پژوهشهای رمزگشایی گمانهزنانه (Speculative Decoding): برای افزایشهای پیشرفته در سرعت استنتاج.
اینها باید در کنار مستندات دقیق مدل، مجموعه داده، سختافزار و حوزه قضایی مربوطه خوانده شوند. یک منبع کلی میتواند مکانیزم را تعریف کند، اما تنها شواهد خاصِ استقرار است که مناسب بودن را ثابت میکند.
خلاصه ارزش
این تغییر در مدیریت استنتاج به این معناست که آنچه زمانی یک جزئیات پژوهشی بود، اکنون تعیینکننده هزینه محیطی، امنیت و مسئولیت قانونی یک سرویس هوش مصنوعی است. هدف این نیست که مدل را «باهوشتر» کنیم — که یک معیار پذیرش نیست — بلکه هدف بهبود نتایجی مانند نرخ خطا در موارد سخت، بازیابی پس از شواهد متناقض، یا هزینه در یک صدک خاص از ترافیک است.
دستهبندی پیوسته یک مکانیزم تعریفشده در یک سیستم اجتماعی-فنی بزرگتر است. ارزش آن از بهبود یک نتیجه خاص تحت شرایط صریح میآید. قانون عملی این است: هدف را تعریف کنید، با یک خط مبنای معتبر مقایسه کنید، شکستی را که بیشترین اهمیت را دارد تست کنید و شواهد لازم برای نظارت بر تغییرات را حفظ کنید.
گام بعدی شما
- اگر از vLLM استفاده میکنید، توزیع تأخیر (Latency Distribution) را بهجای میانگین بررسی کنید تا اثر Tail Latency را ببینید.
- در محیطهای تست، درخواستهای بسیار کوتاه را در کنار درخواستهای بسیار طولانی قرار دهید تا کارایی جایگزینی پویا را محک بزنید.
- هزینهی هر توکن را در حالت دستهبندی ایستا و پیوسته مقایسه کنید تا نرخ بازگشت سرمایه (ROI) سختافزاری را محاسبه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو